
架构与系统设计 / 系统课时
演练区域故障与数据回切
演练区域故障与数据回切
区域级故障演练的目标不是证明“能切过去”,而是证明切流后仍满足数据安全边界,并且故障区域恢复后能以可控方式追平、校验并重新加入。本文给出一套可执行的演练顺序、观测点和回切门槛。
学习目标
- 设计覆盖故障注入、切流、数据追平和回切的区域级演练
- 用 RPO、复制延迟和一致性校验判断是否具备回切条件
- 识别旧区域重新加入时最危险的双写、脏数据和流量抖动问题
先定义演练边界与成功条件
区域故障演练必须先写清“允许损失什么”和“什么算恢复成功”。如果没有量化门槛,团队很容易把“备用区域能响应请求”误判为演练成功。
建议至少定义四类验收条件:业务可用性、数据恢复点、数据恢复时间和重新加入安全性。RPO 用来限制最多可接受的数据缺口,RTO 用来限制从故障发生到核心服务恢复的最长时间;同时还要约束复制延迟、错误率和关键数据校验差异。
例如,演练前可约定:切流后核心接口在 <TIME> 内恢复,写入错误率不高于目标阈值;备用区域承接写流量后,旧区域必须保持只读或完全隔离;回切前复制延迟归零或低于允许阈值,并完成关键表或关键对象的数量与校验和比对。
按顺序执行故障、切流与恢复
一次完整演练通常会同时涉及全局流量入口、两个区域、复制链路和客户端重试。下图把关键控制点放在一条时间线上,避免只关注 DNS 或负载均衡切换而忽略数据状态。
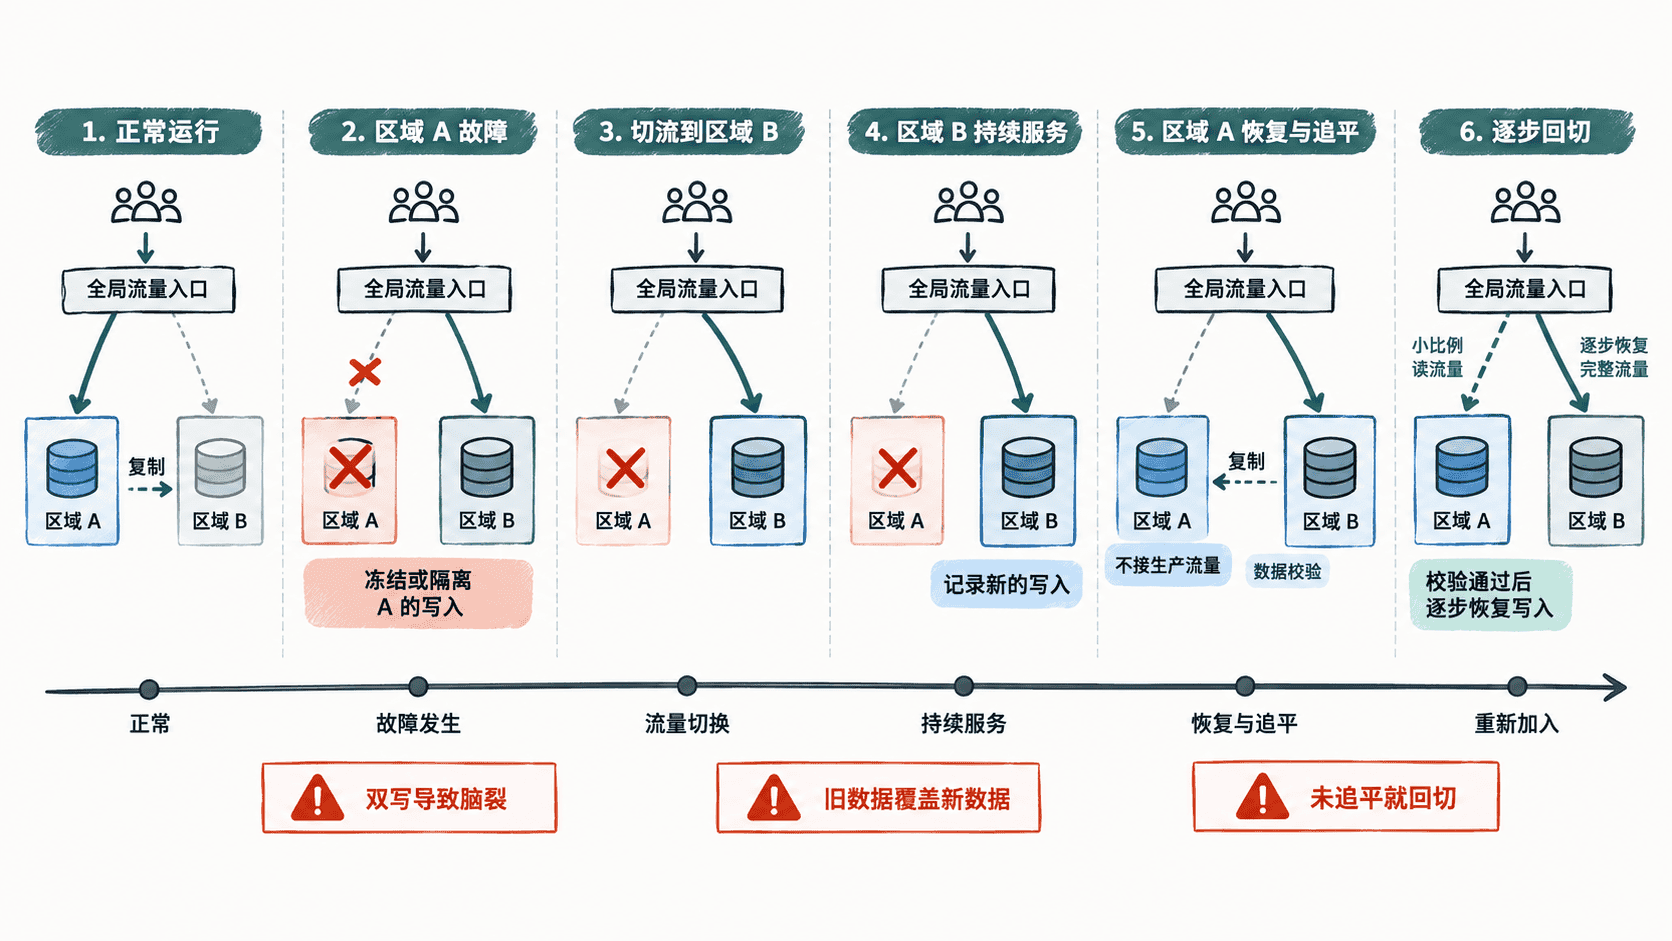
推荐执行顺序如下:
- 记录演练开始时间、主区域和备用区域当前健康状态,确认复制链路无积压。
- 故障注入前停止所有自动故障恢复策略中可能与人工演练冲突的动作,避免自动化与人工同时改写流量。
- 注入区域故障,确认监控确实观察到不可用,而不是只在控制面“标记故障”。
- 隔离旧区域写入后,再把入口流量切到备用区域;客户端应通过重试或重新解析逐步收敛。
- 在备用区域持续写入一批带唯一演练标记的数据,用于后续追平校验。
- 恢复旧区域基础设施,但不要立即让它承接生产流量;先恢复复制、等待追平并校验数据。
- 先恢复少量读流量,观察错误率、延迟和数据一致性,再逐步扩大比例;只有架构明确支持双活写入时,才恢复写流量。
把重新加入条件固化成门禁
恢复阶段最危险的动作,是在数据尚未追平时把旧区域重新挂回流量入口。可以先把门槛写成可执行检查,再把脚本中的观测值替换为监控或数据库实际采集结果。
from dataclasses import dataclass

@dataclass
class RecoveryState:
    replication_lag_seconds: int
    checksum_mismatches: int
    old_region_writable: bool
    error_rate: float

def can_rejoin(state: RecoveryState) -> tuple[bool, list[str]]:
    # 重新加入必须同时满足数据、写权限和请求健康门槛。
    reasons: list[str] = []

    if state.replication_lag_seconds > 5:
        reasons.append("replication lag is above 5 seconds")
    if state.checksum_mismatches != 0:
        reasons.append("data checksum mismatch exists")
    if state.old_region_writable:
        reasons.append("old region is still writable")
    if state.error_rate > 0.01:
        reasons.append("error rate is above 1%")

    # 任一条件失败都拒绝重新加入,避免把多项风险压成单一健康值。
    return not reasons, reasons

# 示例状态代表旧区域已追平且仍保持只读。
state = RecoveryState(
    replication_lag_seconds=2,
    checksum_mismatches=0,
    old_region_writable=False,
    error_rate=0.003,
)

allowed, reasons = can_rejoin(state)
print(f"rejoin_allowed={str(allowed).lower()}")
print("reasons=" + (", ".join(reasons) if reasons else "none"))
预期输出
rejoin_allowed=true
reasons=none
这个示例只表达门禁逻辑,不替代真实数据源。生产演练中应从复制状态、校验任务、写权限控制和请求监控中取得对应值,并把阈值替换成系统自己的 SLO 与 RPO 约束。
数据追平后再讨论回切
旧区域恢复时最大的风险不是它“起不来”,而是它带着旧数据重新进入集群。回切前至少检查复制位点、积压量、关键业务对象和版本方向。
先确认复制方向没有反转。故障期间备用区域已经产生更新,因此旧区域必须从新的权威区域补齐数据;若恢复脚本仍按故障前方向同步,就可能用旧值覆盖新值。然后检查复制延迟是否稳定下降,而不是偶尔归零后再次增长。
对关键数据做两层校验:第一层比较总量、最大版本号、最近更新时间等轻量指标;第二层对演练窗口内的数据做主键级或校验和比对。若存在异步索引、缓存或搜索系统,还要单独确认它们是否已经重建,因为数据库追平不代表所有派生状态都一致。
让旧区域分阶段重新加入
安全的重新加入应该是单向、渐进、可撤销的。先让旧区域成为不接流量的追随者,确认追平;再开放少量读流量,验证本地缓存、连接池、依赖服务和数据一致性;最后才恢复完整流量。
如果系统是单写架构,回切写主区域前要再次冻结写入或使用明确的主从切换协议,保证任何时刻只有一个区域拥有写权限。若系统是双活架构,则必须验证冲突解决、幂等键和全局唯一性机制,而不能沿用单写系统的回切流程。
演练结束后保留完整时间线:故障注入时刻、检测时刻、切流开始与完成、复制恢复、追平完成、首次读流量回归和最终回切。用这些时间点计算真实 RTO,并把每个异常对应到下一次演练要修正的自动化或门槛。只有当切流、追平、校验和重新加入都能重复通过,区域级高可用才算具备可验证的恢复能力。