
架构与系统设计 / 系统课时
用Deadline约束整条调用链
用Deadline约束整条调用链
一次请求经过网关、服务和下游依赖时,如果每一层都重新获得一份完整超时时间,用户早已放弃后,后端仍可能继续连接、读取和计算。Deadline 的目标是把一个绝对截止时刻沿调用链传播,让所有阶段共同消费同一份预算。
学习目标
- 区分“每层独立 Timeout”和“整链路 Deadline”的语义差异
- 会让剩余时间沿调用链传播,并让局部超时服从全局截止时间
- 能识别预算耗尽后仍继续工作的无效请求
为什么每层 Timeout 会把请求拖长
假设入口允许请求最多执行 900 ms。服务 A 调用 B 时若重新配置 900 ms,B 调用 C 时又重新获得 900 ms,理论总耗时就可能远超入口预算。更糟的是,入口连接已经断开,下游仍在做数据库查询、RPC 或计算,浪费连接池、线程和 CPU。
Deadline 表示一个绝对时间点,例如“本请求最晚在 <TIME> 结束”。每到下一层都只计算“现在距离截止时刻还剩多少时间”,而不是重新发放完整预算。
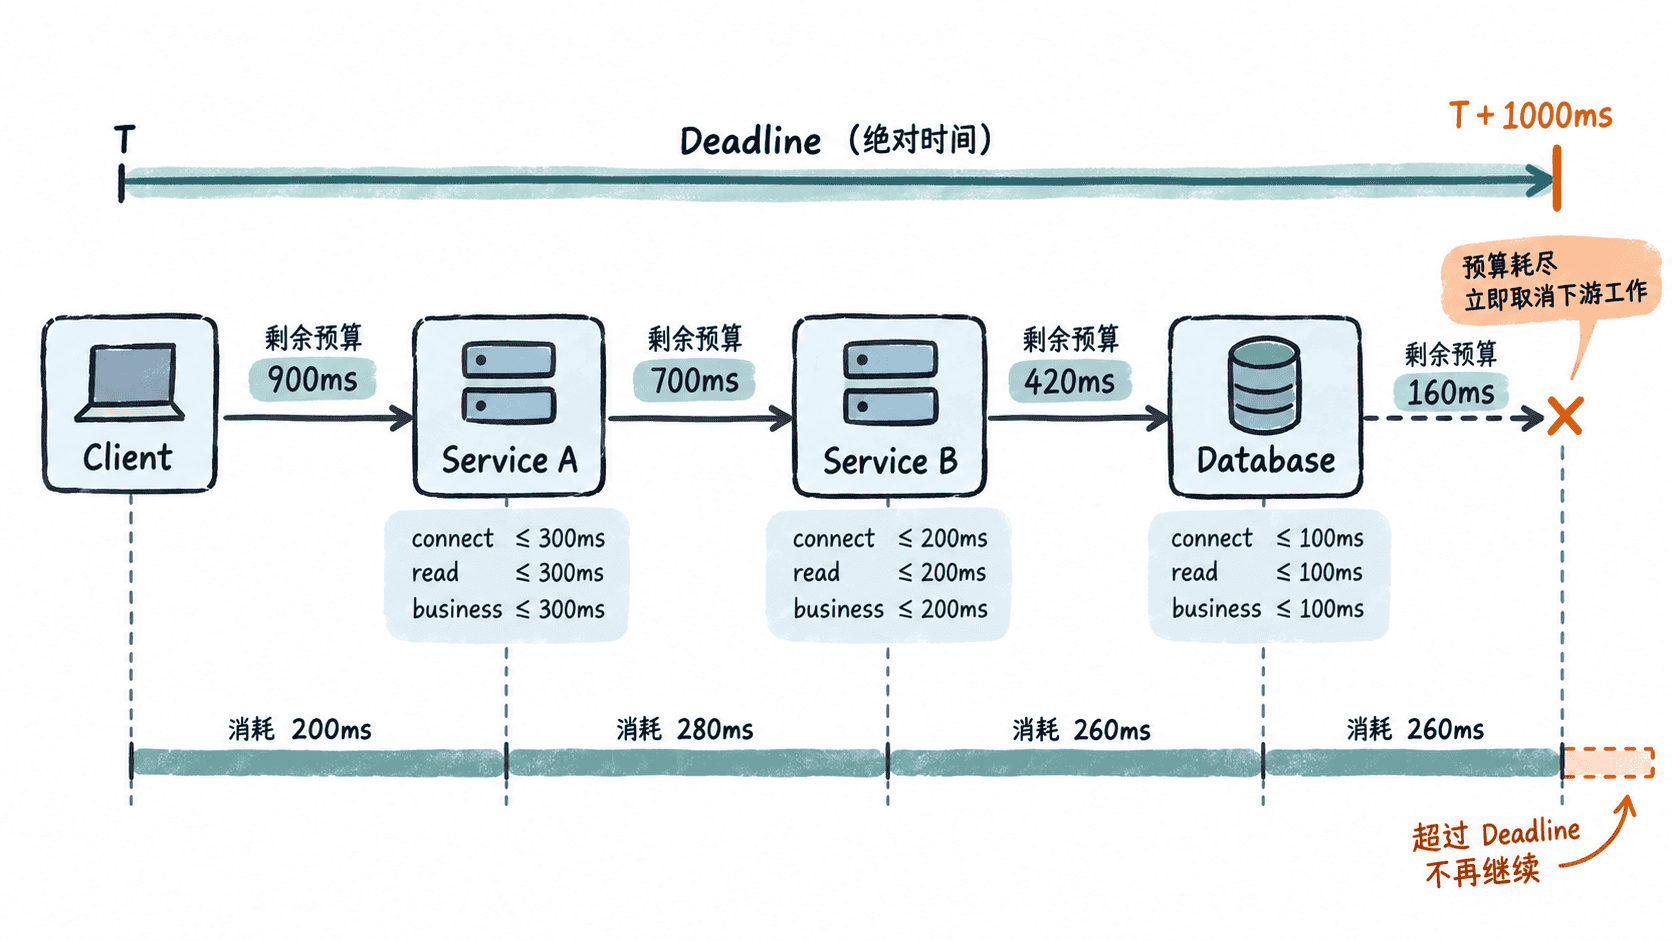
在代码里传播同一个截止时间
下面的 Go 程序用一个父 context 代表整条请求链。每个阶段可以设置自己的局部上限,但局部 context 仍继承父 Deadline,因此不会把整链路预算重置。
package main

import (
    "context"
    "fmt"
    "time"
)

type stage struct {
    name       string
    work       time.Duration
    localLimit time.Duration
}

func runStage(parent context.Context, s stage) error {
    ctx, cancel := context.WithTimeout(parent, s.localLimit)
    defer cancel()

    timer := time.NewTimer(s.work)
    defer timer.Stop()

    select {
    case <-timer.C:
        return nil
    case <-ctx.Done():
        return ctx.Err()
    }
}

func main() {
    requestCtx, cancel := context.WithTimeout(context.Background(), 900*time.Millisecond)
    defer cancel()

    stages := []stage{
        {name: "connect", work: 150 * time.Millisecond, localLimit: 400 * time.Millisecond},
        {name: "read", work: 300 * time.Millisecond, localLimit: 500 * time.Millisecond},
        {name: "business", work: 600 * time.Millisecond, localLimit: 800 * time.Millisecond},
    }

    for _, s := range stages {
        if err := runStage(requestCtx, s); err != nil {
            fmt.Printf("%s: %v\n", s.name, err)
            return
        }
        fmt.Printf("%s: ok\n", s.name)
    }
}
预期输出
connect: ok
read: ok
business: context deadline exceeded
前两个阶段已消耗约 450 ms,业务阶段虽然允许最多 800 ms,但父 Deadline 只剩约 450 ms,因此会先被整链路截止时间取消。实际调度会有少量时间误差,但取消位置不变。
给不同阶段分配预算
全局 Deadline 不等于所有局部操作都只能等待到最后一刻。连接、读取、数据库查询仍应有更短的局部上限,用来更早暴露单点迟缓。常见约束是:局部超时不超过当前剩余预算,并为返回结果和序列化预留尾部时间。
例如入口预算为 800 ms,可以计划连接 100 ms、读取 250 ms、业务 350 ms,并保留约 100 ms 作为调度和返回余量。真正执行时仍以全局 Deadline 为硬上限,任何阶段都不能通过“重新创建一个完整 Timeout”突破它。
跨服务传播时保留绝对截止语义
RPC 框架如果原生支持 Deadline,应优先使用框架的上下文传播。若通过 HTTP 头自行传递,传绝对截止时刻通常比传“还剩 300 ms”更稳妥,因为每一跳都能基于本地当前时间重新计算剩余预算。
收到请求后先检查 Deadline 是否已经过期;若剩余时间不足以完成最小工作单元,应快速失败,而不是继续访问下游。这样做能把“超时”从某个客户端参数,变成整条调用链共同遵守的资源边界。