
架构与系统设计 / 系统课时
按访问模式选择稳定分片键
按访问模式选择稳定分片键
分片键一旦进入数据布局,就会影响查询路由、写入均衡、跨分片事务和后续扩容。本篇用访问路径反推分片键,判断租户、用户与时间三类常见方案的收益与长期代价,最终得到能持续演进的选择方法。
学习目标
- 根据高频查询路径判断请求能否被精确路由到单个分片。
- 同时评估写入分布、热点、跨分片关联和扩容成本。
- 识别租户、用户、时间分片在业务增长后的典型风险。
先从访问路径反推分片键
选择分片键时,第一问题不是“哪个字段分布最均匀”,而是“最重要的请求拿着什么条件进来”。理想情况是高频查询天然携带分片键,路由层可以直接确定目标分片,而不是向所有分片广播查询。
例如订单系统最常见的入口如果是“查询某个用户的订单”,user_id 比 order_id 更适合作为候选分片键,因为列表查询天然携带用户标识。反过来,如果绝大多数请求都通过订单号读取单笔订单,按用户分片就需要额外维护 order_id -> shard 的路由索引。
可以按下面的顺序检查候选字段:先列出最高频、延迟最敏感的查询条件,再判断它们是否包含候选键;接着检查写请求是否也能在写入前得到该键;最后再观察需要一起修改或关联的数据能否落在同一分片。
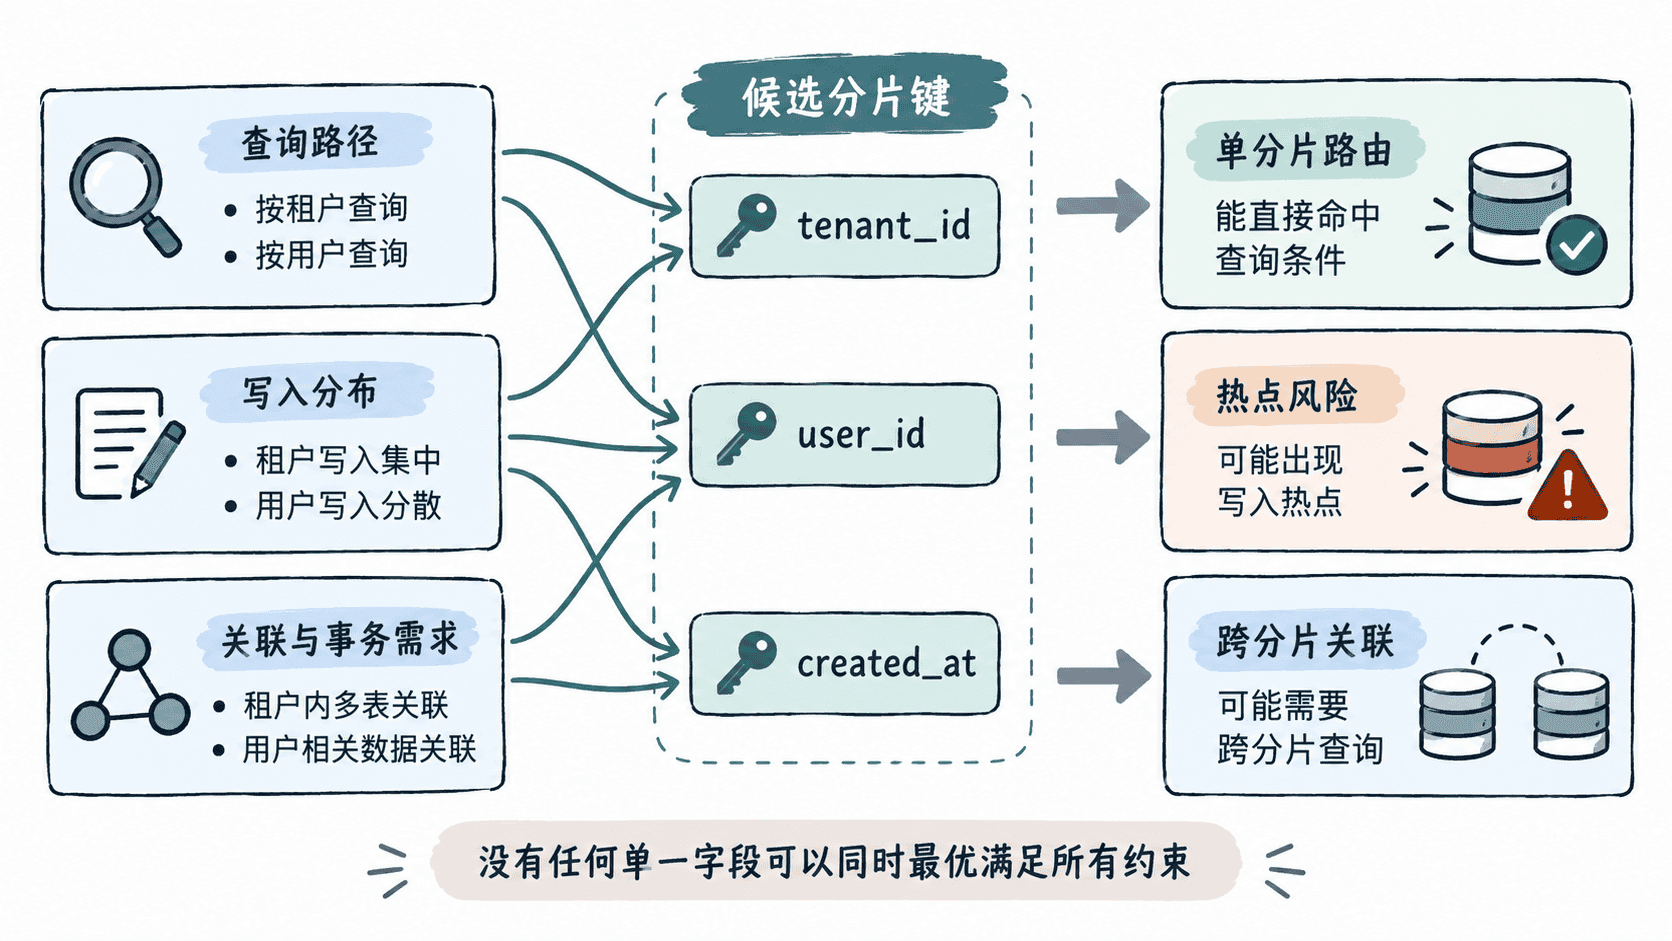
同时检查均衡性和局部性
好的分片键需要在“均衡”与“局部性”之间取得平衡。均衡意味着大量写入不会持续落到少数分片;局部性意味着经常一起读取、修改的数据尽可能位于同一分片。
只看基数容易误判。tenant_id 即使有几十万个不同值,只要其中一个大型租户贡献了 40% 的流量,按租户分片仍然可能形成单分片热点。user_id 通常分布更细,但如果业务存在超级账号或机器人账号,同样需要检查实际流量而不是只看用户数量。
判断候选键时至少观察三类数据:每个键值的数据量分布、单位时间请求量分布,以及增长速度。一个今天均匀的键,如果业务模型决定了少数实体会持续变大,也不是稳定选择。
比较租户、用户和时间分片
| 分片方式 | 主要优势 | 长期代价 |
|---|---|---|
按租户 tenant_id |
租户内数据天然聚合,隔离和迁移边界清晰 | 大租户容易形成热点,需要支持租户拆分或独享分片 |
按用户 user_id |
粒度更细,通常比租户维度更均匀 | 租户级统计、批量操作可能跨大量分片 |
按时间 created_at |
归档和冷热分层直观,适合时间范围扫描 | 当前时间窗口持续承接最新写入,极易形成尾部热点 |
按时间分片最容易被“数据天然有时间字段”误导。如果所有新请求都写入当前月份或当天分片,系统只是把热点从数据库表转移到了最新分片。时间通常更适合做分区、归档或二级组织维度,而不是高并发在线写入的唯一分片键。
把跨分片代价算进设计
一个分片键如果让核心事务的数据分散到不同节点,后续通常需要跨分片查询、分布式事务或应用层聚合。它们不仅增加网络往返,还会让故障处理、重试和一致性控制变复杂。
例如订单和订单明细经常一起读写时,应尽量让二者共享同一个路由键。报表类跨租户统计则可以接受异步汇总,因为它不值得反过来破坏在线交易路径的数据局部性。
判断分片键是否足够稳定
上线前可以用四个问题做最后检查:核心请求是否天然携带该键;高流量实体是否可能独占一个分片;核心事务是否能保持数据局部性;未来扩容时能否进一步拆分当前路由空间。
真正稳定的分片键不是“现在最均匀”的字段,而是在业务增长后仍能控制热点、路由和迁移成本的字段。若某个实体天然可能无限增长,就应在方案中预留二级散列、分桶或大客户独立迁移能力,而不是等热点出现后再改变整个数据模型。