
架构与系统设计 / 系统课时
处理热点键与倾斜流量
处理热点键与倾斜流量
平均负载看起来健康,并不代表分布式系统没有容量问题。单个热门用户、商品或时间窗口都可能把请求集中到少数节点。本篇建立热点定位顺序,并用拆键、复制、缓存和局部聚合分别处理写热点、读热点和短时流量倾斜。
学习目标
- 区分热点键、热点分片和热点时间窗口
- 根据读写特征选择拆键、复制、缓存或局部聚合
- 验证治理后负载是否真正从单点扩散,而不是把瓶颈转移到下游
先确认热点发生在哪一层
热点键是少数 key 占据异常高比例的请求,例如一个爆款商品承担 30% 查询。热点分片则表示某个分片整体显著高于其他分片,原因既可能是热点键,也可能是分片范围设计不均。热点时间窗口强调请求只在某个时段突然集中,例如整点抢购或榜单刷新。
定位时不要只看集群平均 CPU。更有效的顺序是先比较节点或分片的 QPS、CPU、队列长度和尾延迟,再对高负载分片统计 Top Key,最后把指标按分钟甚至秒级切分,确认是否具有时间窗口特征。
下面用一个小脚本计算各 key 的请求占比,快速识别是否存在明显热点:
from collections import Counter

requests = (
    ["product-42"] * 60
    + ["product-7"] * 20
    + ["product-9"] * 12
    + ["product-3"] * 8
)

counts = Counter(requests)
total = len(requests)

for key, count in counts.most_common():
    ratio = count / total
    print(f"{key}: count={count}, ratio={ratio:.0%}")
预期输出:
product-42: count=60, ratio=60%
product-7: count=20, ratio=20%
product-9: count=12, ratio=12%
product-3: count=8, ratio=8%
这里 product-42 单独占 60%,即使哈希函数完全均匀,它仍只能被映射到一个分片,因此单纯增加分片数量并不会自动解决问题。
写热点优先考虑拆键和局部聚合
如果大量写请求都修改同一个逻辑对象,例如给视频播放次数加一,直接以 video_id 为 key 会让所有更新落在同一个分区。可以把一个逻辑 key 拆成多个物理 key,例如 video-42#0 到 video-42#15,写入时随机选择一个桶,读取总数时再聚合这些桶。
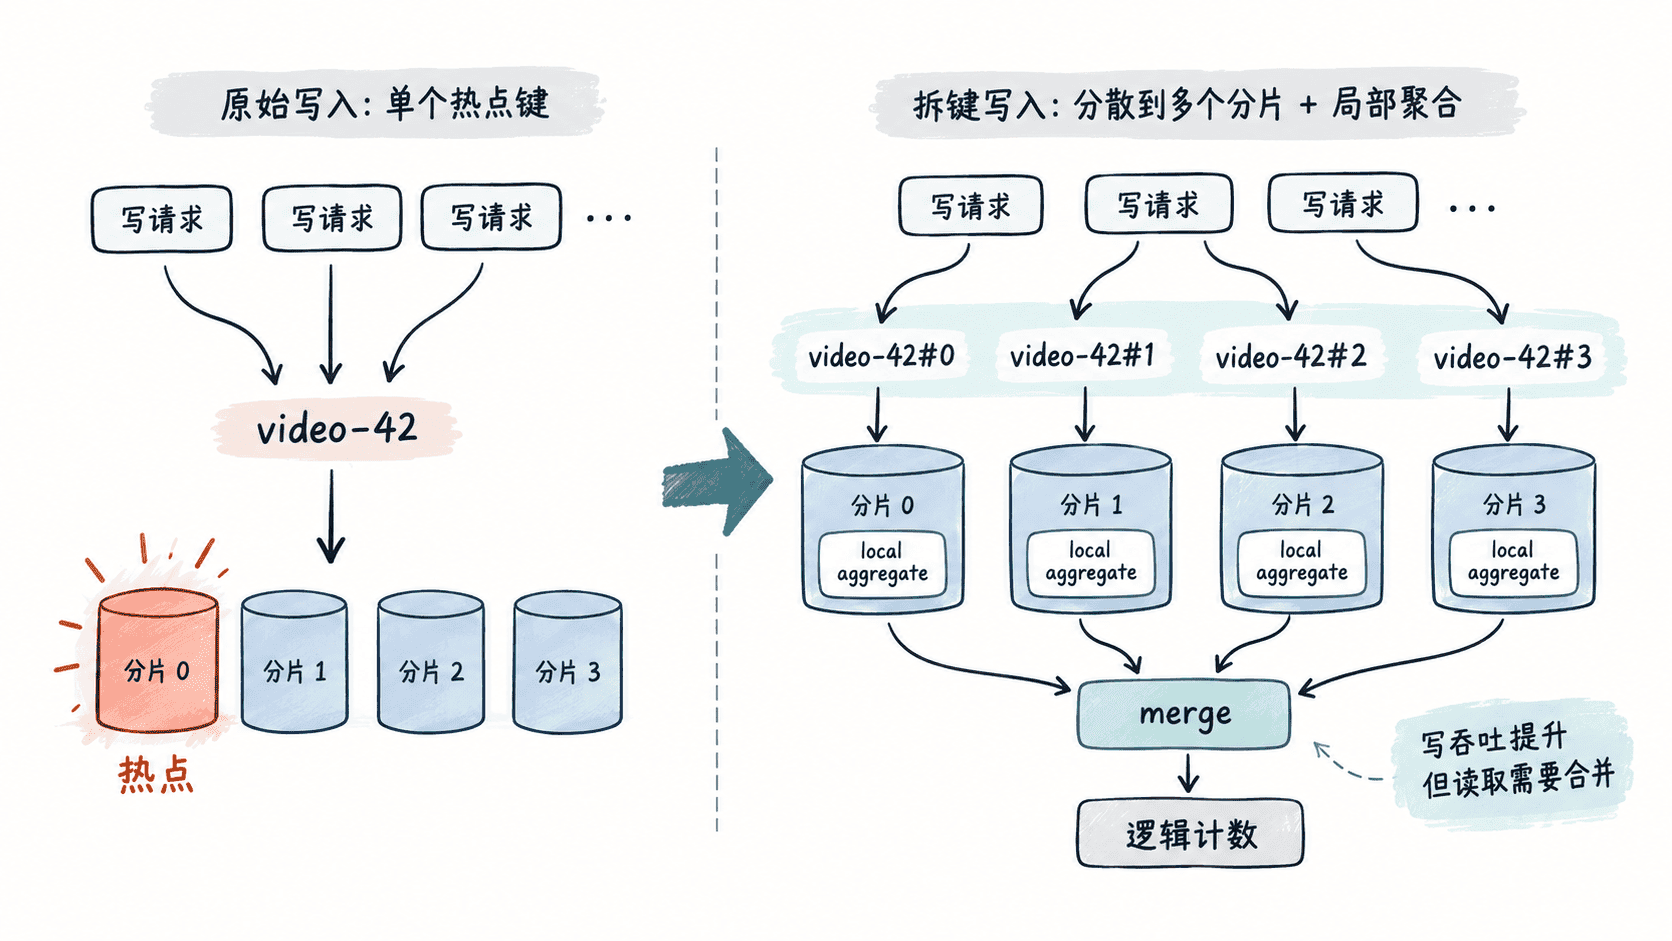
拆键的代价是读取复杂度和一致性成本上升,因此更适合计数器、指标、点赞量等允许聚合的状态,不适合要求每次写入都立即形成单一强一致值的账户余额。
流处理场景还可以在发送到中心聚合器之前先做局部聚合。例如每个工作节点先累计 100 毫秒内的增量,再把合并后的结果发送给同一个逻辑 key。这样不能消除最终汇聚点,但能显著减少消息数量和网络压力。
读热点优先复制和缓存
读多写少的数据更适合复制。一个热门商品详情如果只有单副本,即使存储容量足够,也可能被查询 QPS 压垮。增加只读副本后,可以按连接数、延迟或随机策略把查询分散到多个副本。
缓存进一步把重复读取挡在存储层之前。对于允许数秒陈旧的数据,可以使用本地缓存或分布式缓存,并通过短 TTL、版本号或变更通知控制新鲜度。真正需要关注的是缓存失效瞬间:如果一个热门 key 同时在数千实例中过期,所有请求仍可能一起回源。
对于极热且可容忍短暂陈旧的数据,还可以在缓存层准备多个副本或复制键,让读取请求再次散开。但如果每次写入都要同步更新大量副本,写放大会反过来成为瓶颈,因此复制数量要与更新频率一起评估。
不同倾斜类型需要不同手段
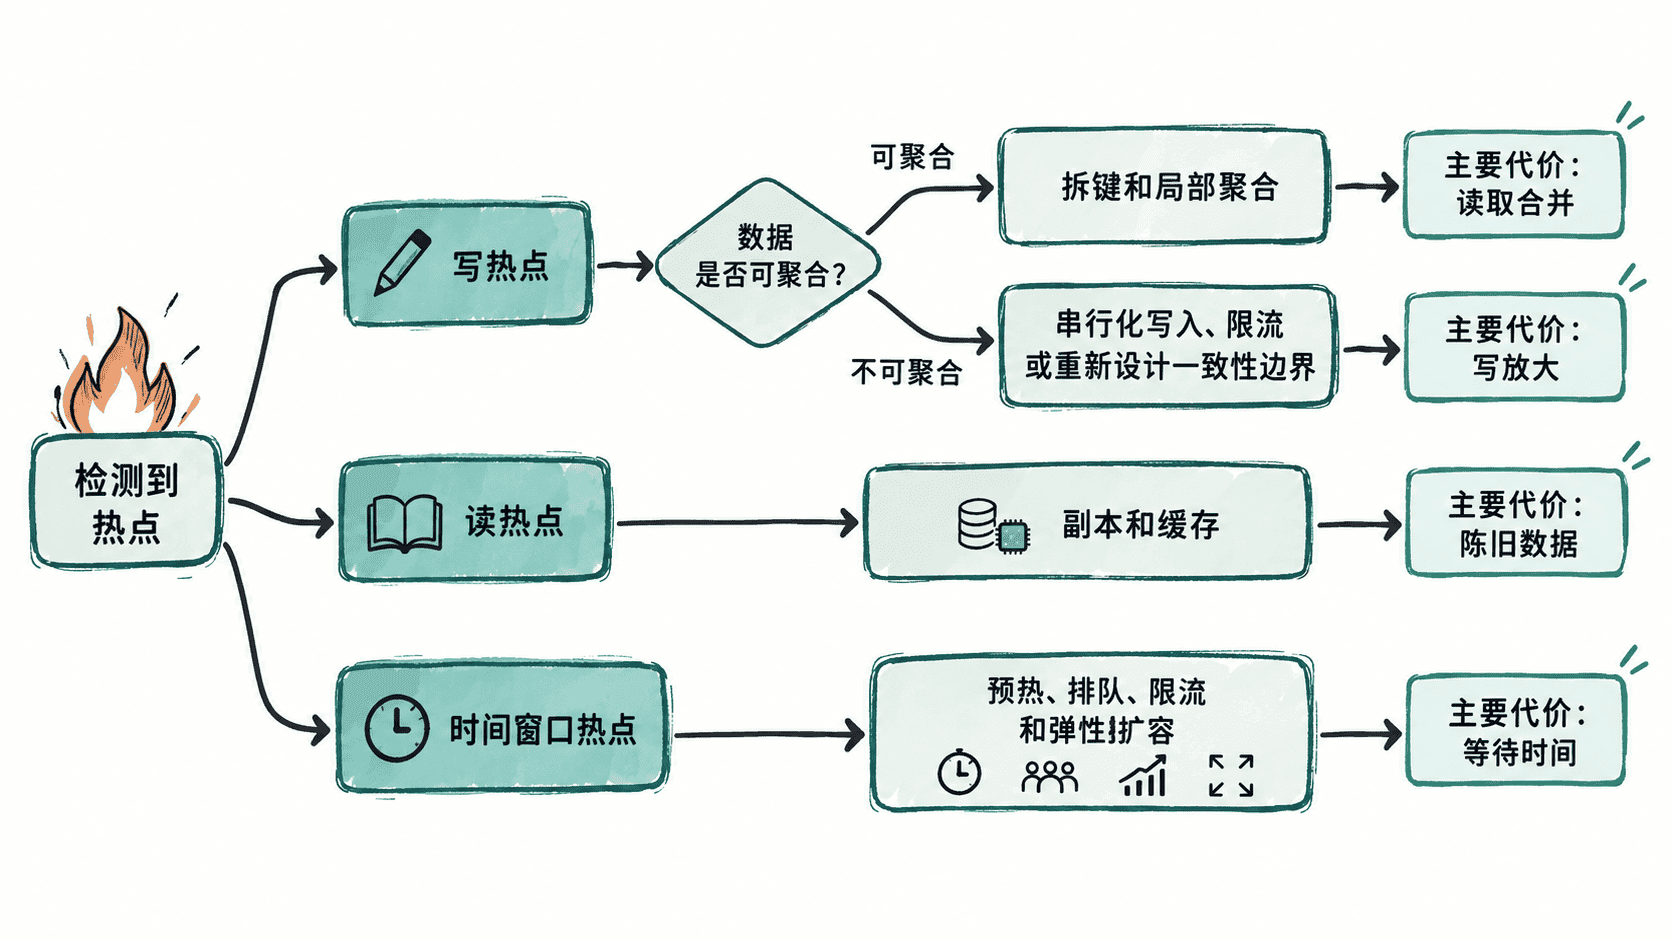
热点时间窗口通常不能只靠改 key 解决。抢购开始后的十秒内请求暴涨,即使 key 分布均匀,系统总容量也可能不足。这时应结合预热缓存、提前扩容、队列削峰和入口限流,把瞬时并发转换为系统能够持续处理的速率。
如果热点来自范围分片,例如最新时间段的数据全部落到最后一个分片,则问题属于分片策略本身。可以在时间前缀之外增加散列后缀,使当前时间窗口被多个分片共同承载,再在查询端并行读取并合并。
验证不要只看平均值
优化后至少比较治理前后的 Top Key 占比、各分片 QPS 最大值与中位数、P95/P99 延迟、队列长度和缓存回源率。目标不是让所有节点数字完全一致,而是确保最热节点不再首先达到资源极限。
还要检查瓶颈是否被简单下移。例如把请求缓存后,缓存节点可能成为新热点;拆键后,最终合并器可能成为新热点;增加副本后,更新广播可能消耗大量带宽。每引入一层扩散,都要继续追踪下一层的扇入点。
处理倾斜的核心不是寻找一种通用技巧,而是先判断什么在集中、为什么集中以及是否允许拆散。可拆分的写负载用拆键与局部聚合,可复制的读负载用副本与缓存,短时峰值用削峰和限流;若业务语义要求所有操作必须汇聚到同一个强一致对象,就应明确接受该串行化边界,并围绕它设计容量和保护机制。