
架构与系统设计 / 系统课时
处理网络分区与半开连接
处理网络分区与半开连接
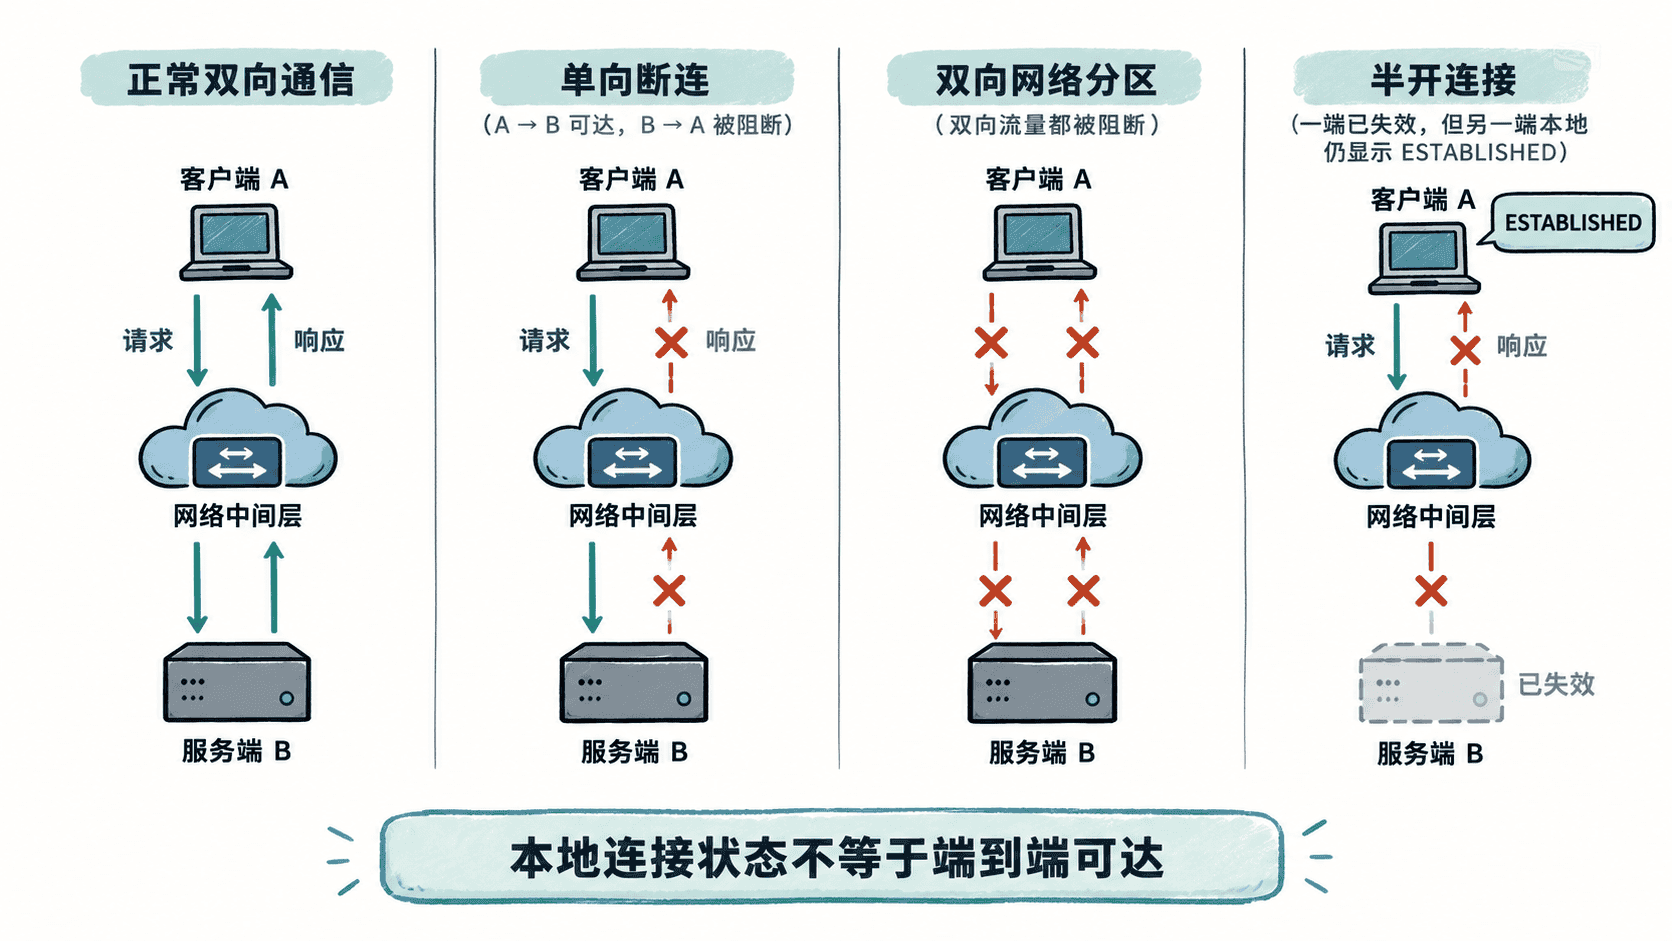
网络连接“还在”不等于对端真的可用。本篇把单向断连、网络分区与半开连接拆开分析,并给出从探测、隔离到恢复的处置边界,避免把一次超时误判成节点死亡,也避免在未知执行结果上盲目重试。
学习目标
- 区分单向断连、网络分区和半开连接造成的不同状态错觉
- 设计传输层探测与应用层心跳的分工
- 在超时后划清隔离、重连、重试和节点判死的边界
状态错觉从哪里来
TCP 连接状态只代表本机内核掌握的状态。若中间链路突然丢包,双方都可能继续显示 ESTABLISHED;若只有一个方向可达,A 发出的请求可能到达 B,但 B 的响应回不来;若一端进程崩溃、机器休眠或 NAT 映射消失,另一端在再次发送并触发重传超时前,也可能长期不知道连接已经失效。
因此,没有收到 RST 或 FIN 不是存活证明。真正危险的是“执行结果未知”:请求可能没到达,也可能已在对端执行,只是响应丢失。后续是否能重试,取决于操作是否幂等,或是否有请求 ID、去重记录与结果查询能力。
探测必须分层
传输层 Keepalive 适合发现“长时间没有任何通信、对端或链路已消失”的连接,但默认探测周期往往偏长,而且只能说明 TCP 对端是否响应。应用进程卡死、线程池耗尽或依赖雪崩时,TCP 仍可能正常收发 ACK。
应用层心跳应验证“当前服务能否完成最小业务响应”,并设置独立于业务请求的 deadline。不要因为一次心跳超时就立即判死:短暂排队、GC 暂停或瞬时丢包都可能制造假阳性。常见做法是连续多次失败后将连接标记为可疑,再进入隔离与重连流程。
用超时驱动隔离边界
下面的最小程序建立本机 TCP 连接。服务端只回复第一次心跳,之后保持连接但不再响应;客户端连续两次超时后隔离该连接。它刻意展示“TCP 没主动关闭,但应用已不可用”的状态。
import socket
import threading
import time

def run_server(listener):
    conn, _ = listener.accept()
    with conn:
        for index in range(3):
            data = conn.recv(4)
            if not data:
                return
            if index == 0:
                conn.sendall(b"PONG")
            else:
                # 保持 TCP 连接存在,但模拟应用线程无法继续响应。
                time.sleep(0.3)

listener = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
listener.bind(("127.0.0.1", 0))
listener.listen(1)

threading.Thread(target=run_server, args=(listener,), daemon=True).start()

client = socket.create_connection(listener.getsockname())
client.settimeout(0.1)

misses = 0
for probe in range(1, 4):
    client.sendall(b"PING")
    try:
        reply = client.recv(4)
        misses = 0
        print(f"probe={probe} result={reply.decode()}")
    except socket.timeout:
        misses += 1
        print(f"probe={probe} result=timeout")
        if misses >= 2:
            print("decision=quarantine")
            break

client.close()
listener.close()
预期输出
probe=1 result=PONG
probe=2 result=timeout
probe=3 result=timeout
decision=quarantine
示例中的超时值只用于快速复现;生产环境应根据端到端延迟分布、重试成本和故障恢复目标确定 deadline,不能机械照搬固定毫秒数。
超时之后不要直接判定节点死亡
连接级失败与节点级失败应分层处置。某条连接连续探测失败时,先停止把新请求路由到它并建立新连接;只有当多个独立连接、健康检查或成员协议都给出一致证据时,才把节点升级为不可用。这样可避免单个 NAT、交换路径或本机连接异常扩大成集群成员误删。
对已经发出的写请求,如果响应丢失,应把结果视为“未知”而不是“失败”。只有幂等写、带幂等键的写,或能先查询执行结果的操作,才适合自动重试。否则重复提交可能造成扣款两次、库存重复扣减等副作用。
恢复也需要证据
恢复不能只看一次心跳成功。更稳妥的做法是重新建连并完成握手,让若干次健康探测连续成功后再恢复流量;如果协议存在任期、会话版本或 fencing token,还要拒绝旧连接晚到的响应,防止故障前的消息在恢复后污染新状态。
网络故障最重要的边界不是“尽快判死”,而是区分连接不可用、节点可疑和操作结果未知。只有把这三种状态分开,系统才能在分区和半开连接下既快速止损,又避免错误重试与错误成员变更。