
架构与系统设计 / 系统课时
评审订单系统的分布式方案
评审订单系统的分布式方案
订单系统评审不能只看服务是否拆开,而要验证数据归属、一致性边界、异步消息、失败恢复和容量预算能否共同成立。下面以“创建订单并扣减库存、发起支付”为主链路,给出一套端到端评审方法。
学习目标
- 从业务不变量反推数据归属和一致性边界
- 检查异步通信中的幂等、重试和故障恢复闭环
- 用容量预算验证分片、队列和下游依赖是否留有余量
从业务不变量开始评审
先写清楚系统必须守住什么,而不是先讨论 Kafka、分库或 Saga。订单链路至少要回答:同一订单能否重复创建;库存是否允许超卖;支付成功后订单是否可能长期停留在未支付;退款、取消与库存释放谁负责推进。
这些不变量决定事务边界。能在一个服务和一个本地数据库事务内完成的写入,不应为了“分布式”而拆成跨服务强一致事务;必须跨服务的动作,则要明确接受短暂不一致,并设计可恢复的状态推进方式。
检查数据归属与主链路
一个可评审的方案需要明确每份核心数据只有一个权威写入方。订单服务拥有订单状态,库存服务拥有可售库存,支付服务拥有支付结果;其他服务通过 API 或事件获取副本,不直接越权更新对方数据库。
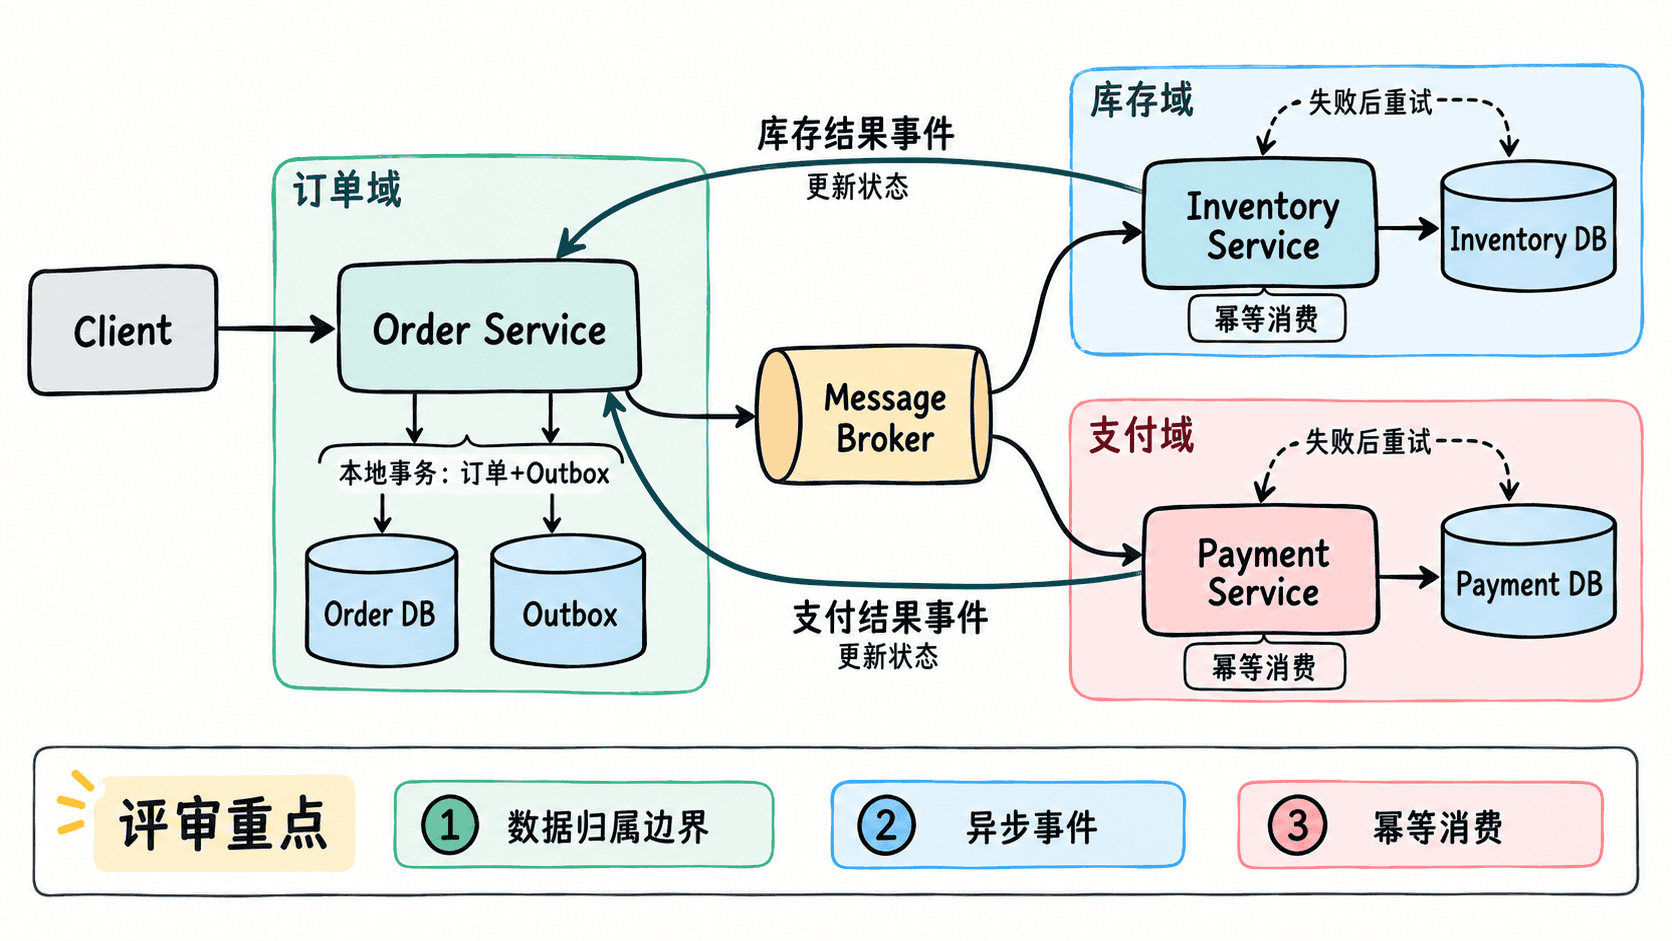
推荐优先检查“订单落库与事件发布”之间是否存在丢消息窗口。常见做法是让订单记录和 Outbox 事件进入同一个本地事务,再由独立发布器把事件送到消息系统。这样可以避免订单已经提交但事件永久丢失,也避免依赖跨服务两阶段提交。
检查异步通信和故障恢复
对每条消息都要追问三个问题:重复投递怎么办、消费者失败怎么办、消息长期处理不了怎么办。只写“使用消息队列解耦”远远不够。
| 评审点 | 可接受设计 | 需要追问 |
|---|---|---|
| 幂等 | 以 eventId 或业务唯一键去重 |
去重记录与业务写入是否同事务 |
| 重试 | 有限次数重试并带退避 | 重试是否放大下游故障 |
| 死信 | 超限进入死信队列并告警 | 谁负责补偿与重放 |
| 状态推进 | 事件驱动并允许重复消费 | 乱序事件是否会回滚状态 |
| 对账 | 定时扫描长期中间态 | 能否自动修复而非只告警 |
订单系统还要验证超时和补偿闭环。例如库存已预占但支付长期没有结果时,谁触发取消、何时释放库存、重复取消是否安全,都必须有明确状态机或定时扫描机制。
把容量约束量化
架构评审必须把容量写成数字。假设峰值订单写入为 1200 QPS,每个订单平均产生 3 次核心写入,并预留 40% 余量;单个数据库分片稳定写入能力按 900 QPS 估算,可以先计算最少分片数。
from math import ceil

peak_orders_per_sec = 1200
write_amplification = 3
headroom = 0.40
single_shard_writes_per_sec = 900

required_write_qps = peak_orders_per_sec * write_amplification * (1 + headroom)
minimum_shards = ceil(required_write_qps / single_shard_writes_per_sec)

print(f"required_write_qps={required_write_qps:.0f}")
print(f"minimum_shards={minimum_shards}")
预期输出:
required_write_qps=5040
minimum_shards=6
这里的 6 只是当前假设下的下限,不是最终部署答案。还要继续验证热点订单号是否均匀、索引和事务是否放大写入、主从复制带宽是否足够,以及单分片失效时剩余分片能否承接流量。
同样的方法也应落到消息系统和下游:峰值事件速率是多少,消费者并发多少,允许积压多久,支付或库存服务降速后队列会以多快速度增长。容量评审要找的是“最先耗尽的资源”,而不是只证明某个组件单独足够快。
给出可执行的评审结论
好的架构评审结论应落到具体行动,而不是“整体可行”。至少要指出哪些不变量已经有实现保证,哪些链路依赖异步一致性,哪些失败场景已经能自动恢复,以及容量模型中的最大风险点。
如果方案满足数据单一归属、关键本地事务闭合、跨服务消息可幂等重放、长期中间态可被对账修复,并且容量预算在故障降级后仍保留余量,那么这套订单架构才具备进入生产演练的基础。反之,只要其中一项无法被验证,就应在上线前转化成明确的整改项和验收条件。