
架构与系统设计 / 系统课时
用负载与故障验证设计假设
用负载与故障验证设计假设
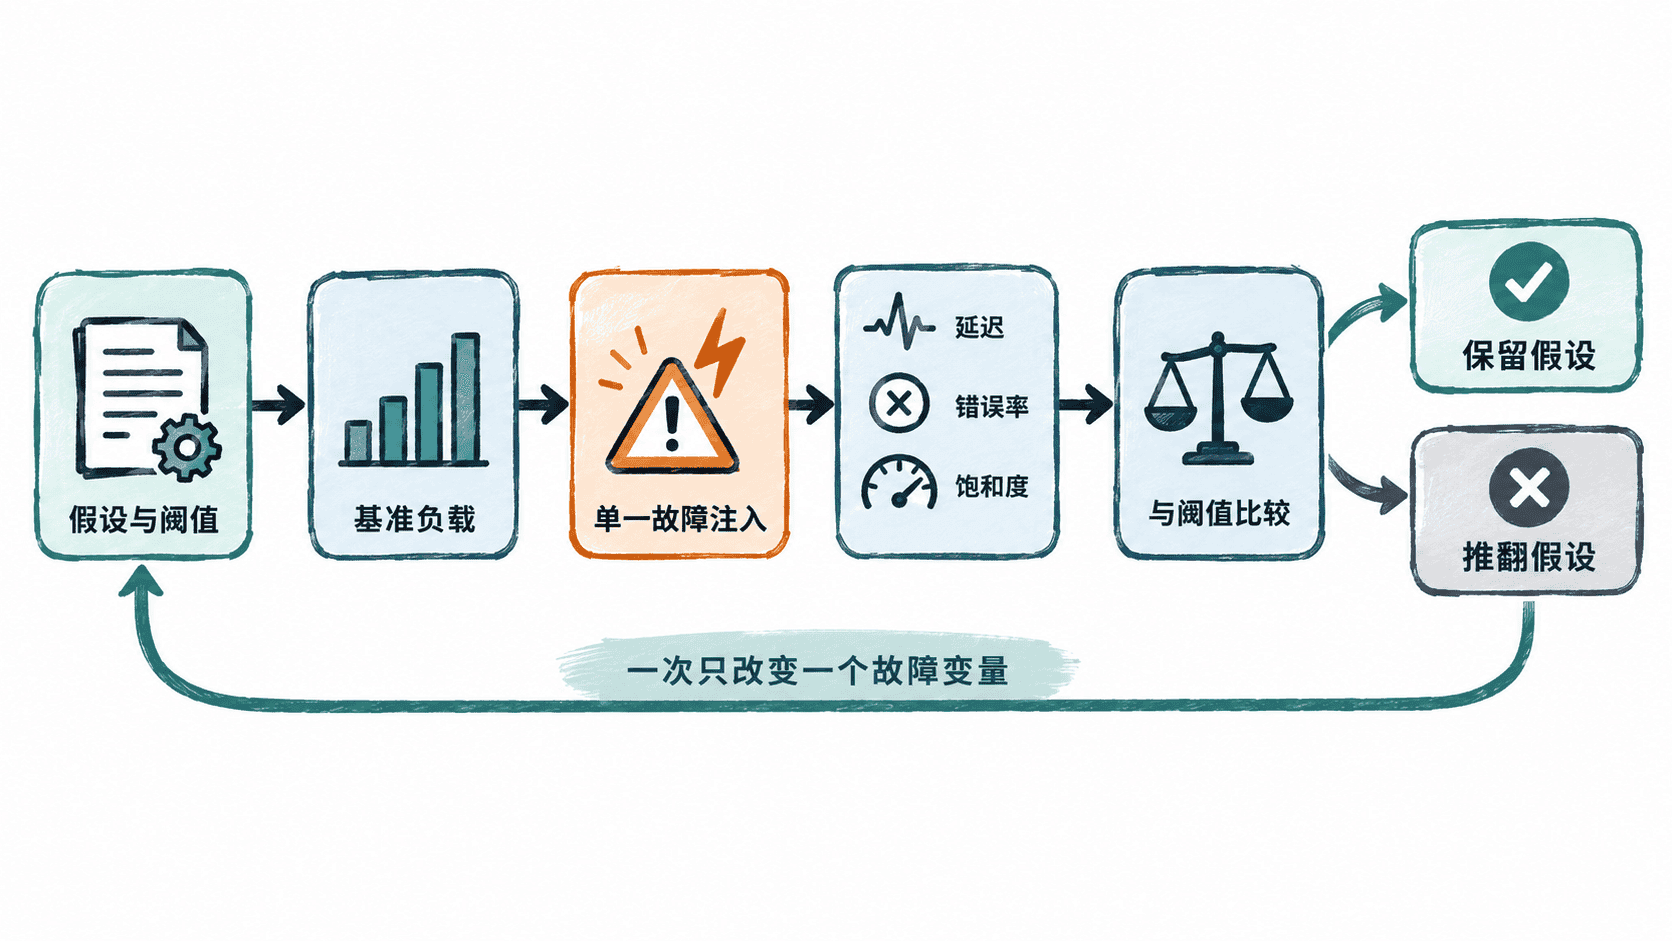
架构图上的超时、降级和容量数字都只是设计假设。要判断它们是否成立,需要先建立可重复的基准负载,再只改变一个故障变量,观察延迟、错误率和资源饱和度是否仍落在预先定义的边界内。
学习目标
- 把架构判断改写成可以被实验推翻的假设与阈值
- 设计基准负载与单变量故障实验,并记录可比较的观测结果
- 根据实验结果决定保留、调整还是推翻原有设计
先把设计判断写成可证伪假设
“系统应该扛得住下游变慢”无法直接验证。实验前应把它改写成带条件和阈值的陈述,例如:在固定请求量下,下游延迟从正常值升到 200 ms 后,调用方应在 50 ms 超时,未完成请求不得无限占用线程。
基准实验和故障实验必须使用相同的请求模型。否则错误率变高究竟来自故障还是负载变化,就无法判断。最小实验通常只需要控制四类变量:请求量、并发度、客户端超时和被注入的故障。
运行一个最小负载与慢响应实验
下面的程序只使用 Python 标准库。它启动一个本地 HTTP 服务,先以 5 个并发执行 20 个正常请求,再保持负载不变,把服务端处理时间固定为 200 ms,而客户端超时仍为 50 ms。
from concurrent.futures import ThreadPoolExecutor
from http.server import BaseHTTPRequestHandler, ThreadingHTTPServer
import socket
import threading
import time
import urllib.request


class Handler(BaseHTTPRequestHandler):
    def do_GET(self):
        # 故障实验只改变服务端处理时间,其他条件保持不变。
        if self.path == "/slow":
            time.sleep(0.2)

        self.send_response(200)
        self.end_headers()
        try:
            self.wfile.write(b"ok")
        except BrokenPipeError:
            # 客户端超时关闭连接后,服务端写响应可能失败。
            pass

    def log_message(self, format, *args):
        pass


server = ThreadingHTTPServer(("127.0.0.1", 0), Handler)
threading.Thread(target=server.serve_forever, daemon=True).start()
base_url = f"http://127.0.0.1:{server.server_port}"


def request_once(path):
    try:
        with urllib.request.urlopen(base_url + path, timeout=0.05) as response:
            return response.status == 200
    except (TimeoutError, socket.timeout):
        return False


def run(path):
    # 两轮都固定为 20 个请求和 5 个并发,只切换请求路径。
    with ThreadPoolExecutor(max_workers=5) as pool:
        results = list(pool.map(lambda _: request_once(path), range(20)))
    success = sum(results)
    return success, len(results) - success


baseline = run("/normal")
fault = run("/slow")

print(f"baseline success={baseline[0]} timeout={baseline[1]}")
print(f"fault success={fault[0]} timeout={fault[1]}")

server.shutdown()
server.server_close()
预期输出:
baseline success=20 timeout=0
fault success=0 timeout=20
这里验证的不是“系统性能很好”,而是一个更窄的假设:当服务端耗时明显超过客户端超时阈值时,请求能在调用方被有界地终止。localhost 的结果不能直接推导生产容量,它只是建立可重复的验证方法。
用观测结果判断假设是否成立
判断实验时不要只看有没有报错。基准阶段应先确认请求本身稳定,再比较故障阶段的延迟、错误率和资源占用。若客户端虽然及时超时,但线程、连接或队列持续增长,设计仍可能在长时间故障下失效。
| 观测结果 | 可以得出的判断 |
|---|---|
| 基准负载已失败 | 实验基线无效,应先处理容量或环境问题 |
| 故障出现后快速失败且资源稳定 | 超时边界基本符合设计假设 |
| 延迟不断增长且资源持续堆积 | 隔离或超时没有真正限制故障扩散 |
| 结果波动很大 | 需要增加重复次数,并检查是否同时改变了其他变量 |
让实验能够重复和比较
生产级验证应在实验前记录负载模型、并发度、超时值和判定阈值,并保存基准结果。随后每次只引入一种故障,例如固定延迟、连接拒绝或单实例退出,再使用相同指标比较差异。
真正有价值的故障实验不是制造一次异常,而是提供证据:正常条件下系统处于什么状态,某个明确故障出现后哪些指标发生变化,以及这些变化是否越过设计允许的边界。只有这样的结果才能用于修改容量、超时、隔离和降级策略。