
架构与系统设计 / 系统课时
设计跨可用区的冗余拓扑
设计跨可用区的冗余拓扑
跨可用区高可用不是把实例数量从一台改成三台,而是确保计算、存储、入口和关键依赖不会同时落入同一故障域。本篇从故障域入手,设计一套能承受单可用区失效的部署与流量拓扑,并识别常见的“伪高可用”。
学习目标
- 按故障域检查计算、存储、入口和依赖服务是否真正冗余
- 设计跨可用区实例分布、流量分配与存储副本策略
- 用故障注入验证单可用区失效后系统仍能提供服务
先按故障域而不是实例数设计
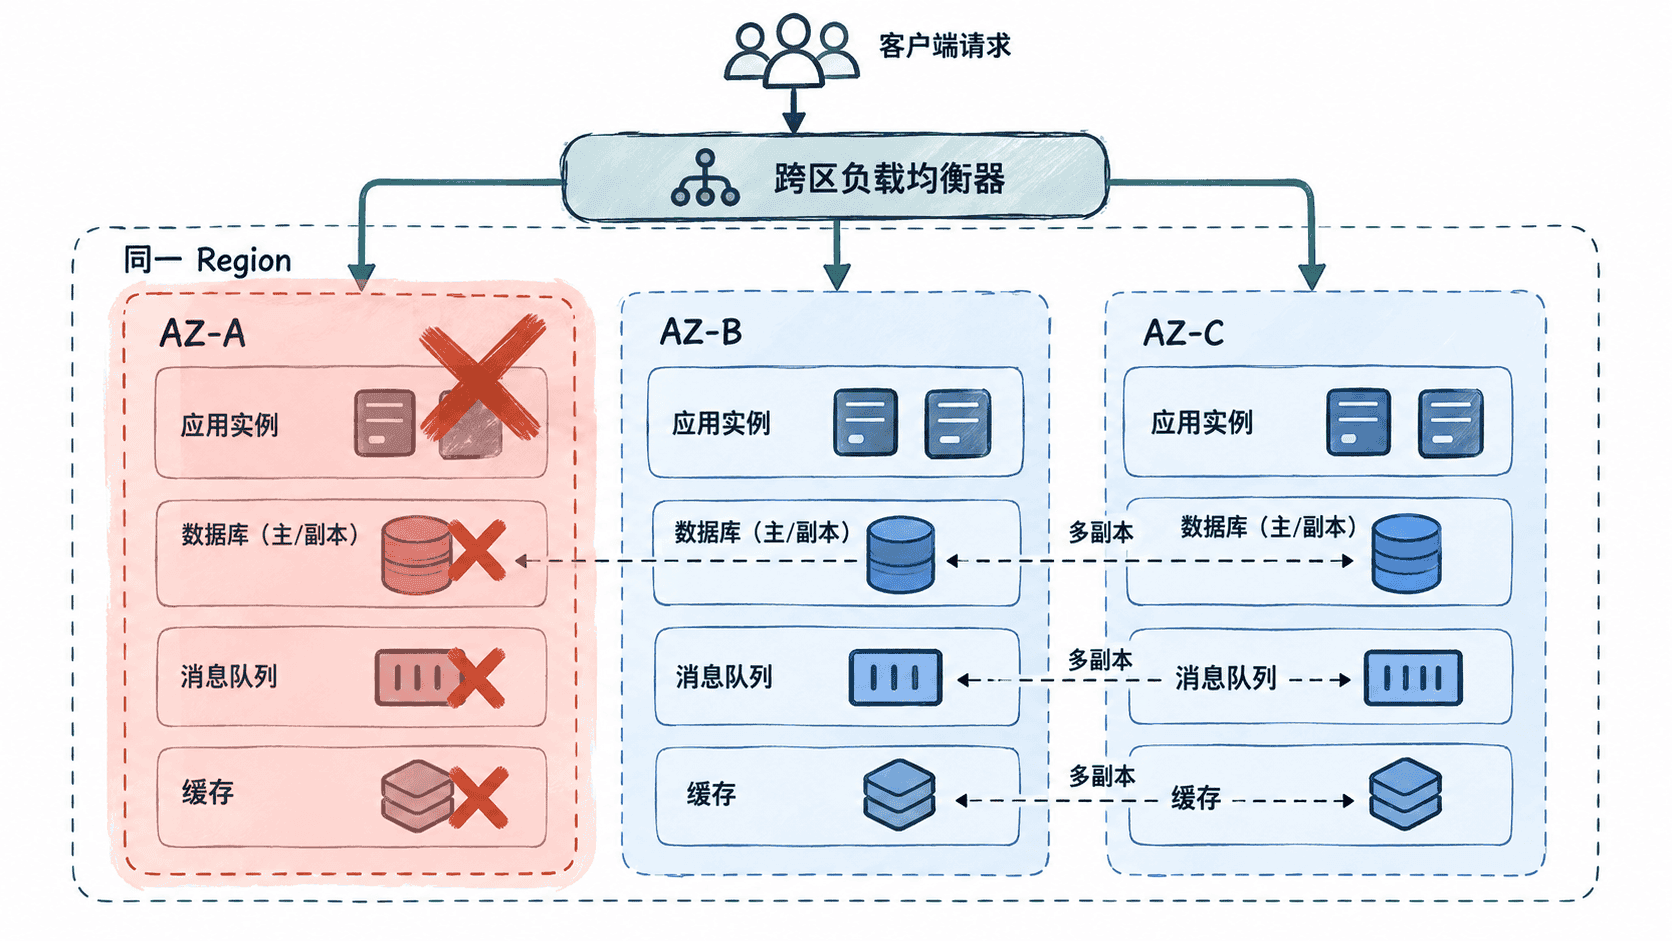
可用区可以理解为同一地域内相互隔离的基础设施故障域。电力、网络或底层平台故障可能让一个可用区整体不可用,因此“有三个实例”并不能直接推出“可承受一个可用区故障”。
例如 3 个应用实例全部调度到 AZ-A,即使前面有负载均衡器,AZ-A 故障时仍会一次失去全部计算能力。同样,应用跨了三个可用区,但数据库只有 AZ-A 的单节点,整体可用性仍由数据库决定。
设计时至少同时检查四层:入口是否跨故障域、无状态计算是否跨区、持久化数据是否有跨区副本、DNS、消息队列、缓存、认证等关键依赖是否具有同等级别的冗余。
让计算实例真正跨区分布
容器平台上的调度约束应表达“不同可用区尽量均匀”,而不是只设置副本数。下面以 Kubernetes 为例,把 6 个 order-api Pod 按 topology.kubernetes.io/zone 分散,并禁止调度结果进一步扩大区域间倾斜。
将以下内容保存为 deployment.yaml:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: order-api
spec:
  replicas: 6
  selector:
    matchLabels:
      app: order-api
  template:
    metadata:
      labels:
        app: order-api
    spec:
      topologySpreadConstraints:
        - maxSkew: 1
          topologyKey: topology.kubernetes.io/zone
          whenUnsatisfiable: DoNotSchedule
          labelSelector:
            matchLabels:
              app: order-api
      containers:
        - name: order-api
          image: nginx:1.27
          ports:
            - containerPort: 80
应用配置:
kubectl apply -f deployment.yaml预期输出:
deployment.apps/order-api created再查看 Pod 所在节点及区域标签:
kubectl get pods -l app=order-api -o wide预期结果是 6 个 Pod 被分散到属于不同可用区的节点上;节点名、IP 和运行时间属于动态值,实际输出会不同。如果集群只有一个可用区,或者节点没有正确的区域标签,调度约束本身无法创造跨区高可用。
把流量和容量一起考虑
跨区部署后,还要确保入口能检测实例健康并停止向故障区发送新请求。负载均衡器、服务发现或网关的健康检查应覆盖真正影响请求成功的关键状态,而不是仅判断进程是否存活。
容量设计也必须允许一个可用区退出。假设三个可用区平时各承担约三分之一流量,如果任意一区失效后剩余两区已经接近满载,那么拓扑虽然“跨了三个区”,故障时仍会因 CPU、连接池或下游限流而雪崩。生产容量应按照目标故障场景预留余量,而不是只按正常流量配满资源。
存储和依赖决定可用性的上限
数据库、对象存储、消息系统等有状态组件需要单独确认复制范围。应用实例跨区,而数据库主节点和唯一副本都在同一区,仍然属于单故障域。对同步复制系统,还要检查失去一个区域后剩余副本是否仍满足法定人数;对异步复制系统,则必须接受可能存在非零 RPO。
依赖服务同样需要沿请求链检查。订单接口可能依赖认证、缓存、数据库和消息队列,其中任何一个只有单区实例,都会成为系统真实的可用性上限。评审架构时应沿着一次关键业务请求逐跳标记故障域,而不是只看自己的应用部署图。
用单区失效验证而不是看拓扑图验收
验收跨可用区架构时,应选择一个非生产或受控演练环境,让某个区域内的应用实例停止接收流量,并观察入口摘除、剩余实例容量、数据库可写性和关键依赖是否正常。关注的是端到端业务结果,而不仅是 Pod 是否还存在。
一个合格的跨区方案应该能明确回答:任意一个可用区完全失效时,哪些组件会消失、流量如何收敛、剩余区域是否有足够容量、数据是否还能读写,以及恢复区域重新加入时如何避免瞬时流量和数据同步压力。
真正的跨可用区高可用建立在故障域隔离之上。只有计算、入口、数据和关键依赖都没有共享单一故障点,并且通过单区故障演练验证过,冗余拓扑才从“看起来有副本”变成可验证的生产能力。