
架构与系统设计 / 系统课时
规划RPO与RTO恢复路径
规划RPO与RTO恢复路径
RPO 和 RTO 只有落到具体恢复路径上才有工程意义。本课把数据丢失上限与恢复时间目标拆成复制、备份、恢复、验证和切流动作,并用一次可计算的恢复演练判断目标是否真的可达。
学习目标
- 区分 RPO、RTO 与备份频率、复制延迟之间的关系
- 把恢复目标转换为复制、备份和恢复步骤
- 用演练数据验证一条恢复路径是否满足既定目标
先把目标写成可验证的约束
RPO,Recovery Point Objective,描述故障后最多允许丢失多长时间的数据。例如 RPO 为 5 分钟,意味着恢复后的数据状态不能落后故障前超过 5 分钟。它不是“每 5 分钟做一次备份”的同义词,因为异步复制、日志归档和备份都可能形成不同恢复点。
RTO,Recovery Time Objective,描述从故障发生到业务恢复到可接受服务水平允许消耗的最长时间。RTO 应覆盖故障检测、人工或自动决策、资源准备、数据恢复、应用启动、验证以及流量切换,而不只是数据库恢复耗时。
因此,一项服务的恢复目标至少要同时回答:恢复到哪个数据点、从哪个副本或备份恢复、恢复后如何确认业务正确,以及总过程是否能在时间窗口内完成。
把RPO映射到数据保护策略
数据保护通常不是只选一种机制,而是组合使用。异步跨地域复制适合快速接管,但复制延迟直接影响故障时可能丢失的数据量;周期性备份提供更独立的恢复副本,但恢复点受备份间隔限制;日志归档与时间点恢复则能进一步缩小恢复点间隔。
| 恢复来源 | 主要决定的指标 | 典型风险 |
|---|---|---|
| 跨地域异步副本 | 复制延迟 | 故障瞬间尚未复制的数据丢失 |
| 周期备份 | 备份间隔与成功率 | 最近一次备份损坏或过旧 |
| 日志归档/PITR | 日志上传延迟 | 日志链断裂或恢复流程过长 |
例如要求 RPO 不超过 5 分钟时,不能只配置“每 5 分钟备份”就结束设计,还要验证备份实际完成时间、上传延迟和可恢复性。如果主要恢复路径是跨地域副本,则应直接监控复制延迟并把它纳入切换门槛。
把RTO拆成一条恢复路径
一条典型的地域级恢复路径可以拆成故障确认、旧主写入隔离、目标地域资源就绪、数据接管或恢复、应用启动、业务校验和流量切换。每一步都需要负责人、自动化入口、超时阈值和失败后的回退方案。
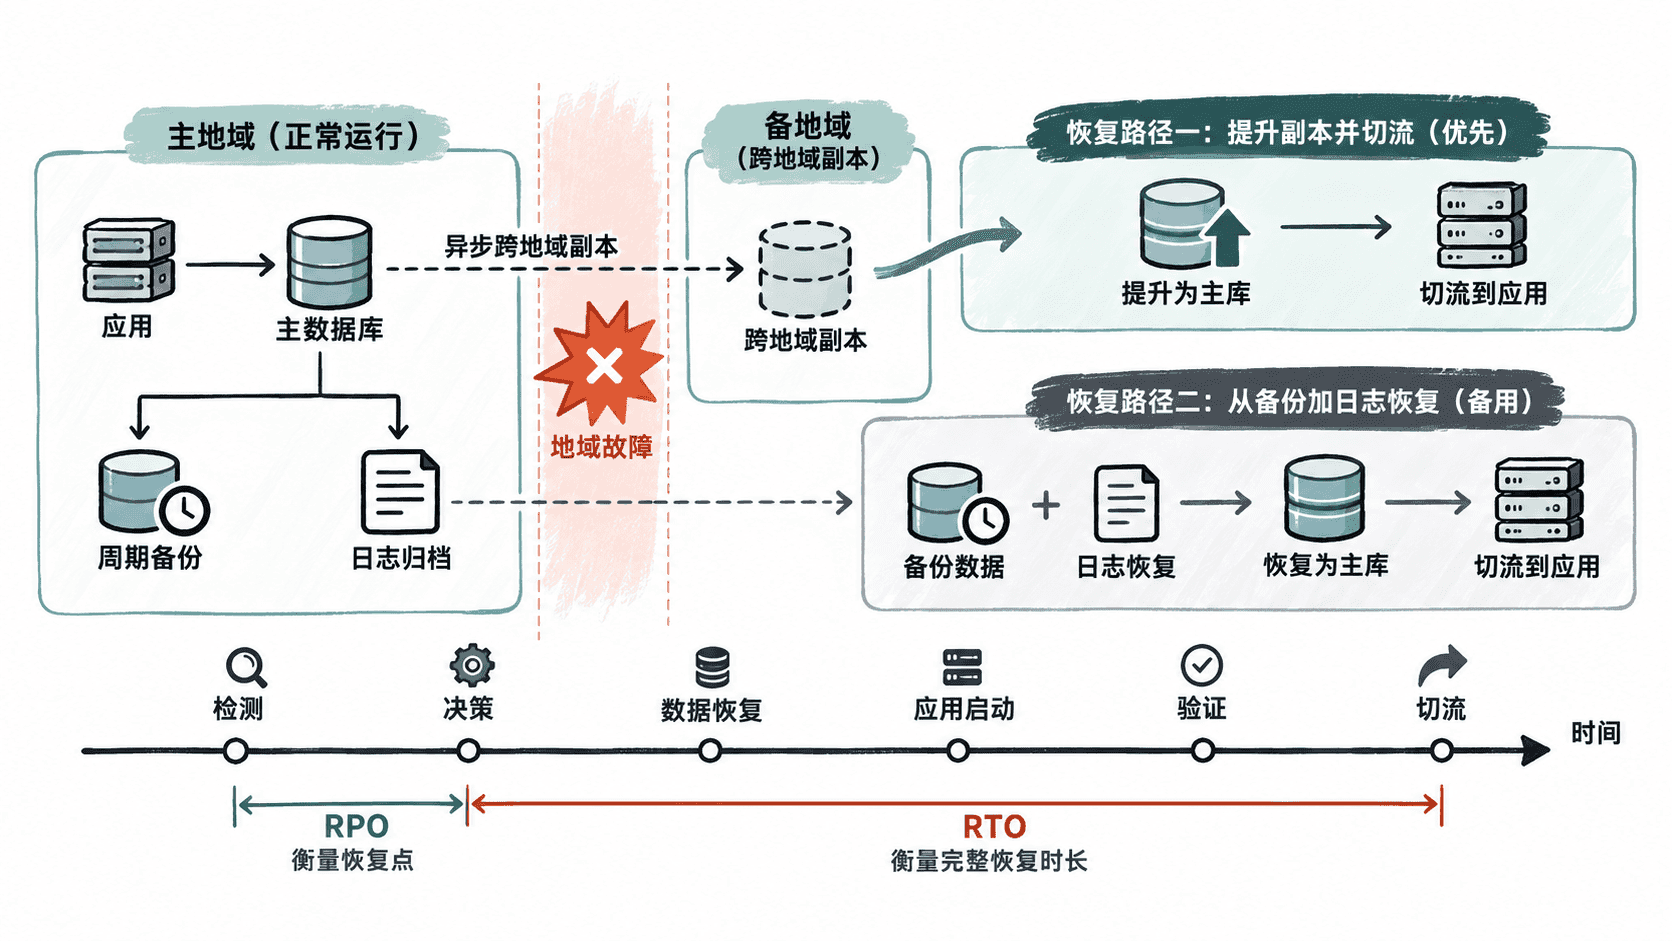
这里最容易漏掉的是验证时间。数据库已经可读并不代表服务已经恢复:还需要验证关键表一致性、消息积压、缓存状态、依赖服务连接以及核心读写请求。如果这些验证需要 10 分钟,它就必须计入 RTO。
用演练数据验证目标
下面的可运行 Python 脚本模拟一个服务的恢复预算:地域故障优先使用异步副本,备用路径使用周期备份,并检查两条路径的 RPO 与恢复耗时是否满足目标。
rpo_target_min = 5
rto_target_min = 30

replica_lag_min = 1
backup_interval_min = 5
restore_min = 18
validation_min = 6

regional_failover_rpo = replica_lag_min
backup_restore_rpo = backup_interval_min
backup_restore_rto = restore_min + validation_min

print(f"regional failover RPO: {regional_failover_rpo} min")
print(f"backup restore RPO: {backup_restore_rpo} min")
print(f"backup restore RTO: {backup_restore_rto} min")
print("regional failover RPO OK:", regional_failover_rpo <= rpo_target_min)
print("backup restore RPO OK:", backup_restore_rpo <= rpo_target_min)
print("backup restore RTO OK:", backup_restore_rto <= rto_target_min)
预期输出:
regional failover RPO: 1 min
backup restore RPO: 5 min
backup restore RTO: 24 min
regional failover RPO OK: True
backup restore RPO OK: True
backup restore RTO OK: True
实际演练时应把这些静态数字替换为监控和恢复记录中的真实耗时,例如复制延迟峰值、最近一次成功备份时间、恢复开始与结束时间。只有多次演练都能稳定满足目标,设计中的 RPO 和 RTO 才具有可信度。
把恢复能力变成持续证据
生产方案至少应保存最近成功备份时间、备份完整性检查结果、复制延迟、恢复演练耗时和业务验证结果。备份“存在”但从未恢复过,不能证明它可用;副本“健康”但没有做过主从角色切换,也不能证明地域故障时能够接管。
当目标发生冲突时,应优先暴露真实成本:更小的 RPO 往往需要更低延迟甚至同步复制,更小的 RTO 则要求更多预置容量、更高自动化程度和更短验证链路。恢复设计的最终产物不是两个数字,而是一条经过演练、能够证明满足这两个数字的恢复路径。