
架构与系统设计 / 系统课时
把CAP用在真实网络分区中
把CAP用在真实网络分区中
CAP真正约束的是网络已经把节点隔开时系统必须如何响应请求,而不是给数据库永久贴上“CP”或“AP”标签。本篇把一次双节点网络分区展开,分别观察拒绝请求与继续本地服务的后果,并建立正常网络和分区期间两套不同的判断方式。
学习目标
- 说明 CAP 中一致性、可用性和网络分区分别指什么
- 区分网络正常时的设计优化与分区发生后的强制取舍
- 根据具体读写操作判断分区期间应拒绝请求还是接受暂时分歧
先把 CAP 放回分区现场
CAP 中的 Consistency 通常讨论单一副本视图或线性一致性,即一个成功写入完成后,后续操作不能表现得像这个写入尚未发生;Availability 要求发往非故障节点的请求最终得到正常响应;Partition 指节点之间的消息被长时间丢弃或延迟,以至于双方无法继续可靠协调。
当网络正常时,节点能够通信,系统可以同时提供一致结果和正常响应。CAP 的关键约束出现在分区已经发生以后:两个无法通信的区域不能既独立接受所有请求,又保证双方始终表现为同一个最新状态。
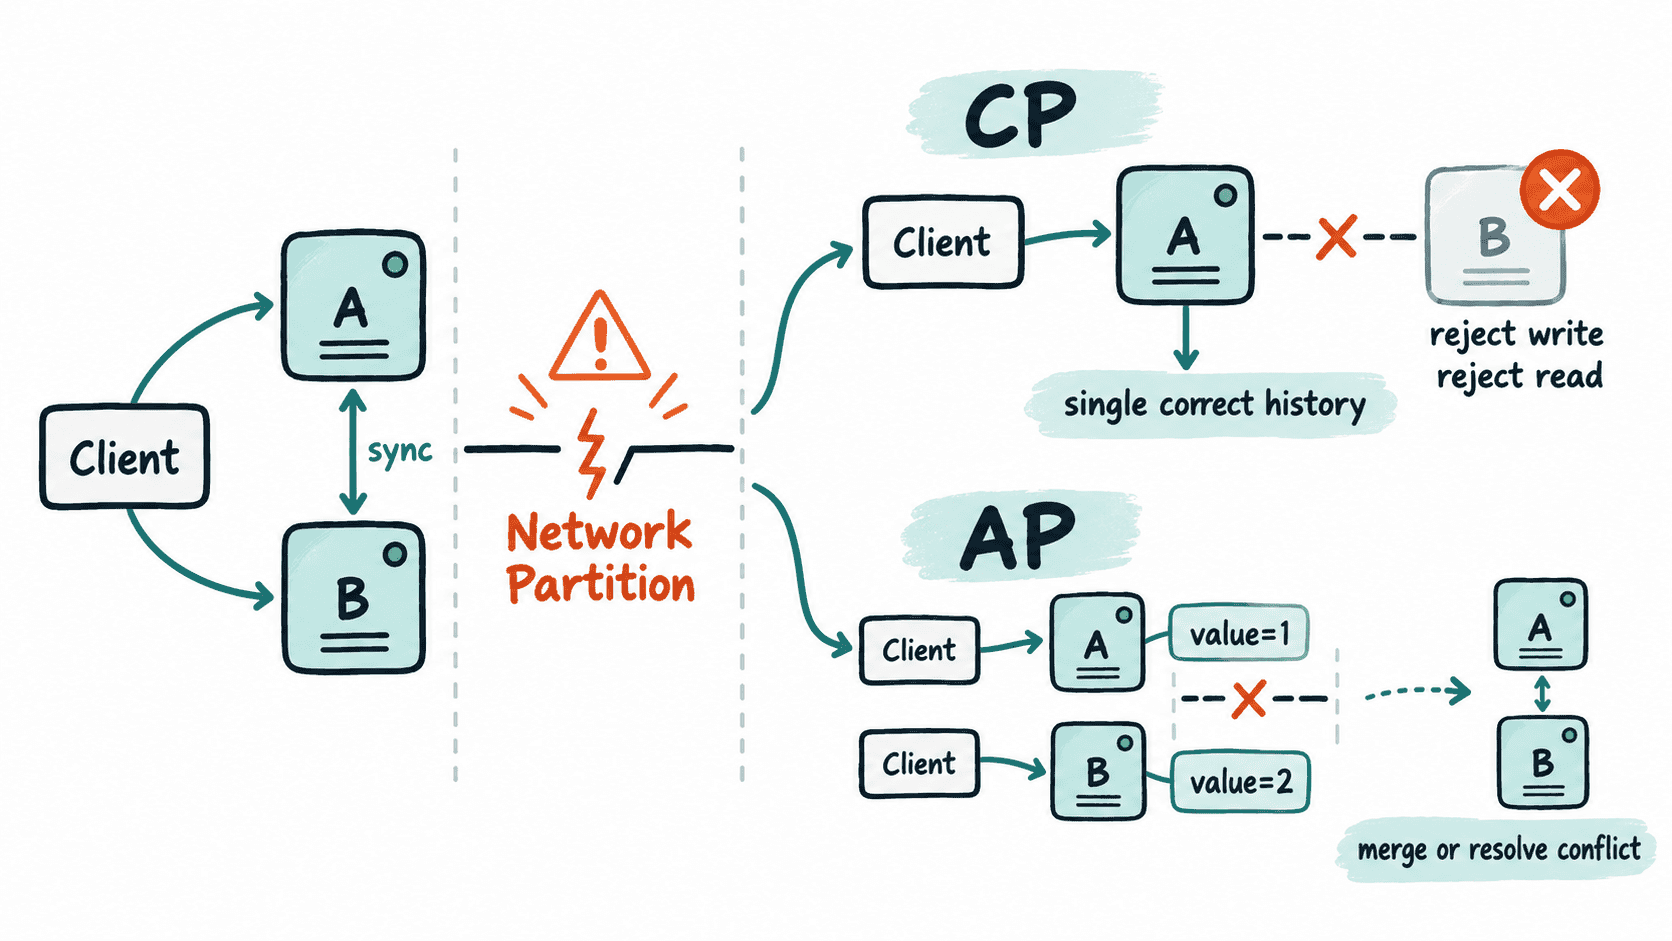
用一个可运行实验观察两种选择
下面的 Python 程序故意把两个副本之间的链路设为不可达。CP 模式在无法联系另一副本时拒绝写入,AP 模式则允许当前副本接受本地写入。它不是完整的共识实现,只用于把分区期间的选择变成可观察结果。
from dataclasses import dataclass

@dataclass
class Replica:
    name: str
    value: int = 0

def write(mode, local, peer, value, can_reach_peer):
    # CP 路径无法完成必要协调时拒绝写入,避免形成两个已确认历史。
    if mode == 'CP' and not can_reach_peer:
        return '503 UNAVAILABLE'

    local.value = value
    # 网络可达时才把本次写入同步给另一副本。
    if can_reach_peer:
        peer.value = value
    return '200 OK'

for mode in ('CP', 'AP'):
    a = Replica('A')
    b = Replica('B')
    status = write(mode, a, b, 1, can_reach_peer=False)
    print(f'{mode}: {status}, A={a.value}, B={b.value}')
预期输出
CP: 503 UNAVAILABLE, A=0, B=0
AP: 200 OK, A=1, B=0
在 CP 路径里,请求失败就是牺牲分区期间可用性的具体表现;在 AP 路径里,A 已经确认新值而 B 仍保存旧值,因此系统必须接受暂时不一致,并在通信恢复后处理状态收敛。
分区期间不能靠等待同时得到 C 和 A
真实系统通常无法立即知道对端究竟宕机、链路断开,还是只是非常慢,只能依赖超时和故障检测器做判断。如果为了维护单一写入顺序而持续等待多数节点,少数分区中的请求最终必须超时或被拒绝,这正是放弃可用性。
反过来,如果每个隔离区域都必须持续成功处理写请求,那么两个区域就可能独立接受互相冲突的值。网络恢复后可以用最后写入胜出、版本向量、CRDT 或业务补偿合并结果,但这些机制解决的是冲突收敛,不能让分区期间已经发生的两个成功响应事后变成同一条实时历史。
不要把系统永久归类成 CP 或 AP
“某数据库是 CP”往往过度简化。更有用的问题是:某类操作在某种故障下选择什么行为。同一套系统完全可以让不同操作采用不同策略。
例如库存扣减不能接受两个分区都承诺最后一件商品,可以要求获得多数派或领导者确认;拿不到确认的一侧返回失败。商品浏览量、在线状态或推荐特征则可能更看重持续服务,允许各区域先更新本地值,恢复通信后再合并。
正常网络期间也没有理由故意牺牲其中一项。系统仍应同时追求低延迟、正确结果与高可用,只有检测到无法完成必要的跨节点协调时,CAP 所描述的冲突才真正出现。因此设计评审应分别写清“正常路径”和“分区路径”,而不是先选一个产品标签再反推行为。
用请求结果检查自己的选择
判断一个分区策略时,可以从客户端可见结果反推:如果某个仍在运行的节点因为无法确认全局状态而返回超时、重试或不可用,系统是在这一操作上优先保护一致性;如果隔离节点仍然确认读写成功,就必须说明可能产生哪些分歧,以及恢复后如何检测和解决冲突。
网络分区不是架构师可以简单选择忽略的条件。真正可以设计的是分区发生后每类请求的失败语义、允许出现的状态分歧,以及恢复阶段的收敛机制;把这些行为写清楚,CAP 才从抽象定理变成可评审的生产架构决策。