
架构与系统设计 / 系统课时
处理事件顺序与分区扩容
处理事件顺序与分区扩容
事件流一旦按分区并行处理,“先发生”并不等于“先被消费”。本篇把顺序保证拆成全局、分区和实体三个层级,并给出分区键选择、扩容风险判断和安全迁移方法,让吞吐扩展不会悄悄破坏业务顺序。
学习目标
- 区分全局顺序、分区顺序与实体顺序,明确各自的成本和适用范围。
- 选择能表达业务顺序边界的分区键,并识别热点键风险。
- 解释分区扩容为何可能拆散同一实体的事件,并设计可验证的迁移方案。
顺序保证先确定范围
全局顺序要求所有事件都能排成唯一先后关系,通常意味着单一串行入口或集中协调,吞吐和可用性成本最高。除撮合、单账本等少数场景外,大多数业务并不需要让“订单 A 的付款”和“订单 B 的取消”比较先后。
分区顺序只承诺同一分区内的记录按写入位置被观察。它适合并行事件流,但前提是需要比较先后的事件必须进入同一分区。
实体顺序是最常见的业务目标,例如同一个 order_id 的 Created → Paid → Shipped 不可颠倒,而不同订单可以并发。工程上通常用实体标识作为分区键,把实体顺序建立在分区顺序之上。
用实体键获得可用的业务顺序
分区键应与“谁必须保持先后”一致。订单状态流优先用 order_id,账户流水可能用 account_id。不要为了“看起来聚合方便”改用地区、租户或事件类型,否则无关实体会互相阻塞,热点租户还可能把单个分区压满。
键还要有足够基数。一个只有几十个值的低基数键,即使分区很多,也可能只有少数分区持续繁忙。真正需要顺序的范围越小,通常越容易获得均衡并行度。
扩容为什么会破坏既有顺序
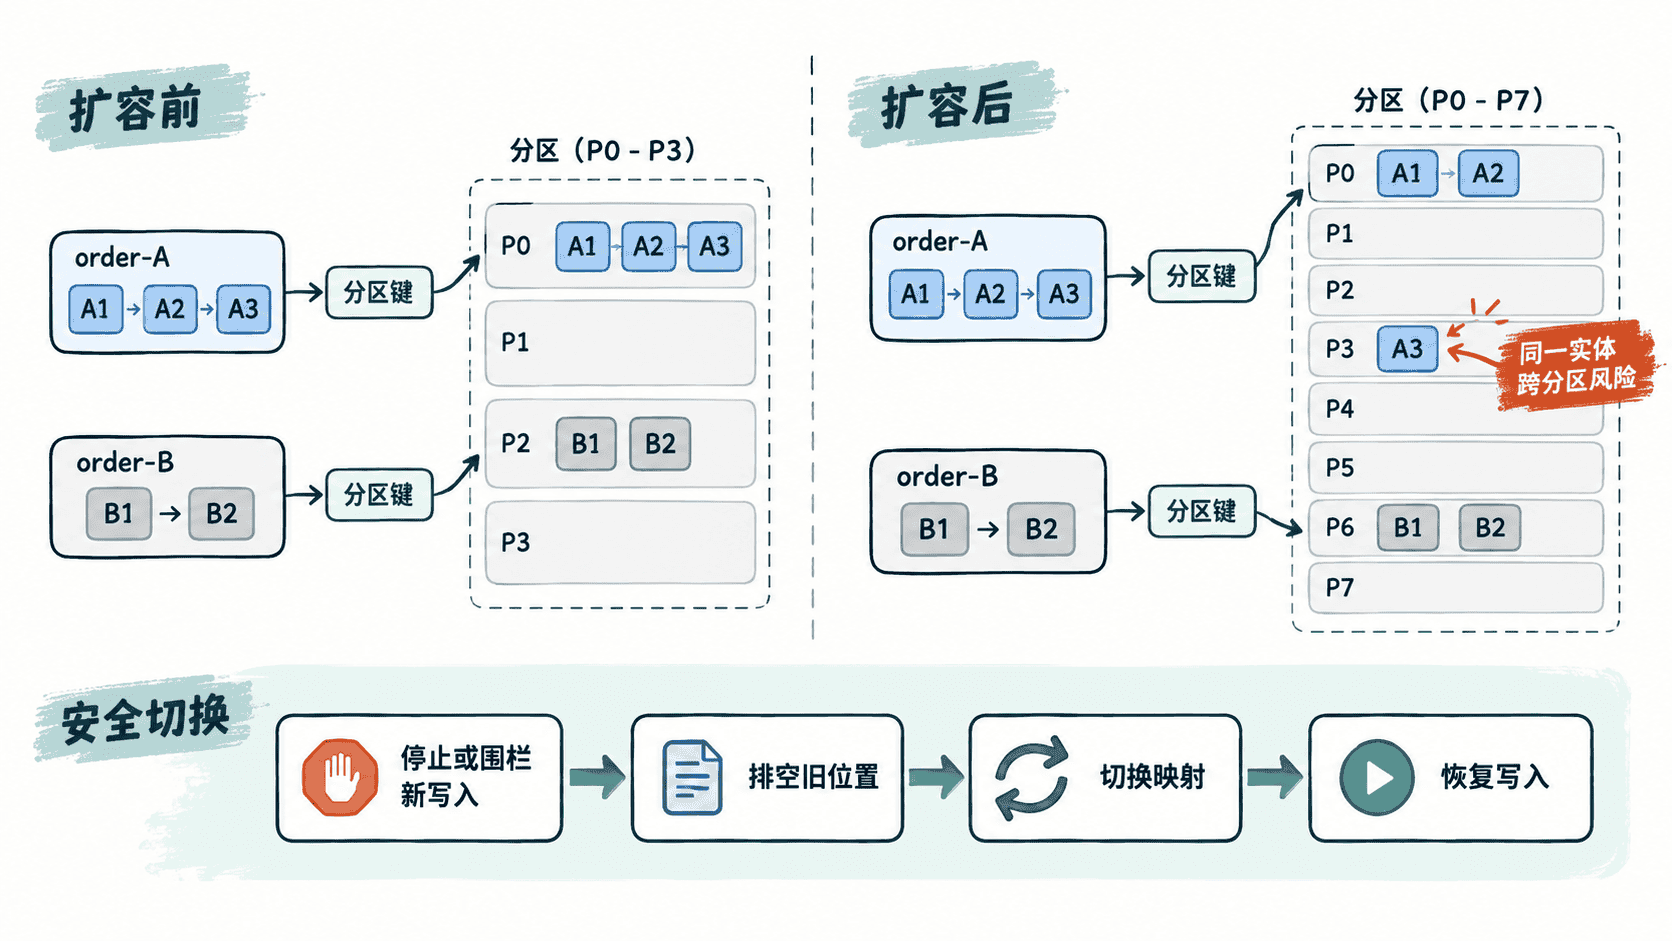
很多分区器可以抽象为“对键做哈希,再按分区数量取模”。如果分区数从 4 变成 8,旧记录不会搬家,但同一个键的新记录可能被映射到新分区。消费者同时读取两个分区时,就失去了这个实体原先的单分区顺序。
下面的可运行示例用 CRC32 演示这种变化。它不是某个消息系统的固定算法,只用于验证“分区数量参与映射时,扩容会改变部分键的目标分区”。
import zlib

keys = ["order-1001", "order-1002", "order-1003", "order-1004"]

def partition(key: str, count: int) -> int:
    return zlib.crc32(key.encode("utf-8")) % count

for count in (4, 8):
    mapping = [(key, partition(key, count)) for key in keys]
    print(f"{count} partitions: {mapping}")
预期输出
4 partitions: [('order-1001', 1), ('order-1002', 3), ('order-1003', 1), ('order-1004', 2)]
8 partitions: [('order-1001', 1), ('order-1002', 3), ('order-1003', 5), ('order-1004', 6)]
可以看到 order-1003 从分区 1 变到分区 5。若旧事件仍在分区 1 排队,而新事件已经进入分区 5,两个分区的消费速度不同就可能让新事件先到业务处理器。
设计不丢顺序的扩容方案
最简单且最可靠的方案是:需要强实体顺序的流,不把“原地增加分区”当成无成本操作。容量规划时预留足够分区;确需扩容时,把它当作一次数据迁移。
可采用受控切换流程:
- 给写入侧加切换门或围栏,阻止目标范围继续产生无版本的新事件。
- 记录旧分区的高水位或每个实体最后序列号,并让消费者追到该位置。
- 切换到新的分区映射或新主题版本,再恢复写入。
- 消费端同时校验实体序列号;发现重复时幂等丢弃,发现跳号时暂缓处理并触发补偿。
如果业务不能停写,可以给路由映射增加 epoch,让生产者在新 epoch 下写入,同时由消费者用旧 epoch 的完成标记做围栏。它能减少停顿,但需要维护双路由、完成检测和失败恢复,复杂度明显更高。
用序列号把保证落到消费端
分区只能提供传输层的局部顺序,业务端还应为关键实体携带单调递增的 sequence 或版本号。消费者保存已应用版本:收到小于等于当前值的事件视为重复;收到恰好加一的事件正常应用;收到更大的值说明中间可能缺失,应等待、重试或进入待修复队列。
这层校验尤其重要,因为重试、故障转移、跨分区迁移和下游并发都可能让“消息系统里的顺序”与“业务真正提交的顺序”出现差异。设计顺序时,先把保证范围缩到实体,再用稳定分区键维持局部顺序,最后用序列号验证业务不变量,才是可扩展又可审计的完整闭环。