
架构与系统设计 / 系统课时
用死信与重试队列隔离坏消息
用死信与重试队列隔离坏消息
本节要把一条处理失败的消息快速从主消费链路中移开,并根据错误是否可恢复决定延迟重试还是进入死信。最终你会得到一套有次数上限、可观察、可人工处置且不会让坏消息反复阻塞正常流量的路由规则。
学习目标
- 区分可恢复错误、永久失败与未知错误,决定重试还是死信。
- 设计主队列、延迟重试队列和死信队列之间的消息流。
- 为重试次数、延迟、死信处置和重新投递建立安全边界。
先按失败性质分流
消费失败后最危险的做法,是不区分原因地立即重试。数据库短暂超时、下游返回 503 这类错误通常可以恢复;字段缺失、签名无效、业务规则明确拒绝则不会因为等待几秒就变好。前者进入重试链路,后者应尽快进入死信。
无法确认性质的错误可以先按“有限重试”处理,但必须有次数上限。这样既给瞬时故障恢复机会,也不会让未知坏消息永久占用消费者。
把主链路与失败链路拆开
主队列只承载当前可处理的消息。可恢复失败发布到延迟重试队列,延迟到期后再回到消费入口;达到次数上限或确认永久失败时进入死信队列。消费者不要在主队列里长时间 sleep,否则一个坏消息会占住并发槽位并拖慢正常流量。
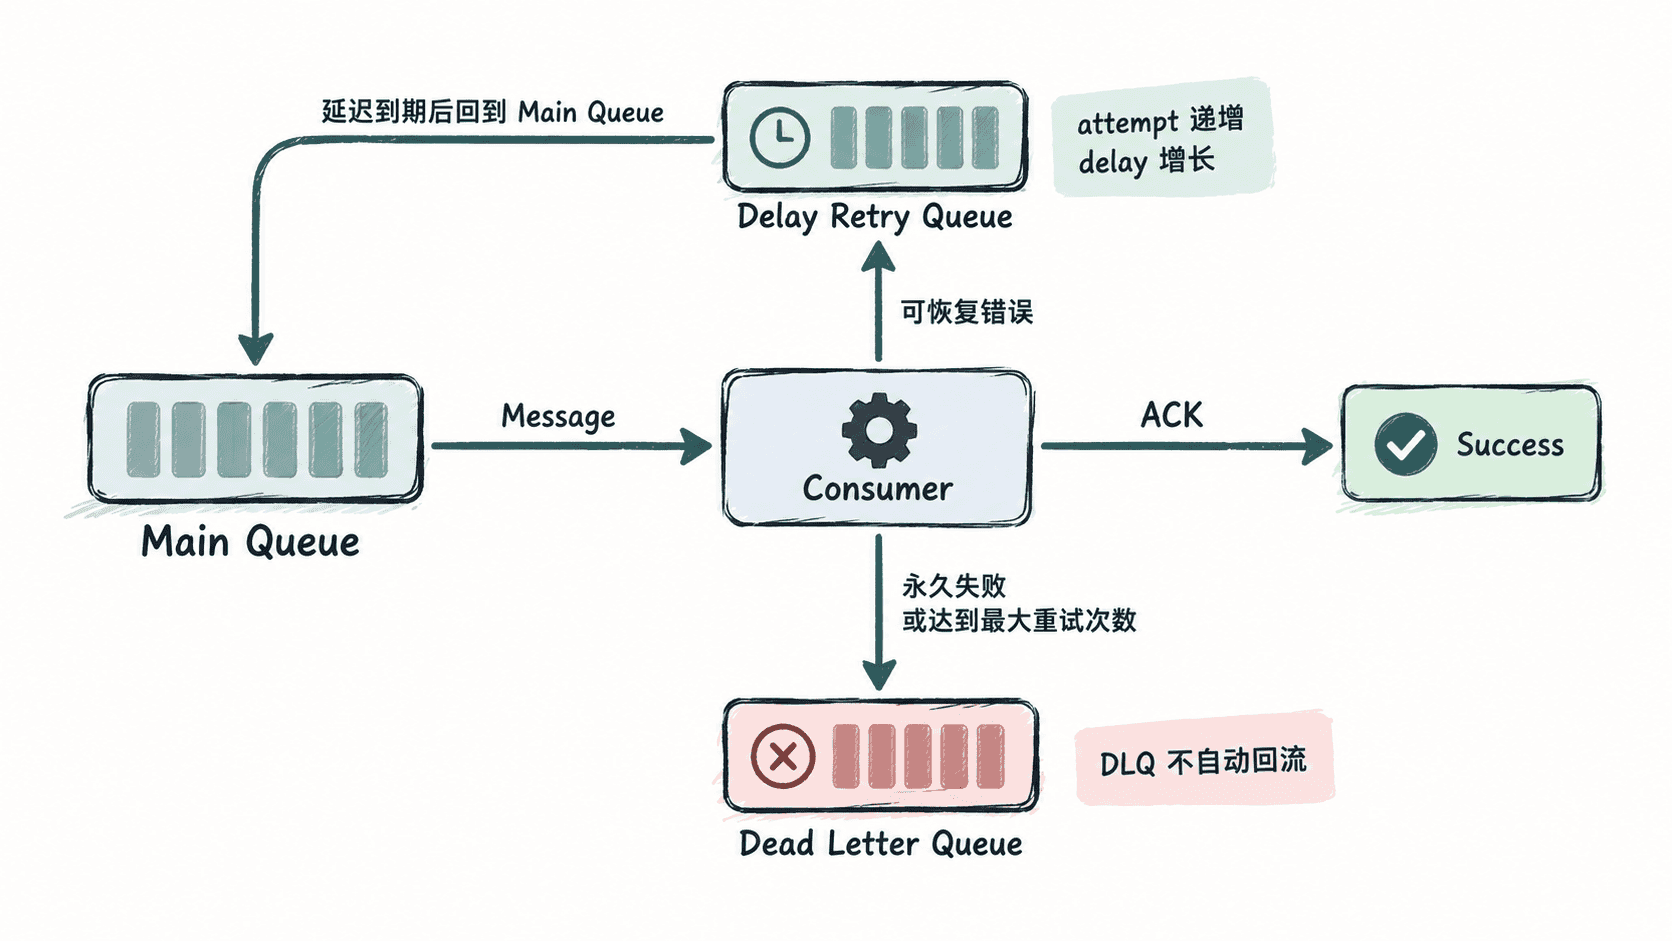
从主队列转移到重试队列时,先确认新消息已经可靠写入,再确认原消息。若中间存在崩溃窗口,就可能丢失或重复,因此生产实现要结合消息系统的事务、发布确认或等价机制,并让消费端保持幂等。
把路由规则写成可验证逻辑
下面的可运行示例用三种错误模拟路由决策:瞬时错误在第三次成功,格式错误直接死信,持续故障在达到上限后死信。真实系统会把 RETRY 对应为发布到延迟队列,把 DLQ 对应为发布到死信队列。
class RetryableError(Exception):
    pass

class PermanentError(Exception):
    pass

MAX_ATTEMPTS = 3

def consume(kind: str, attempt: int) -> None:
    if kind == "bad-schema":
        raise PermanentError("schema mismatch")
    if kind == "always-fail":
        raise RetryableError("dependency unavailable")
    if kind == "transient" and attempt < 3:
        raise RetryableError("temporary timeout")

def run(kind: str) -> None:
    attempt = 1
    while True:
        try:
            consume(kind, attempt)
            print(f"{kind}: ACK at attempt {attempt}")
            return
        except PermanentError as exc:
            print(f"{kind}: DLQ ({exc})")
            return
        except RetryableError as exc:
            if attempt >= MAX_ATTEMPTS:
                print(f"{kind}: DLQ after {attempt} attempts ({exc})")
                return

            delay_s = 2 ** (attempt - 1)
            print(f"{kind}: RETRY in {delay_s}s ({exc})")
            attempt += 1

for message_kind in ("transient", "bad-schema", "always-fail"):
    run(message_kind)
预期输出
transient: RETRY in 1s (temporary timeout)
transient: RETRY in 2s (temporary timeout)
transient: ACK at attempt 3
bad-schema: DLQ (schema mismatch)
always-fail: RETRY in 1s (dependency unavailable)
always-fail: RETRY in 2s (dependency unavailable)
always-fail: DLQ after 3 attempts (dependency unavailable)
实际的延迟可以使用分级队列,例如 5 秒、30 秒、5 分钟,也可以由调度能力直接指定下一次可见时间。无论实现方式如何,都要在消息元数据中保存 attempt、首次失败时间、最近错误和原始消息标识,避免重试历史丢失。
让死信队列可处置而不是只堆积
死信队列需要监控积压量、进入速率和主要错误原因,并为人工或自动处置保留足够上下文。至少要能回答:这条消息来自哪里、失败了几次、最后一次为什么失败、修复后是否允许重新投递。
重新投递死信前,应先修复根因并确认消费者仍具幂等性。不要配置“DLQ 自动无限回主队列”的闭环,否则只是把永久失败重新包装成重试风暴。一个可靠的终点是:正常消息持续前进,可恢复故障有限重试,永久失败被隔离且能够被观察、修复和审计。