
机器学习与深度学习 / 系统课时
理解激活函数如何增加表达力
理解激活函数如何增加表达力
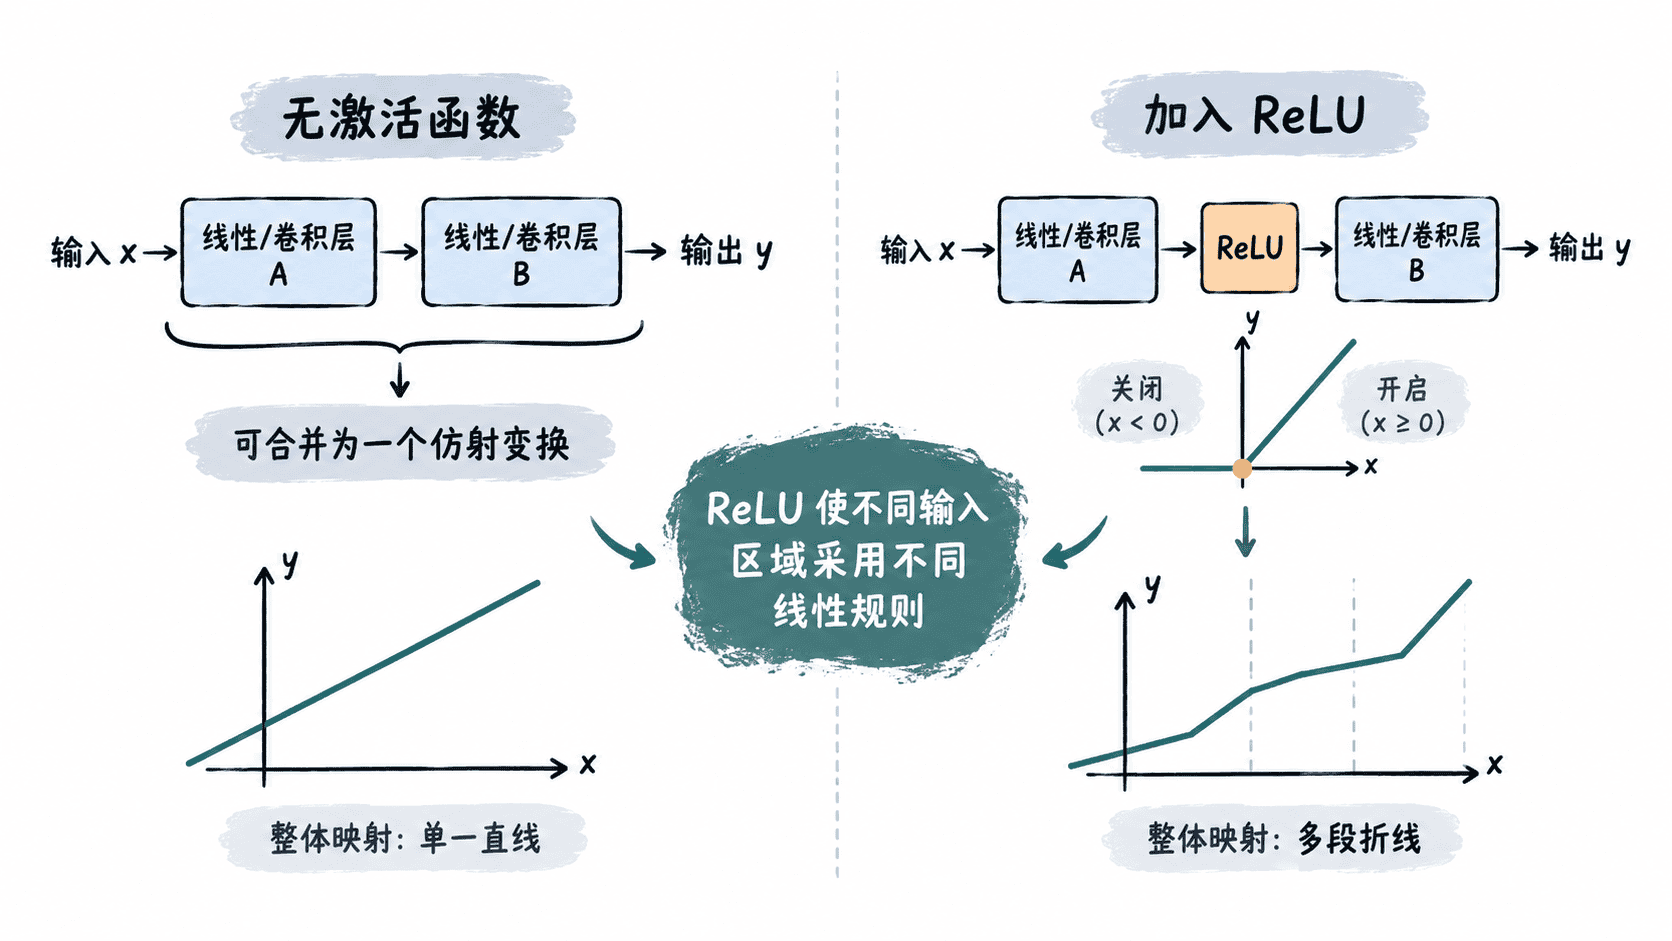
连续堆叠卷积层看起来已经很深,但如果层与层之间只有线性或仿射运算,再多层也能合并成一次同类运算。ReLU 的作用就是在这些变换之间加入非线性,让网络能够根据输入所在区域采用不同响应规则,从而表示更复杂的图像模式。
学习目标
- 理解没有激活函数时多层网络为何仍等价于单层仿射变换
- 理解 ReLU 的分段线性机制如何引入非线性
- 判断 ReLU 带来的表达能力以及需要注意的边界
没有激活函数时深度会失去意义
先看两个连续的仿射变换。第一层输出为:
第二层继续计算:
把第一式代入第二式:
令 、,就得到 。也就是说,两层仿射变换仍然可以压缩成一层。继续堆叠十层、几十层,只要中间没有非线性,这个结论仍然成立。
卷积本身同样属于线性运算,加入 Bias 后属于仿射变换。因此“卷积接卷积接卷积”并不会自动获得复杂的非线性表达能力。
ReLU 在零点把规则分成两段
ReLU 定义非常简单:
当输入为正时,它原样保留;当输入为负时,它输出 0。因此同一个神经元会根据输入符号进入两种不同状态。
| 输入 | -2 | -1 | 0 | 1 | 2 |
|---|---|---|---|---|---|
| 线性输出 | -2 | -1 | 0 | 1 | 2 |
| ReLU 输出 | 0 | 0 | 0 | 1 | 2 |
ReLU 的每一段本身都是线性的,但整个函数不是单一线性函数,所以它被称为分段线性非线性函数。
非线性让不同特征可以条件式组合
加入 ReLU 后,两层网络变成:
此时已经不能简单把 与 合并。原因是 ReLU 会根据 的符号决定哪些中间特征保留、哪些被置零,而这个决定会随输入改变。
放到 CNN 中,可以把一个中间通道理解为某种局部特征响应。某位置没有触发对应模式时,ReLU 可以把负响应截断为 0;触发后则把正响应继续传递。下一层于是可以基于“哪些特征当前被激活”重新组合信息。
随着网络变深,大量 ReLU 会把输入空间划分成许多区域。网络在每个区域内部仍执行线性或仿射计算,但不同区域能够使用不同的有效计算路径。正是这种分段组合,使网络能够逼近比单一线性映射复杂得多的函数。
ReLU 为什么在 CNN 中常用
ReLU 的优势首先是计算简单,只需要判断正负;在正区间其梯度为 1,也不像 Sigmoid 那样在较大的正负输入处都容易进入梯度很小的饱和区。因此它长期以来是卷积网络中最常见的激活函数之一。
但 ReLU 也有边界:当某个单元长期落在负区间时,输出恒为 0,该区间的梯度也为 0,参数可能难以重新恢复有效响应。这通常被称为“死亡 ReLU”。合理的初始化、学习率以及 Leaky ReLU 等变体可以降低这种风险。
理解激活函数时最重要的不是记住“负数变零”,而是抓住结构上的变化:没有激活函数,多层卷积仍可折叠成一次仿射变换;插入 ReLU 后,不同输入区域能够走不同的分段线性规则,网络深度才真正转化为更强的表达能力。