
机器学习与深度学习 / 系统课时
用深度可分离卷积降低计算量
用深度可分离卷积降低计算量
标准卷积同时完成空间特征提取和通道混合,计算量会随输入通道、输出通道一起增长。本节把这两件事拆开,量化 depthwise separable convolution 的参数量与 MACs,并说明为什么“理论更省”不一定等于“设备上更快”。
学习目标
- 写出标准卷积与深度可分离卷积的参数量、MACs 计算式
- 解释 depthwise 与 pointwise 两阶段各自负责什么
- 判断计算量下降能否转化为真实部署延迟收益
标准卷积为什么昂贵
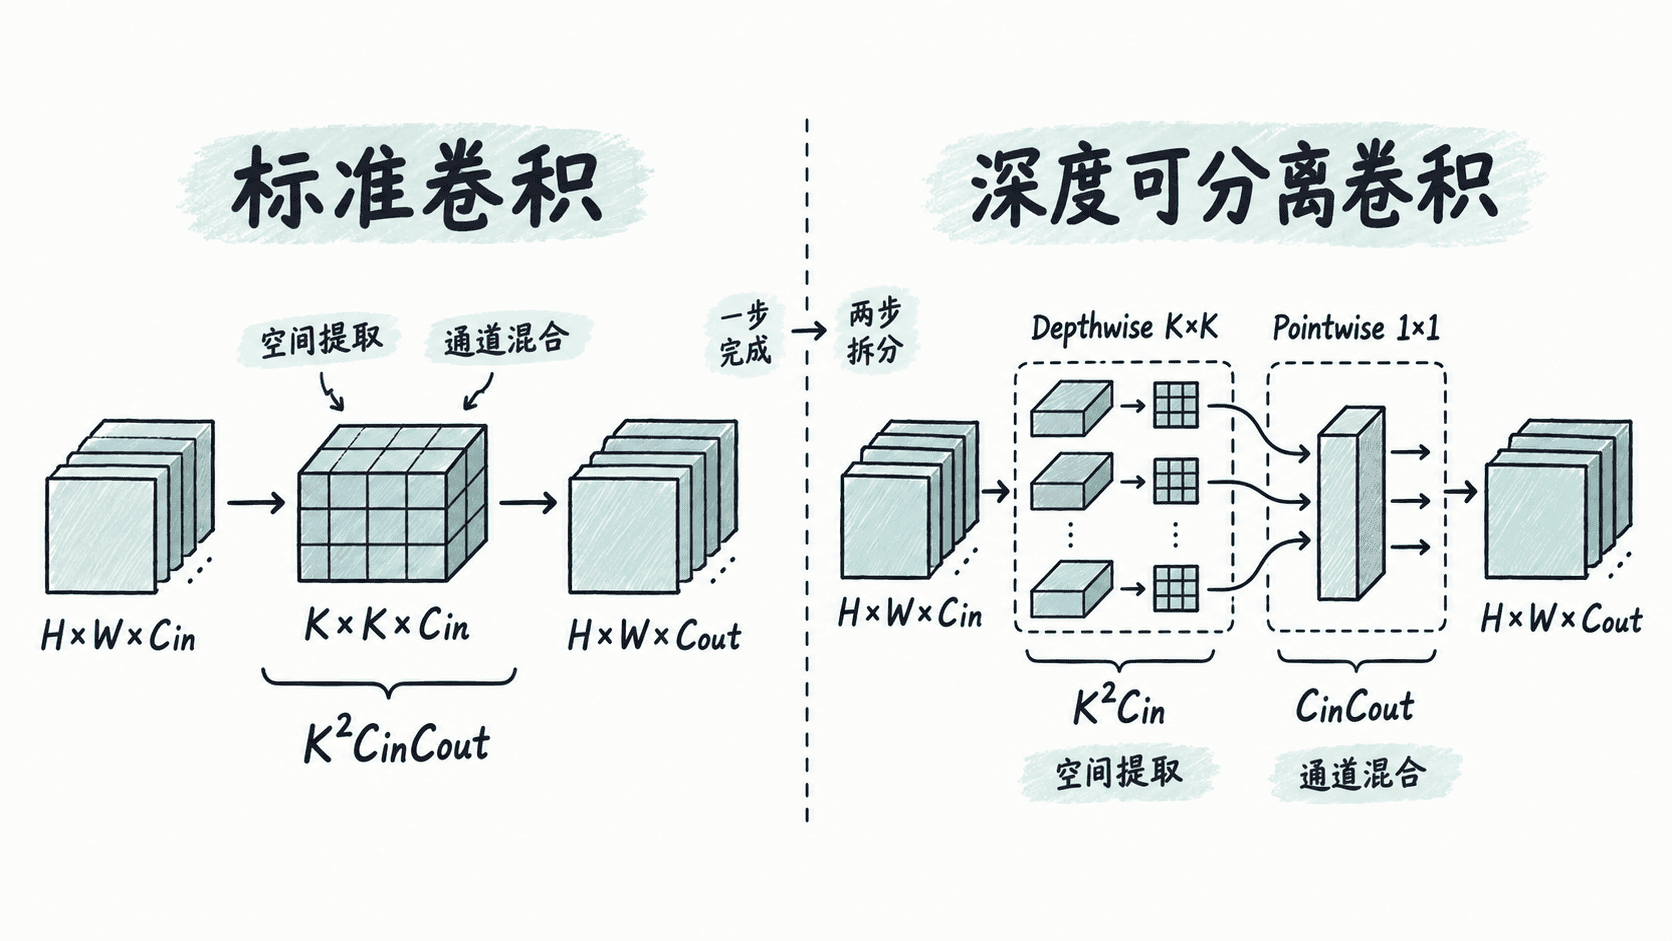
设输出特征图大小为 ,输入通道数为 ,输出通道数为 ,卷积核为 。忽略 bias 时,标准卷积每个输出通道都要读取全部输入通道,因此参数量为 。
对应的乘加次数 MACs 近似为 。真正让计算迅速变大的不是单独的空间卷积,而是空间核、输入通道和输出通道三者相乘。
把空间卷积和通道混合拆开
深度可分离卷积把标准卷积拆成两步。这里假设 depth multiplier 为 1:depthwise convolution 对每个输入通道各自做一个 卷积,只处理空间关系;随后 pointwise convolution 用 卷积把不同通道重新组合成 个输出通道。
它的参数量变为 ,MACs 近似为 。第一项负责空间提取,第二项负责通道混合,因此没有丢掉这两类基本能力,只是把原本一次完成的运算解耦了。
用一组尺寸量化节省比例
下面固定输出空间为 ,令 、、。示例只计算权重参数和 MACs,不计 bias、归一化、激活与内存访问开销,因此适合比较卷积结构本身。
def conv_cost(h, w, cin, cout, k):
    # 标准卷积:每个输出通道连接全部输入通道
    standard_params = k * k * cin * cout
    standard_macs = h * w * standard_params

    # 深度卷积负责空间,1x1 卷积负责通道混合
    separable_params = k * k * cin + cin * cout
    separable_macs = h * w * separable_params
    return standard_params, separable_params, standard_macs, separable_macs

std_p, sep_p, std_m, sep_m = conv_cost(112, 112, 32, 64, 3)
print(f"standard params: {std_p}")
print(f"separable params: {sep_p}")
print(f"param reduction: {std_p / sep_p:.2f}x")
print(f"standard MACs: {std_m}")
print(f"separable MACs: {sep_m}")
print(f"MAC reduction: {std_m / sep_m:.2f}x")
预期输出
standard params: 18432
separable params: 2336
param reduction: 7.89x
standard MACs: 231211008
separable MACs: 29302784
MAC reduction: 7.89x
在这个例子里,参数量与 MACs 都缩小到原来的约八分之一。对常见的 卷积,当输出通道数较大时,理论节省比例会逐渐接近 9 倍,因为 pointwise 部分最终成为主要开销。
理论 MACs 少不代表延迟同比下降
实际设备还受内存带宽、算子实现、张量布局和并行度影响。depthwise convolution 的算术强度较低,有些硬件对它的优化不如密集卷积充分,所以不能把“MACs 减少 8 倍”直接解释成“推理快 8 倍”。
部署时应在目标设备、目标精度和真实输入尺寸上同时记录端到端延迟、峰值内存与能耗。若 pointwise 已占据大部分耗时,继续压缩 depthwise 部分收益很小,此时缩减通道宽度、调整分辨率或选择更合适的算子实现通常更有效。