
机器学习与深度学习 / 系统课时
理解 VGG 堆叠小卷积的代价
理解 VGG 堆叠小卷积的代价
本篇用 VGG 的核心设计回答两个问题:为什么连续堆叠 3×3 卷积能替代更大的卷积核,以及这种做法为什么仍然会变得很昂贵。你将从感受野、参数量、计算量和训练期激活显存四个角度判断“加深网络”到底省了什么、又付出了什么。
学习目标
- 计算连续
3×3卷积形成的有效感受野 - 比较小卷积堆叠与单个大卷积的参数和计算成本
- 识别 VGG 式深层网络的显存与计算瓶颈
小卷积如何扩大感受野
在步幅 1、无空洞卷积的情况下,一个 3×3 卷积让某个输出位置看到输入的 3×3 区域;再叠一层后,有效感受野扩大到 5×5;三层则达到 7×7。因此,两层 3×3 可以覆盖与一层 5×5 相同的空间范围,同时在中间多插入一次非线性变换。
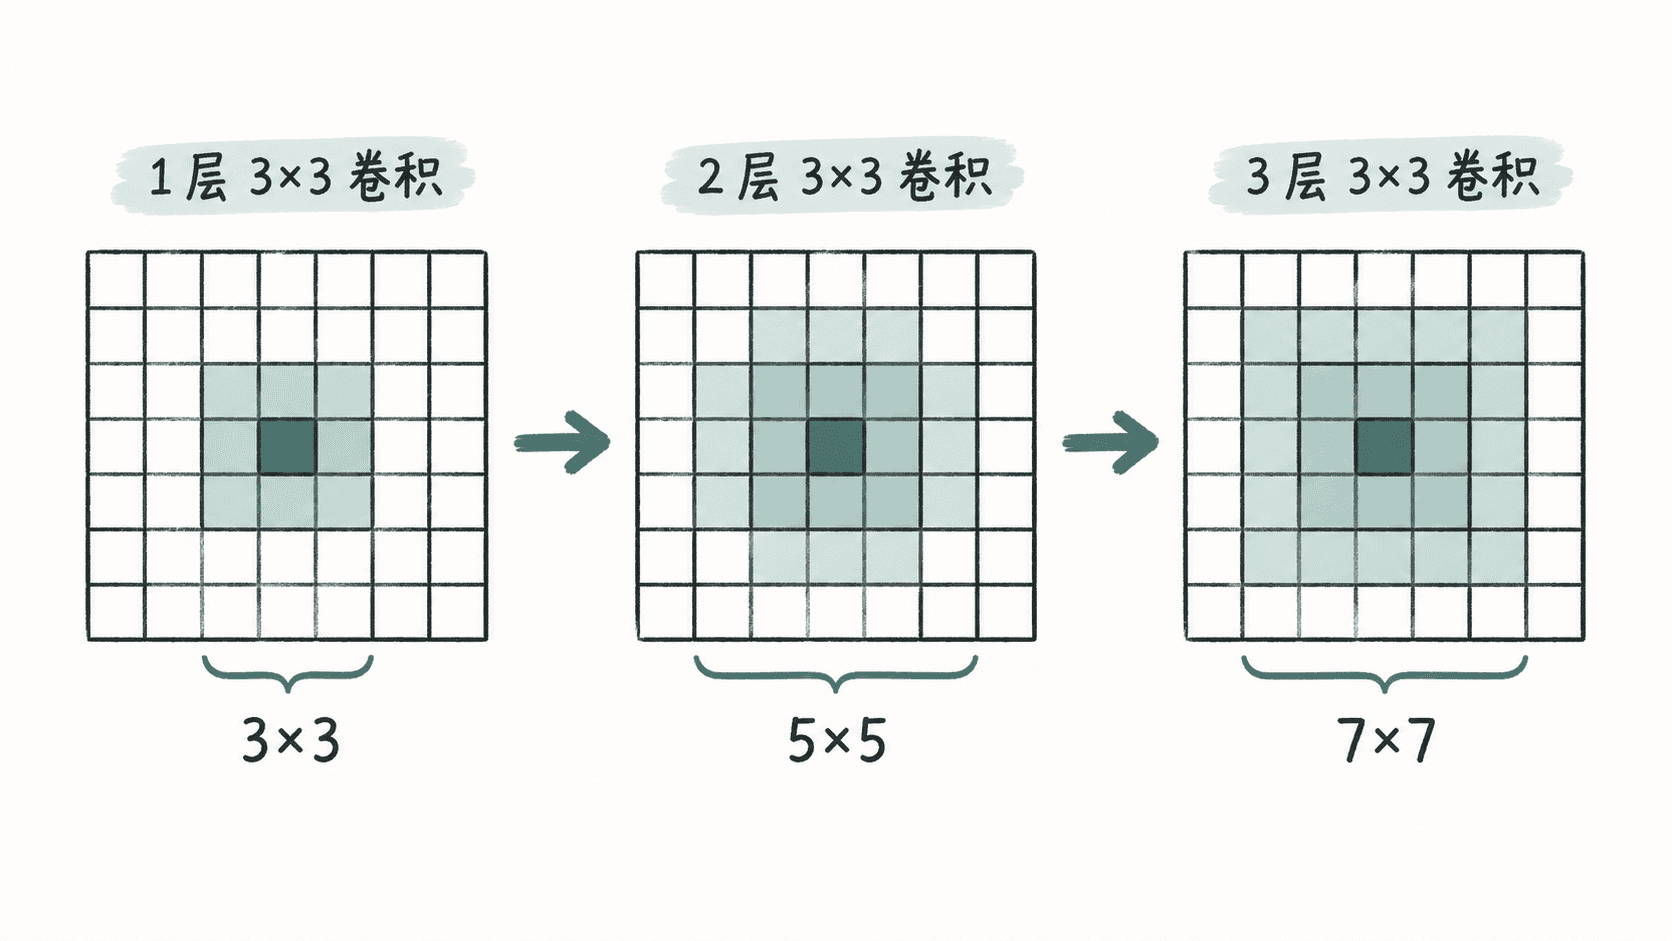
感受野边长的递推可以写成:
这里 R 是感受野,J 是相邻特征点在原输入上的间隔。连续使用步幅 1 的 3×3 卷积时,J=1,所以感受野边长每层增加 2。
参数更少不等于代价很小
假设输入和输出都保持为 C 个通道,并忽略偏置。一个 5×5 卷积需要 25C² 个参数,而两个 3×3 卷积需要 18C² 个参数,只是前者的 72%。类似地,三个 3×3 达到 7×7 感受野时需要 27C² 个参数,而一个 7×7 需要 49C²。
但卷积计算量还要乘上特征图面积。只要网络在较大的 H×W 特征图上维持很多通道,即使单层卷积核很小,乘加次数仍会迅速累积。VGG 的代价来自“很多层 × 较大特征图 × 较多通道”,而不是某一个卷积层异常昂贵。
下面用一个固定为 64 通道的例子计算参数量、感受野和单张 FP32 激活大小。
c = 64
h = w = 224

# 在输入、输出通道均为 64 时比较同等感受野的卷积方案。
params_5x5 = 25 * c * c
params_two_3x3 = 2 * 9 * c * c
params_7x7 = 49 * c * c
params_three_3x3 = 3 * 9 * c * c

# 这里只计算一个特征张量本身,不包含梯度和优化器状态。
activation_mib = h * w * c * 4 / (1024 ** 2)

print(f"two 3x3 RF=5, params={params_two_3x3}")
print(f"one 5x5  RF=5, params={params_5x5}")
print(f"three 3x3 RF=7, params={params_three_3x3}")
print(f"one 7x7  RF=7, params={params_7x7}")
print(f"224x224x64 FP32 activation={activation_mib:.2f} MiB")
预期输出
two 3x3 RF=5, params=73728
one 5x5  RF=5, params=102400
three 3x3 RF=7, params=110592
one 7x7  RF=7, params=200704
224x224x64 FP32 activation=12.25 MiB
显存压力来自中间激活
推理时,一层产生的中间特征通常可以较快释放;训练时,为了反向传播,需要保存多层激活或能重建它们的信息。上例中单个 224×224×64 的 FP32 激活就约 12.25 MiB,多层连续卷积会保存多个中间结果,批量大小再乘上去后,显存增长非常明显。
参数显存和激活显存也要分开看。VGG 式网络前部的卷积层常由大尺寸激活主导显存,而经典 VGG 的尾部全连接分类器又会引入大量参数。仅看“卷积核从 5×5 换成两个 3×3,参数减少了”不足以判断整网是否高效。
加深网络时要同时看四本账
评估一个 VGG 式改动时,应同时检查感受野、参数量、计算量和激活显存。堆叠小卷积的优势是真实的:同等感受野下参数更少,而且增加非线性层数;它的限制也同样真实:层数增加后,每一层都要执行计算,并在训练阶段产生需要保留的中间激活。
因此,VGG 的历史价值不在于“越深越好”,而在于证明了规则化的小卷积堆叠可以稳定构建深层视觉网络。后续更高效的 CNN 设计会继续解决这里暴露出的成本问题,例如减少高分辨率阶段的通道和计算、使用瓶颈结构或更轻量的卷积方式。