
机器学习与深度学习 / 系统课时
从训练曲线识别拟合问题
从训练曲线识别拟合问题
训练曲线的价值不只是判断“指标有没有变好”,而是把训练集和验证集放在同一时间轴上,识别模型容量、优化过程与泛化能力之间的矛盾。本节会建立一套固定诊断顺序,并用最小脚本复现典型过拟合信号。
学习目标
- 根据训练集与验证集的损失、准确率走势区分欠拟合、过拟合、优化停滞和训练波动
- 用验证损失最低点和训练验证差距定位问题开始出现的位置
- 按固定顺序选择增大容量、调整优化器、正则化或数据改进方案
先看四类曲线信号
单看训练准确率很容易误判。诊断时至少同时观察训练损失、验证损失、训练准确率和验证准确率,并关注“趋势是否一致”以及“差距从哪个 epoch 开始扩大”。
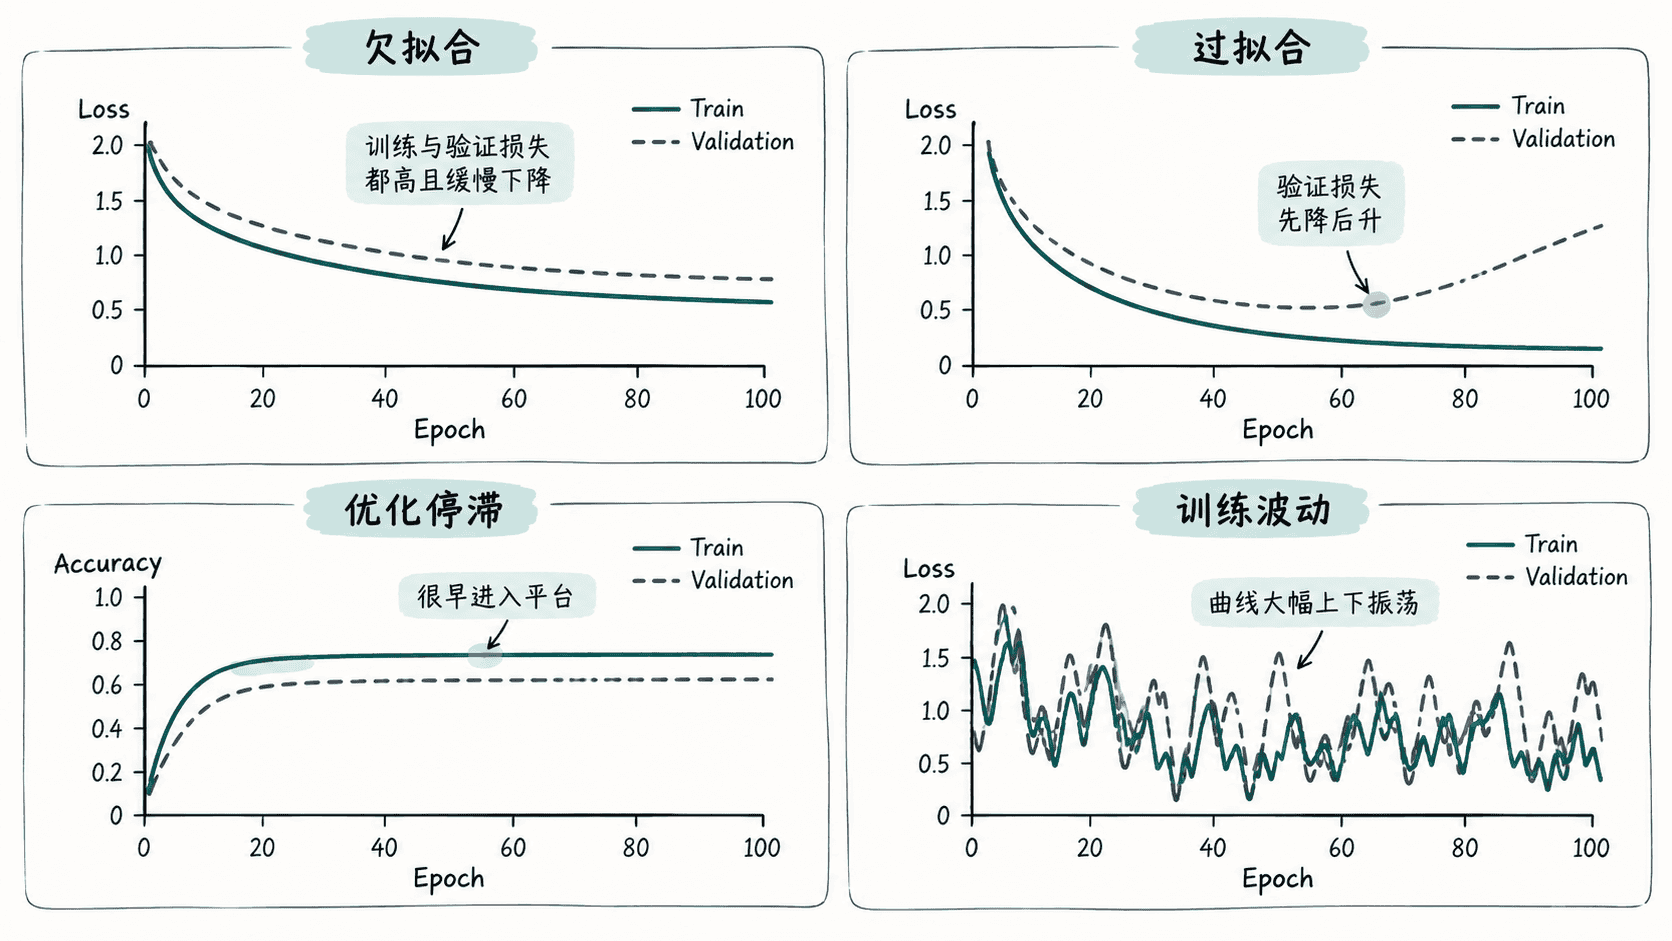
| 现象 | 典型曲线 | 优先怀疑 |
|---|---|---|
| 欠拟合 | 训练与验证都差,且两者接近 | 模型容量不足、训练不足、特征不足 |
| 过拟合 | 训练继续变好,验证先好后坏 | 正则化不足、数据量不足、训练过久 |
| 优化停滞 | 损失很早进入平台,准确率不再提升 | 学习率不合适、梯度问题、优化器设置 |
| 训练波动 | 损失和准确率频繁大幅振荡 | 学习率过大、小批量噪声、数据异常 |
用最小脚本复现诊断
下面的完整示例构造一组典型过拟合曲线,并打印验证损失最低的 epoch 与最后一个 epoch 的准确率差距。真实训练时,只需把数组替换为框架记录的 history 数据。
python
import numpy as np
import matplotlib.pyplot as plt

epochs = np.arange(1, 7)
train_loss = np.array([1.20, 0.90, 0.65, 0.45, 0.30, 0.20])
val_loss = np.array([1.18, 0.86, 0.68, 0.72, 0.84, 1.02])
train_acc = np.array([0.52, 0.65, 0.76, 0.84, 0.90, 0.94])
val_acc = np.array([0.50, 0.62, 0.74, 0.73, 0.70, 0.66])

best_epoch = int(np.argmin(val_loss) + 1)
final_gap = float(train_acc[-1] - val_acc[-1])

fig, axes = plt.subplots(1, 2, figsize=(10, 4))
axes[0].plot(epochs, train_loss, marker='o', label='train')
axes[0].plot(epochs, val_loss, marker='o', label='validation')
axes[0].set_title('Loss')
axes[0].set_xlabel('Epoch')
axes[0].legend()

axes[1].plot(epochs, train_acc, marker='o', label='train')
axes[1].plot(epochs, val_acc, marker='o', label='validation')
axes[1].set_title('Accuracy')
axes[1].set_xlabel('Epoch')
axes[1].legend()

plt.tight_layout()
plt.show()

print(f'best validation epoch: {best_epoch}')
print(f'final accuracy gap: {final_gap:.2f}')
预期输出
text
best validation epoch: 3
final accuracy gap: 0.28
图中验证损失在第 3 个 epoch 后反弹,而训练损失仍持续下降;同时训练与验证准确率差距扩大到 0.28。这是一组比“验证准确率下降”更完整的过拟合证据。
按固定顺序排除误判
遇到异常曲线时,不要直接改模型结构。先确认训练集和验证集的预处理一致,验证集没有参与数据增强或标签映射错误;再检查横轴是否对应同一训练轮次,指标是否按相同方式计算。
随后按现象继续定位:欠拟合先确认训练是否足够,再考虑增加模型容量;优化停滞先检查学习率和梯度;训练波动先降低学习率、增大 batch 或检查异常样本;只有出现稳定的训练验证分叉时,才优先处理过拟合。
把诊断结果映射到调整动作
过拟合时,常见动作是早停、权重衰减、Dropout、更合理的数据增强或补充数据。欠拟合则可能需要更强的特征提取能力、更长训练或更合适的输入分辨率。优化停滞和波动更应从学习率、调度器、归一化和数据质量入手,而不是盲目增加正则化。
训练曲线提供的是“问题属于哪一类”的证据,不是最终根因。稳定的做法是先用曲线缩小范围,再结合错误样本、混淆矩阵和梯度等证据验证假设。
按自己的节奏,确认真正理解。