
机器学习与深度学习 / 系统课时
设计增强策略提升模型泛化
设计增强策略提升模型泛化
图像增强不是把样本“变得越多越好”,而是用不会改变标签含义的随机变换扩展训练分布。本节用裁剪、翻转和颜色扰动构建一套可执行的训练增强,并说明哪些变换应该拒绝,以及如何通过固定验证集的对照实验确认增强确实改善泛化。
学习目标
- 能把增强拆成几何变化、颜色变化和标准化,并只放在训练数据管线中。
- 能根据标签语义判断某个变换是否安全,而不是机械套用增强列表。
- 能用同一数据划分和训练设置做消融对照,判断增强是否带来真实验证收益。
从标签语义反推增强边界
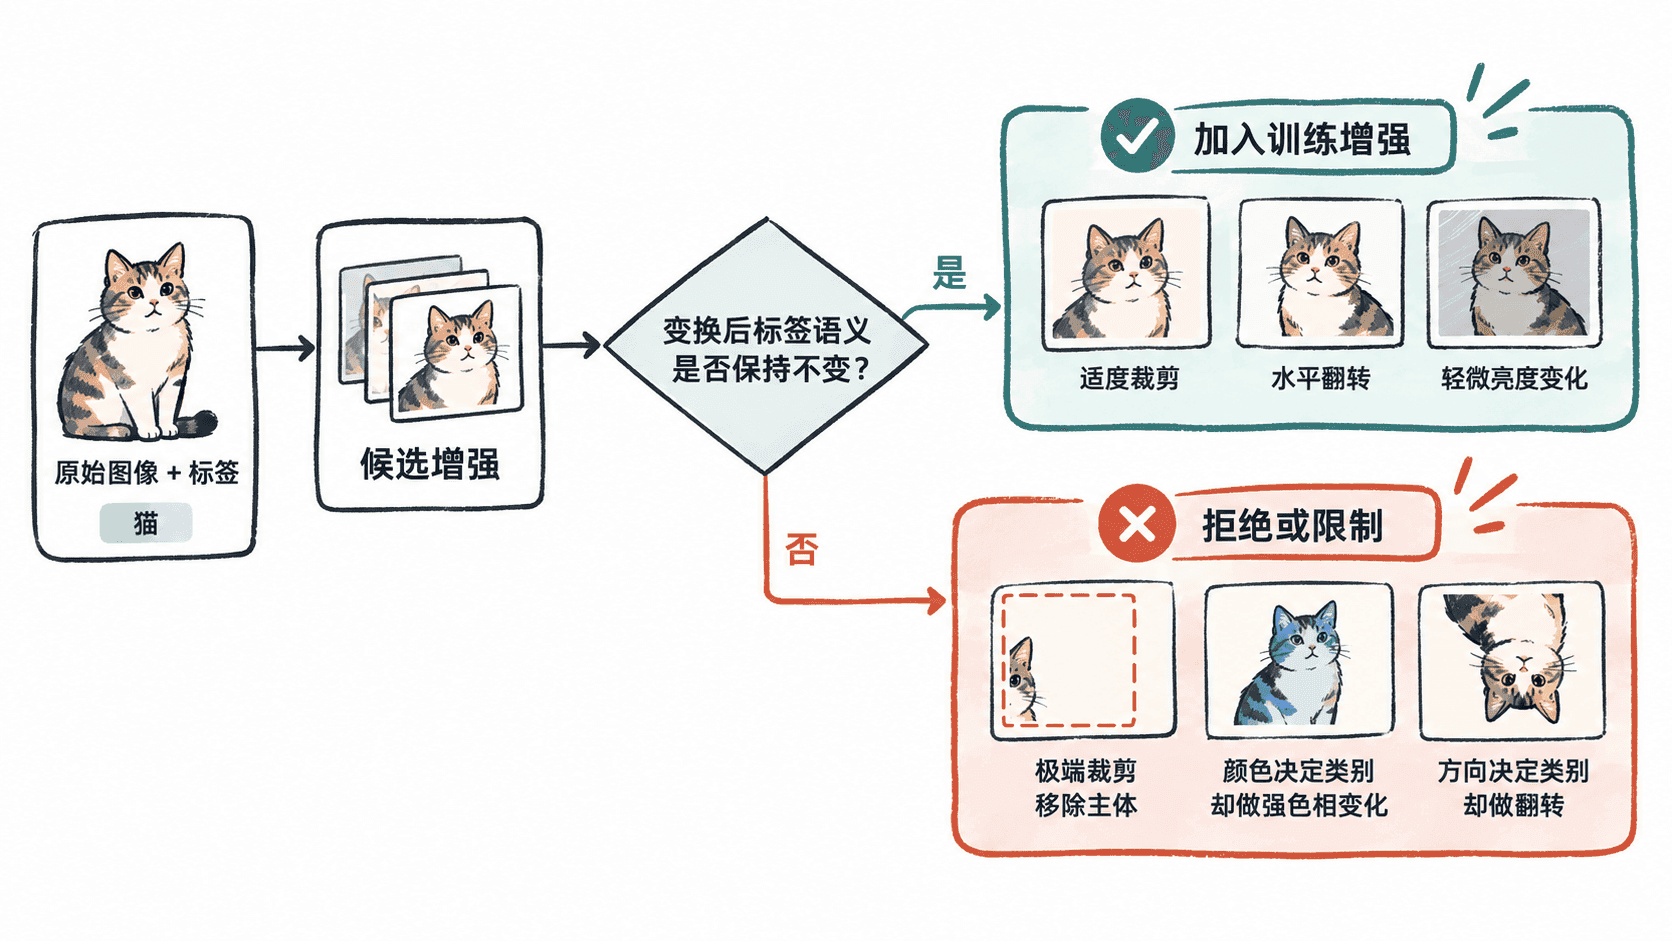
增强是否合理,判断标准只有一个:变换后,人类是否仍会给出同一个标签。普通物体分类中,适度随机裁剪、水平翻转和轻微颜色抖动通常能模拟拍摄位置、视角和光照变化;但极端裁剪可能把主体完全移出画面,强烈色相变化也可能破坏依赖颜色区分类别的任务。
方向本身也是语义的一部分时要更谨慎。例如区分左转与右转标志时,水平翻转会直接改变类别;识别数字 6 与 9 时,旋转也可能改变含义。增强策略必须服从具体任务,而不能从别的项目原样复制。
构建训练与验证两套预处理
训练集需要随机性,验证集则必须稳定。否则每次验证都在看不同输入,指标波动会掩盖模型本身的变化。下面使用 torchvision.transforms 构造两套预处理,并对同一张合成图像重复增强,验证输出尺寸保持一致。
import torch
from PIL import Image
from torchvision import transforms

torch.manual_seed(7)

train_transform = transforms.Compose([
    transforms.RandomResizedCrop(224, scale=(0.7, 1.0)),
    transforms.RandomHorizontalFlip(p=0.5),
    transforms.ColorJitter(
        brightness=0.2,
        contrast=0.2,
        saturation=0.2
    ),
    transforms.ToTensor(),
    transforms.Normalize(
        mean=[0.485, 0.456, 0.406],
        std=[0.229, 0.224, 0.225]
    ),
])

eval_transform = transforms.Compose([
    transforms.Resize(256),
    transforms.CenterCrop(224),
    transforms.ToTensor(),
    transforms.Normalize(
        mean=[0.485, 0.456, 0.406],
        std=[0.229, 0.224, 0.225]
    ),
])

image = Image.new("RGB", (320, 240), color=(120, 160, 200))

for i in range(3):
    tensor = train_transform(image)
    print(f"train_{i}: shape={tuple(tensor.shape)}")

eval_tensor = eval_transform(image)
print(f"eval: shape={tuple(eval_tensor.shape)}")
预期输出
train_0: shape=(3, 224, 224)
train_1: shape=(3, 224, 224)
train_2: shape=(3, 224, 224)
eval: shape=(3, 224, 224)
三次训练张量尺寸相同,但随机裁剪、翻转和颜色扰动的具体结果可能不同。验证预处理没有随机增强,因此同一输入应得到稳定结果。
用强度而不是数量控制增强
增强过弱时,模型看到的训练分布几乎没有变化;增强过强时,输入会偏离真实数据,甚至破坏标签。小样本任务适合从少量、可解释的变换开始,再一次只增加一种变化,例如先加入裁剪和翻转,再观察颜色扰动是否继续带来收益。
对迁移学习模型还要保持输入尺寸和标准化与预训练权重要求一致。几何与颜色增强发生在标准化之前,标准化负责把最终张量映射到模型熟悉的数值分布。
用消融实验确认泛化收益
判断增强是否有效时,只改变增强策略,其余条件保持一致:训练/验证划分相同、随机种子相同、骨干和解冻范围相同、优化器与训练轮数相同。先训练无增强基线,再训练增强版本,比较最佳验证指标以及训练集与验证集之间的差距。
如果增强版训练准确率略低但验证准确率更高,通常说明模型减少了对训练样本细节的记忆,泛化能力变好;如果训练和验证都明显下降,说明增强过强或不符合真实分布;如果验证指标几乎不变,则继续堆叠更多变换的价值有限。
增强策略的目标不是制造“更难”的图片,而是覆盖部署时可能出现、同时又不改变标签语义的合理变化。先从最可信的变换开始,再用固定验证集做对照,是小样本分类中比盲目增加增强种类更可靠的做法。