
机器学习与深度学习 / 系统课时
选择下采样位置避免信息丢失
选择下采样位置避免信息丢失
下采样可以迅速降低特征图尺寸,从而减少计算量和显存占用,但位置安排不当会在网络尚未提取稳定局部特征前丢掉细节。本节比较过早与延后下采样的代价,并给出根据输入分辨率和任务目标安排降采样阶段的方法。
学习目标
- 理解下采样位置对细节保留、计算量和感受野的共同影响
- 能比较早期下采样与延后下采样的适用场景
- 能根据目标尺寸和输入分辨率设计合理的降采样节奏
下采样同时改变三件事
把特征图从 缩小到 ,空间位置数量会降为原来的四分之一。后续卷积因此通常明显更省计算和显存,同时相邻特征点对应到输入中的间距变大,使感受野增长得更快。
代价是空间细节不可逆地减少。尤其在网络最前面,边缘、细线、小目标等信息还没有被编码成稳定的高层特征。如果此时连续使用大步幅卷积或池化,后续层即使增加通道,也无法恢复已经被采样丢掉的位置关系。
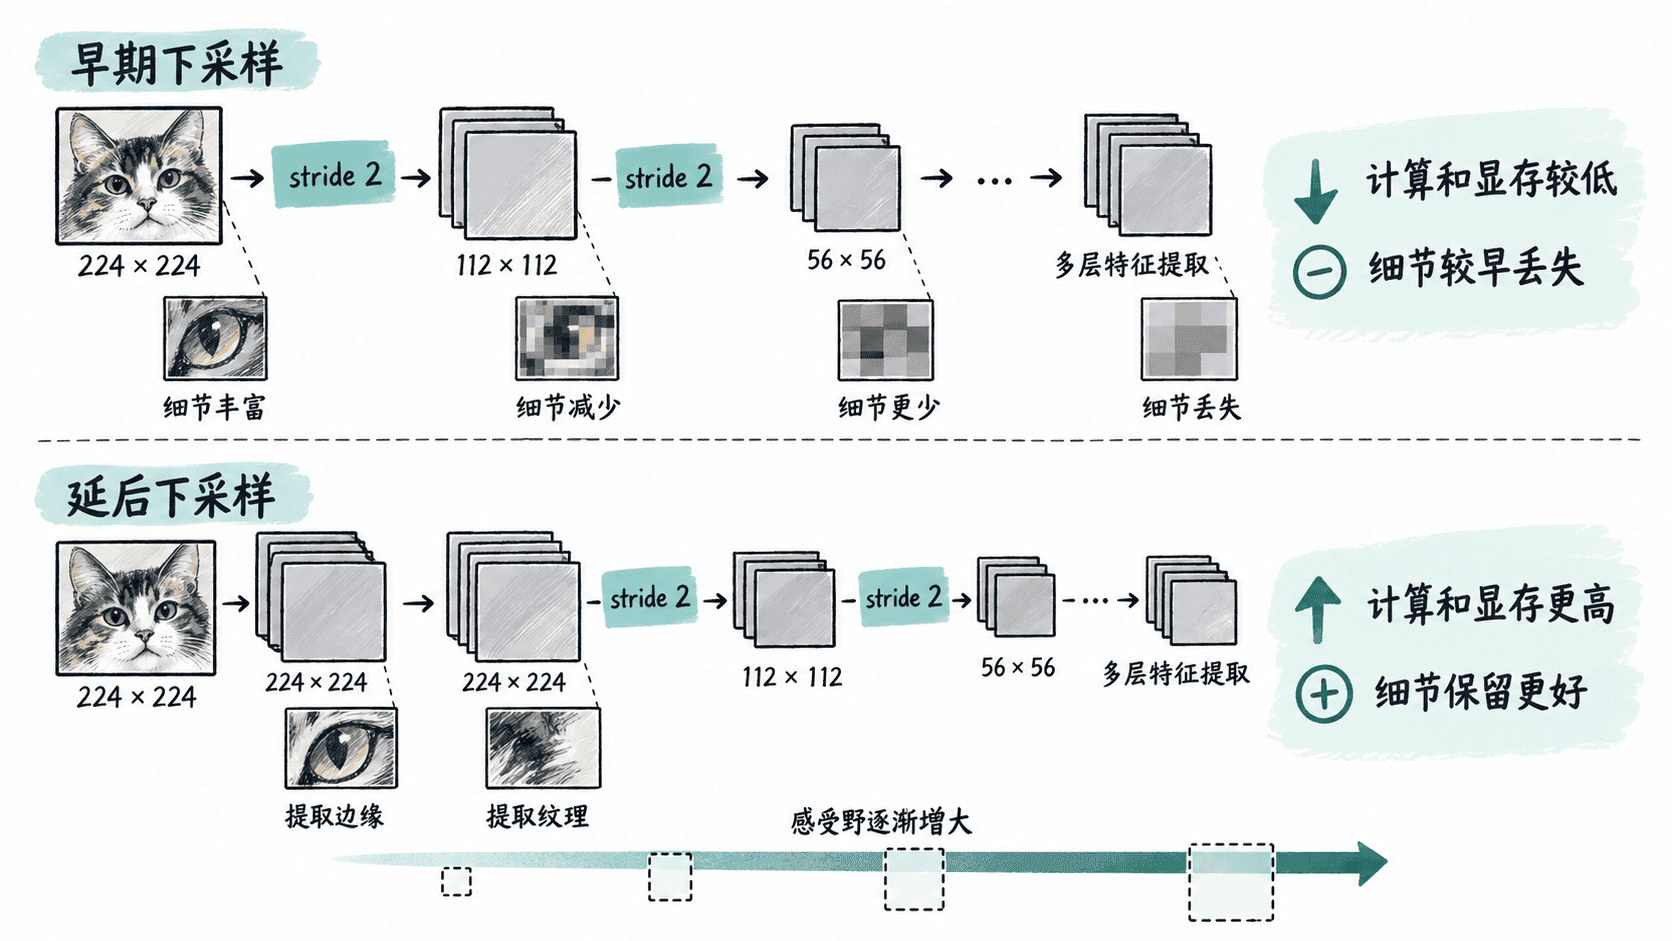
量化早下采样带来的计算优势
可以先用空间位置总数作为激活规模的粗略代理。假设两个网络最终都降到 56×56,但一个较早降采样,另一个在高分辨率上保留更多层:
early_downsample = [112, 56, 56, 56]
late_downsample = [224, 224, 112, 56]

def spatial_footprint(sizes):
    # 这里只比较空间位置数量,不包含通道数、梯度和优化器状态。
    return sum(size * size for size in sizes)

early = spatial_footprint(early_downsample)
late = spatial_footprint(late_downsample)

print(f"early={early}")
print(f"late={late}")
print(f"late/early={late / early:.2f}x")
预期输出
early=21952
late=116032
late/early=5.29x
这个结果不能直接等同于实际显存或 FLOPs,因为真实成本还取决于通道数、卷积核、数据类型以及训练时保存的中间激活。不过它清楚说明:在高分辨率阶段多保留几层,空间计算成本可能迅速增加。
根据任务决定降采样节奏
图像分类只要求最终类别时,网络可以相对积极地下采样。只要前几层已经提取出稳定的局部模式,降低空间分辨率并逐步增加通道数,通常能在准确率和成本之间取得良好平衡。
小目标分类、细粒度识别、检测和分割更依赖局部细节。假设输入为 224×224,而目标只有约 8×8 像素,连续三次 2 倍下采样后,它在特征图上理论上只剩约 1×1 个位置,形状信息几乎无法表达。因此,这类任务应延后部分降采样,或保留高分辨率分支和多尺度特征。
输入本身也会影响选择。32×32 的小图若一开始就使用 7×7、步幅 2 卷积再接 2×2 池化,很快只剩 8×8;而 1024×1024 图像若长期保持原分辨率,计算代价又可能难以接受。不能照搬固定的下采样模板,而应先看输入与目标的相对尺度。
用三个检查点确定下采样位置
设计网络时,可以依次检查三个问题。首先确认最小重要目标在下采样后还剩多少空间位置;如果只剩一两个位置,通常已经过于激进。其次检查高分辨率阶段的计算和训练显存能否接受,必要时把一部分卷积移到降采样之后。
最后再结合感受野检查深层特征是否覆盖足够大的区域。延后下采样虽然保留细节,却也会让采样间距增长得更慢;如果网络层数有限,深层感受野可能不足。此时可以增加后续卷积层、使用更大的有效卷积核或合理使用空洞卷积,而不是简单地提前连续降采样。
一个稳妥的默认策略是:先用少量步幅 1 卷积提取低级特征,再分阶段进行 2 倍下采样,并在分辨率下降时增加通道数。最终位置应由最小目标尺寸、计算预算和所需感受野共同决定,而不是只追求更小的特征图。