
机器学习与深度学习 / 系统课时
用残差连接训练更深网络
用残差连接训练更深网络
深层网络难训不只是因为参数更多,还因为信息与梯度必须连续穿过许多变换。残差连接为特征和梯度增加一条 shortcut,使网络可以在已有表示上学习修正量,并让继续加深网络变得更可控。
学习目标
- 解释残差块主分支与 shortcut 的组合方式
- 理解 shortcut 为什么能提供更直接的梯度传播路径
- 判断何时需要用投影 shortcut 对齐空间尺寸或通道数
残差块学习的是修正量
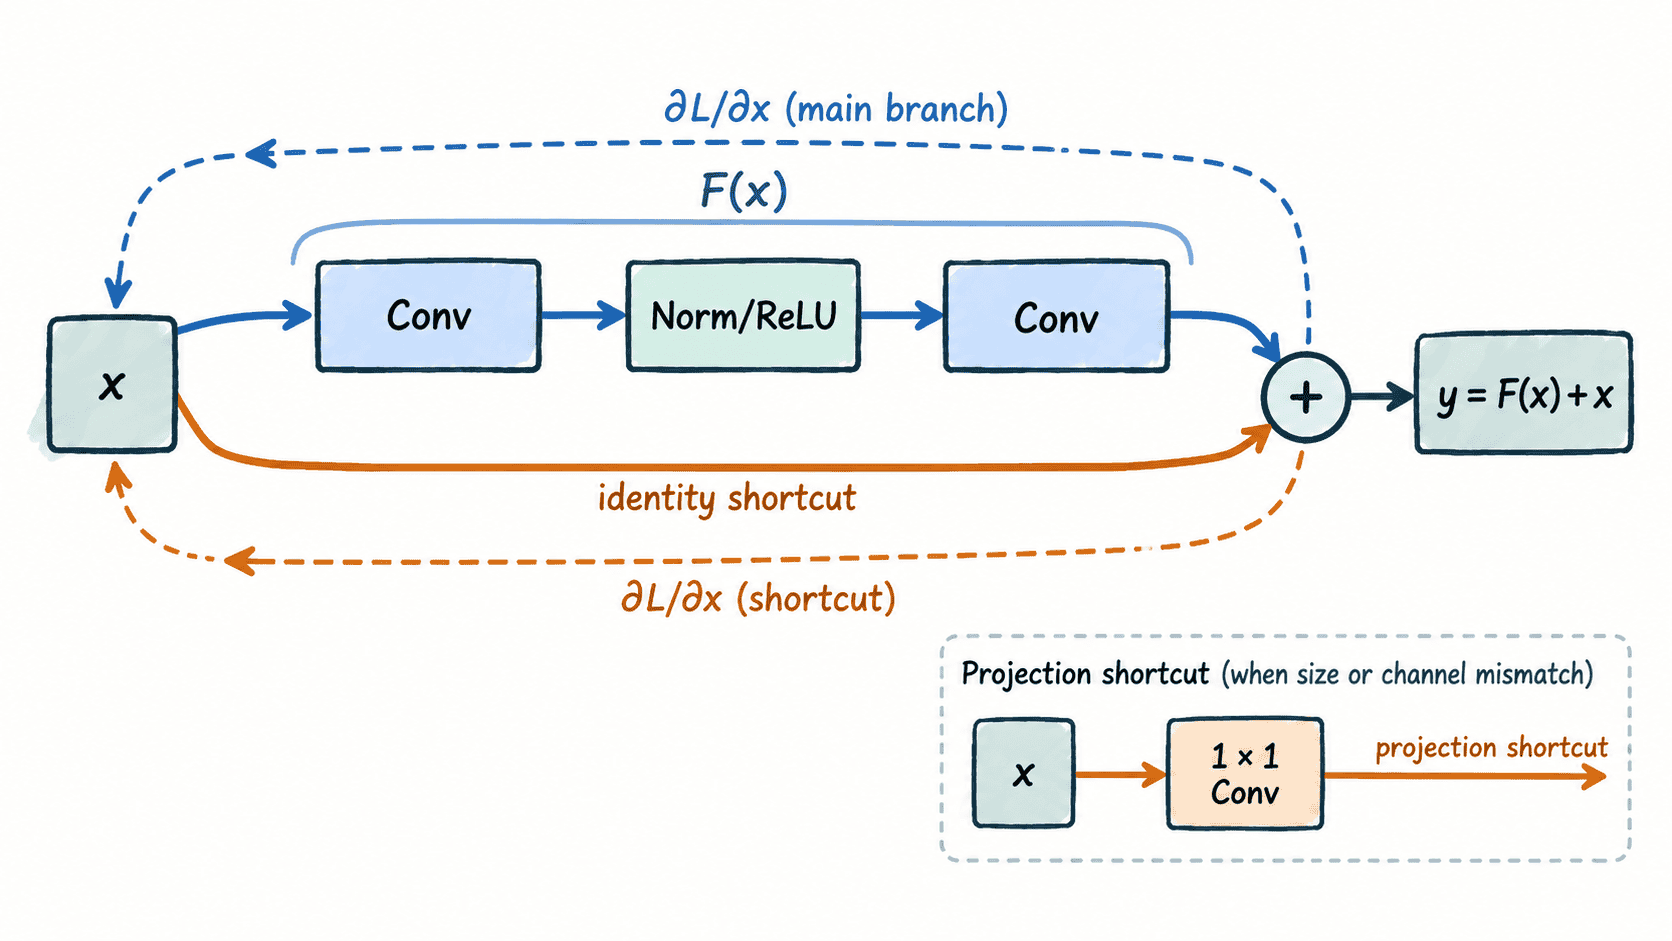
普通卷积块直接学习从输入 到目标表示 的完整映射。残差块把任务改写为学习 ,最终输出为 。如果当前输入已经接近合适表示,主分支只需要学习较小的修正,而不必重新构造全部信息。
这里的主分支通常包含若干卷积、归一化和激活操作;shortcut 则绕过这些变换,把输入直接送到加法节点。两条路径在形状一致时逐元素相加,因此 shortcut 不是拼接操作,也不会额外增加通道维度。
shortcut 如何改善梯度传播
对 求关于输入的梯度时,反向传播既会经过 ,也存在来自恒等项 的直接路径。即使主分支中的多层变换暂时让梯度变弱,shortcut 仍能把学习信号传回更早的层,因此深层网络不必完全依赖一条很长的连续链路。
这并不意味着残差连接可以彻底消除梯度问题,也不保证网络越深越好。优化器、初始化、归一化、数据规模和模型容量仍会影响训练;残差结构解决的是深层网络中一项关键的优化障碍,而不是替代其他训练设计。
用结构实验观察直接路径
下面的实验把主分支中两个卷积的权重全部置零。普通块因此只能输出零,并阻断输入方向的梯度;残差块虽然拥有同样的零主分支,却仍能通过 identity shortcut 原样传递输入和梯度。在已安装 PyTorch 的 Python 环境中可直接运行。
import torch
from torch import nn


torch.manual_seed(0)


class PlainBlock(nn.Module):
    def __init__(self, channels):
        super().__init__()
        self.conv1 = nn.Conv2d(channels, channels, 3, padding=1, bias=False)
        self.conv2 = nn.Conv2d(channels, channels, 3, padding=1, bias=False)

    def forward(self, x):
        return self.conv2(self.conv1(x))


class ResidualBlock(PlainBlock):
    def forward(self, x):
        return super().forward(x) + x


def clear_main_branch(model):
    # 将主分支置零,用来隔离并观察 shortcut 的作用。
    for layer in model.modules():
        if isinstance(layer, nn.Conv2d):
            nn.init.zeros_(layer.weight)


plain = PlainBlock(8)
residual = ResidualBlock(8)
clear_main_branch(plain)
clear_main_branch(residual)

x_plain = torch.randn(1, 8, 8, 8, requires_grad=True)
x_residual = x_plain.detach().clone().requires_grad_()
y_plain = plain(x_plain)
y_residual = residual(x_residual)

# 分别反向传播,检查输入端是否仍能收到非零梯度。
y_plain.sum().backward()
y_residual.sum().backward()

print(f'plain_shape={tuple(y_plain.shape)}')
print(f'residual_shape={tuple(y_residual.shape)}')
print(f'plain_preserves_input={torch.equal(y_plain, x_plain)}')
print(f'residual_preserves_input={torch.equal(y_residual, x_residual)}')
print(f'plain_input_grad_nonzero={bool(torch.count_nonzero(x_plain.grad))}')
print(f'residual_input_grad_nonzero={bool(torch.count_nonzero(x_residual.grad))}')
预期输出
plain_shape=(1, 8, 8, 8)
residual_shape=(1, 8, 8, 8)
plain_preserves_input=False
residual_preserves_input=True
plain_input_grad_nonzero=False
residual_input_grad_nonzero=True
实验故意使用极端的零权重来暴露结构差异。真实训练中主分支不会长期保持为零,但 shortcut 提供的直接传播通道始终存在,这正是残差网络能够稳定堆叠大量块的重要原因。
尺寸不一致时使用投影 shortcut
恒等 shortcut 要求主分支输出与输入拥有相同的高、宽和通道数,否则无法逐元素相加。网络进入新阶段时经常需要下采样或增加通道,例如从 64×56×56 变为 128×28×28,此时 shortcut 也必须同步变换。
常见做法是在 shortcut 上使用带相应步幅的 1×1 卷积,将输入投影到目标形状。若主分支用 stride=2 完成下采样,投影分支也使用 stride=2;若仅通道数不同,则空间步幅保持为 1。投影的职责是让两条路径可相加,而不是承担主分支的空间特征提取任务。
设计残差块时,先检查加法两侧的张量形状,再决定使用 identity 还是 projection shortcut。形状一致时优先保留无参数的恒等路径;形状发生变化时再引入投影,这样既保留残差结构的直接传播优势,也避免无必要的参数和计算。