
机器学习与深度学习 / 系统课时
调整学习率让训练更快收敛
调整学习率让训练更快收敛
学习率决定参数每次更新走多远:过大会让损失反复震荡甚至发散,过小则可能长时间停留在缓慢下降阶段。本篇先用损失曲线判断基础学习率是否合理,再比较固定学习率、分段衰减和常见调度策略,形成可复现的调整顺序。
学习目标
- 根据损失下降速度与波动形态判断学习率过高、过低或需要后期衰减。
- 理解固定学习率、分段衰减、余弦衰减和指标驱动调度的适用差异。
- 固定其他训练条件,通过单变量实验选择基础学习率和调度策略。
从损失曲线判断学习率问题
学习率首先影响优化轨迹,因此不要只看最后一轮准确率。训练刚开始的几十到几百个批次,往往已经能暴露数量级是否明显错误。
| 训练现象 | 更可能的问题 | 调整方向 |
|---|---|---|
| 损失剧烈上下跳动,甚至持续增大 | 基础学习率过高 | 明显降低学习率后重试 |
| 损失稳定下降但非常缓慢 | 学习率可能过低 | 在稳定前提下适度增大 |
| 前期下降很快,后期长期小幅震荡 | 后期步长偏大 | 保留基础学习率并加入衰减 |
| 训练损失继续下降,验证损失却回升 | 更像过拟合 | 优先检查正则化与停止时机 |
最后一种现象尤其容易误判。学习率调整主要解决“参数怎么走”,而训练集继续改善、验证集持续恶化说明模型已经在学习训练集特有模式,单纯把学习率调得更小不等于解决泛化问题。
固定学习率先建立基线
固定学习率并不落后,它是判断基础数量级最清楚的基线。如果一个 CNN 用固定学习率就出现立即发散或几乎不下降,那么过早引入复杂调度器只会掩盖问题。
先保持网络结构、批大小、优化器和数据顺序不变,用少量训练轮次比较少数几个相差明显的学习率。目标不是在这个阶段找到最终最优值,而是找到“能够稳定且较快下降”的数量级,再决定后期如何减小步长。
用分段衰减验证调度是否生效
当基础学习率已经合适,但训练后期需要更小步长时,分段衰减最容易解释。下面用 MultiStepLR 在第 3 和第 6 轮完成后把学习率缩小为原来的十分之一,并打印每一轮实际使用的学习率。
import torch
from torch import nn

model = nn.Sequential(
    nn.Conv2d(3, 8, kernel_size=3, padding=1),
    nn.ReLU(),
    nn.AdaptiveAvgPool2d(1),
    nn.Flatten(),
    nn.Linear(8, 2),
)

optimizer = torch.optim.SGD(model.parameters(), lr=0.1)
scheduler = torch.optim.lr_scheduler.MultiStepLR(
    optimizer,
    milestones=[3, 6],
    gamma=0.1,
)
criterion = nn.CrossEntropyLoss()
inputs = torch.randn(4, 3, 32, 32)
targets = torch.tensor([0, 1, 0, 1])

for epoch in range(1, 9):
    # 先打印本轮真正用于参数更新的学习率。
    current_lr = optimizer.param_groups[0]["lr"]
    print(f"epoch={epoch}, lr={current_lr:.3f}")

    optimizer.zero_grad()
    logits = model(inputs)
    loss = criterion(logits, targets)
    loss.backward()
    optimizer.step()

    # 在一轮训练结束后推进调度器,为下一轮准备学习率。
    scheduler.step()
预期输出
epoch=1, lr=0.100
epoch=2, lr=0.100
epoch=3, lr=0.100
epoch=4, lr=0.010
epoch=5, lr=0.010
epoch=6, lr=0.010
epoch=7, lr=0.001
epoch=8, lr=0.001
这种策略适合已经知道关键训练阶段的实验,例如希望前若干轮快速搜索参数空间,再在固定里程碑后细化。真正训练 CNN 时,里程碑应依据完整训练曲线选择,而不是机械照搬示例中的第 3、6 轮。
根据训练节奏选择调度策略
固定学习率适合作为基线和短实验;MultiStepLR 适合有明确衰减节点的训练计划。若没有自然的阶段边界,余弦衰减可以让学习率平滑地从较大值逐步减小,避免在里程碑处突然改变步长。
ReduceLROnPlateau 则根据验证指标是否长期停止改善来降低学习率。它适合训练长度难以预先确定的任务,但对验证集噪声更敏感,需要合理设置耐心轮数和阈值,而且调用时必须传入本轮监控指标。
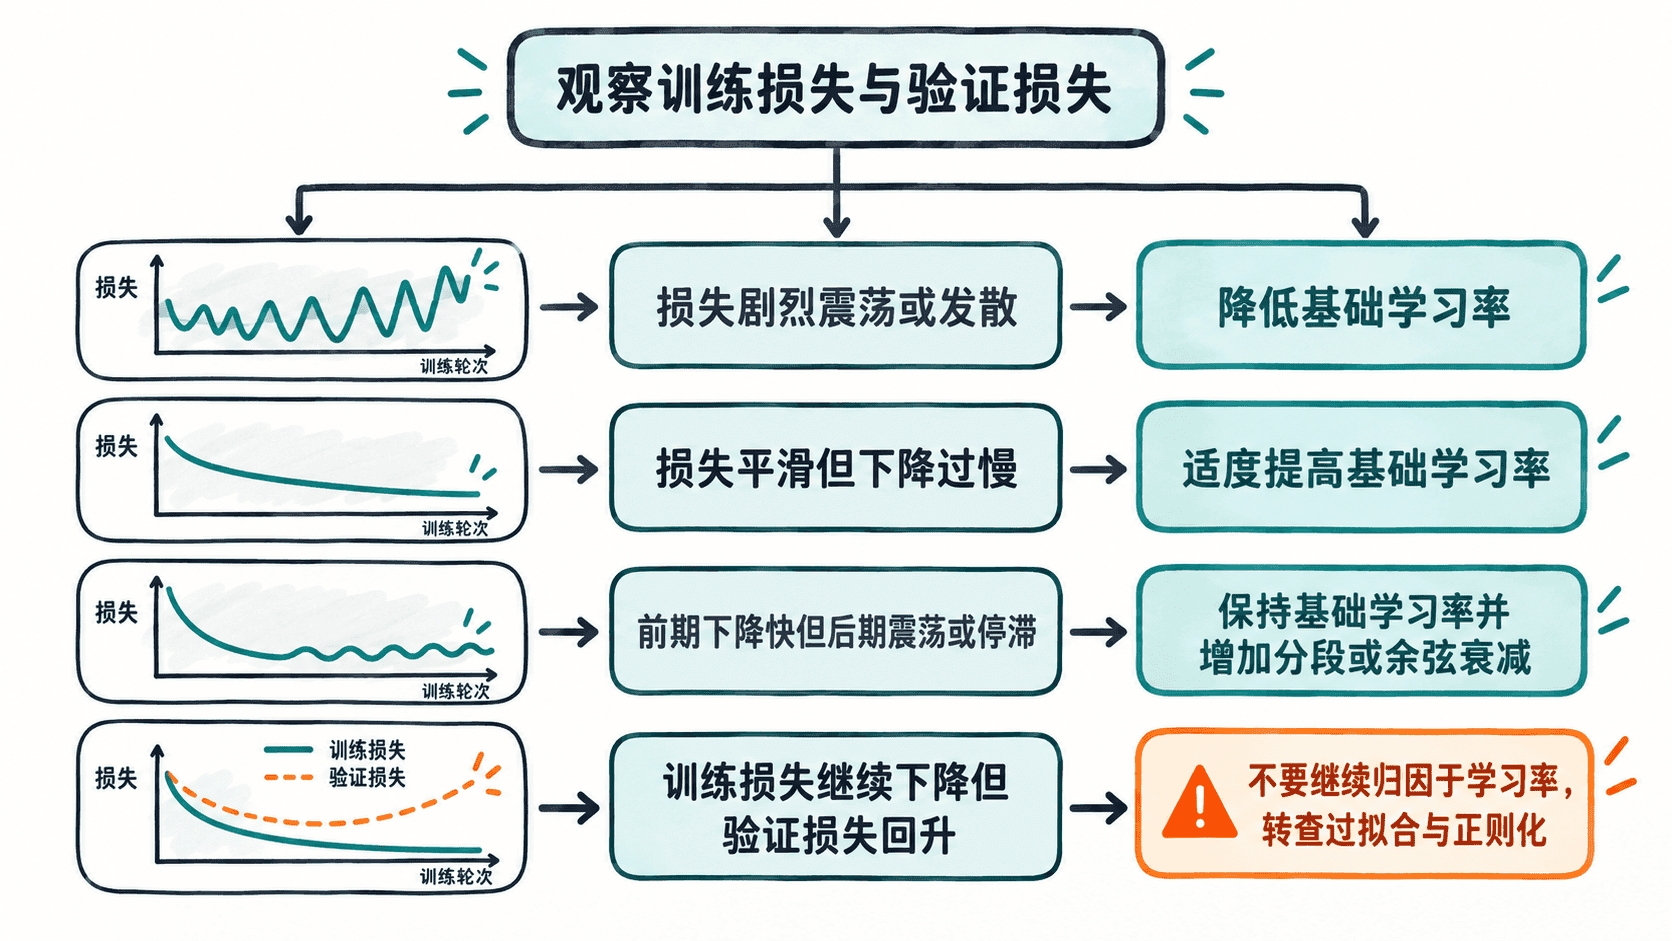
不同调度器并不存在脱离任务的绝对排名。真正要回答的是:当前基础学习率是否合理、训练后期是否仍需要减小步长,以及衰减时机是能够预先确定,还是必须依赖验证指标决定。
按固定顺序做可复现实验
调整学习率时最容易出现的问题,是同时改变优化器、批大小、调度器和训练轮数,最终无法解释收敛速度变化来自哪里。更稳妥的实验顺序如下。
- 固定数据划分、随机种子、模型结构、批大小和优化器,先运行固定学习率基线。
- 若一开始就发散或剧烈震荡,先降低基础学习率,不急着增加调度器。
- 若下降稳定但明显过慢,在不引起震荡的前提下适度提高基础学习率。
- 基础学习率确定后,再比较固定、分段衰减或余弦衰减等后期策略。
- 同时比较达到目标验证指标的速度、最佳验证指标和训练稳定性,而不是只比较最后一轮损失。
为了让中断后的训练保持同一条学习率轨迹,保存检查点时还应同时保存模型、优化器、调度器状态以及当前轮次。只恢复模型参数却重新创建调度器,可能让恢复后的学习率重新从错误阶段开始。
用收敛速度和验证指标一起验收
一个更快的学习率方案,不应只是训练损失下降得更陡,而应在稳定训练的前提下更早达到目标验证性能。如果新方案虽然前几轮下降很快,却因为震荡导致最佳验证结果变差,它仍然不是更好的配置。
因此,学习率调优应先找对基础数量级,再决定是否需要后期衰减;固定学习率负责建立可解释基线,调度器负责改变训练节奏,而损失曲线和验证表现共同决定下一步动作。