
机器学习与深度学习 / 系统课时
用反向传播更新卷积参数
用反向传播更新卷积参数
CNN 能学会边缘、纹理和更高层特征,关键在于分类损失能够沿计算图反向传到卷积核。本篇跟踪一次完整训练步,分清清空梯度、前向计算、反向传播和优化器更新各自改变了什么。
学习目标
- 说明分类损失如何沿计算图产生卷积权重梯度
- 分清
zero_grad、backward与step的职责 - 通过参数前后对比验证一次更新确实发生
梯度如何回到卷积核
前向传播时,输入经过卷积得到特征图,再由后续层计算 logits 和损失。反向传播则沿相反方向使用链式法则:损失先对 logits 求导,再把梯度依次传过全连接层和卷积输出,最终得到每个卷积权重对当前损失的影响。
卷积核中的同一个参数会在多个空间位置重复参与计算,因此它的最终梯度是这些使用位置贡献的累积。自动微分负责记录计算图并完成求导,开发者通常不需要手写卷积求导公式,但必须正确控制梯度何时产生、何时清除以及何时用于更新参数。
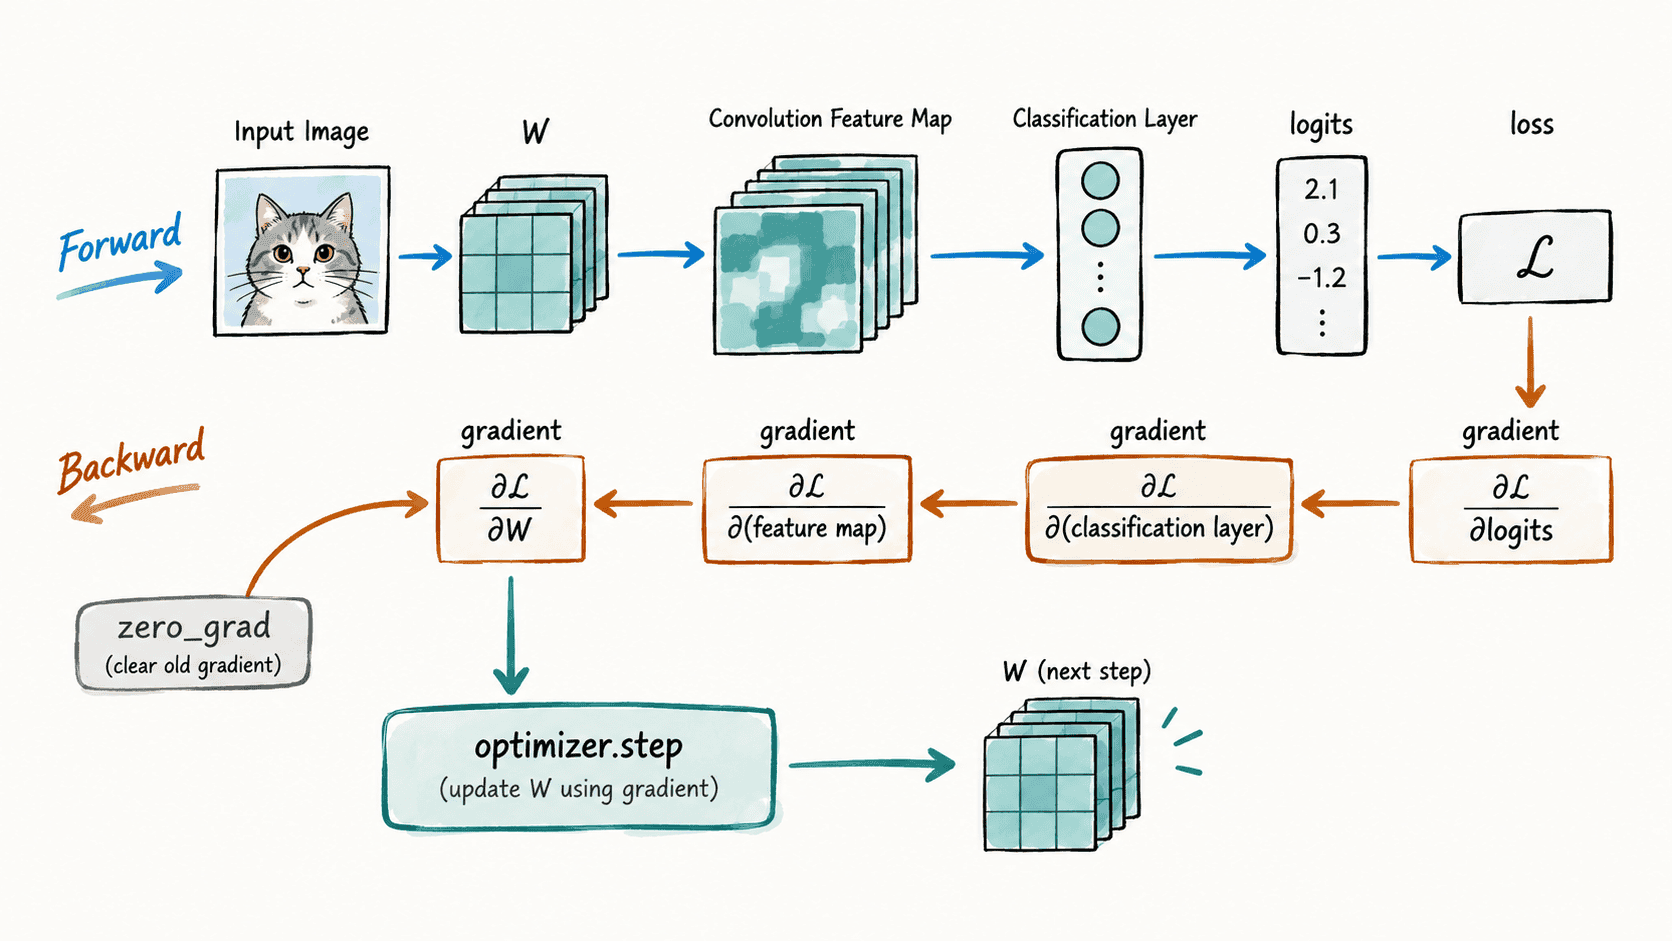
一次训练步的职责边界
一个标准训练步包含四个关键动作,而且顺序不能随意交换。
optimizer.zero_grad()清除上一训练步留下的梯度,避免默认累积影响当前批次。- 前向传播计算 logits,再由损失函数得到当前批次的标量 loss。
loss.backward()沿计算图执行自动微分,把结果写入各可训练参数的.grad。optimizer.step()读取这些梯度,并按照 SGD、Adam 等优化规则修改参数值。
其中 backward() 只计算梯度,不直接修改权重;真正改变卷积参数的是优化器的 step()。这一点是排查“为什么参数没有更新”时最重要的边界。
验证卷积参数真的发生变化
下面构造一个最小 CNN,对两个样本执行一次 SGD 更新。程序分别检查卷积权重是否获得梯度、梯度是否包含非零值,以及调用优化器后权重是否改变。
import torch
from torch import nn
import torch.nn.functional as F

torch.manual_seed(0)

model = nn.Sequential(
    nn.Conv2d(1, 2, kernel_size=3, padding=1),
    nn.Flatten(),
    nn.Linear(2 * 4 * 4, 2),
)

x = torch.tensor([
    [[[0., 1., 2., 3.], [1., 2., 3., 4.], [2., 3., 4., 5.], [3., 4., 5., 6.]]],
    [[[6., 5., 4., 3.], [5., 4., 3., 2.], [4., 3., 2., 1.], [3., 2., 1., 0.]]],
])
targets = torch.tensor([0, 1])
optimizer = torch.optim.SGD(model.parameters(), lr=0.1)
conv = model[0]
before = conv.weight.detach().clone()

# 先清除旧梯度,再建立当前批次的计算图。
optimizer.zero_grad()
logits = model(x)
loss = F.cross_entropy(logits, targets)

# backward 只生成梯度,此时权重本身还没有变化。
loss.backward()
print("grad exists:", conv.weight.grad is not None)
print("grad nonzero:", bool(conv.weight.grad.abs().sum() > 0))

# step 才根据梯度真正修改参数。
optimizer.step()
print("weight changed:", not torch.equal(before, conv.weight.detach()))
预期输出
grad exists: True
grad nonzero: True
weight changed: True
为什么必须清空梯度
PyTorch 默认把新产生的梯度累积到参数已有的 .grad 中。这种设计支持梯度累积等训练策略,但普通的逐批训练若忘记清空梯度,第 2 个批次使用的将是“第 1 批梯度 + 第 2 批梯度”,更新幅度和方向都会偏离预期。
因此常规循环应保证每个训练步在反向传播之前执行一次 zero_grad()。若确实要做梯度累积,则应有意识地跨多个小批次保留梯度,并在达到计划的累积步数后再调用 step() 和 zero_grad(),而不是偶然漏掉清理操作。
稳定训练循环的核心顺序可以归结为:清旧梯度、计算当前损失、反向生成新梯度、最后更新参数。只要这四个职责没有混淆,卷积层就能持续依据分类误差调整自身权重。