
机器学习与深度学习 / 系统课时
用步幅控制特征图尺寸
用步幅控制特征图尺寸
stride 决定卷积核每次在输入上移动多远,因此会同时改变输出特征图尺寸、计算成本和细节保留程度。本篇从输出尺寸公式出发,建立一套在搭网络前就能预测张量大小并判断下采样强度的方法。
学习目标
- 使用 stride、padding、kernel size 和 dilation 推导卷积输出尺寸
- 解释 stride 增大后为什么输出更小、计算更少且细节更容易丢失
- 在给定网络配置下提前检查各层张量尺寸是否符合预期
从输出尺寸公式看 stride
对单个空间维度,输入长度为 ,卷积核大小为 ,padding 为 ,dilation 为 ,stride 为 ,输出长度为:
二维卷积分别对高度和宽度应用同一公式。stride 出现在分母中,因此在其他条件不变时,stride 越大,输出位置越少。
例如输入为 7×7,使用 3×3 卷积、padding=1、dilation=1。stride=1 时输出仍为 7×7;stride=2 时输出变为 4×4。输出没有简单地变成 3.5×3.5,而是按公式向下取整后得到合法整数尺寸。
卷积核是跨步滑动,不是直接抽像素
stride=2 并不等于“每隔一个像素取一个值”。卷积核仍会覆盖一个局部区域,只是相邻输出位置对应的卷积窗口中心移动得更远。以 3×3 卷积为例,stride=1 时相邻窗口高度重叠,stride=2 时窗口重叠减少,因此输出更稀疏。
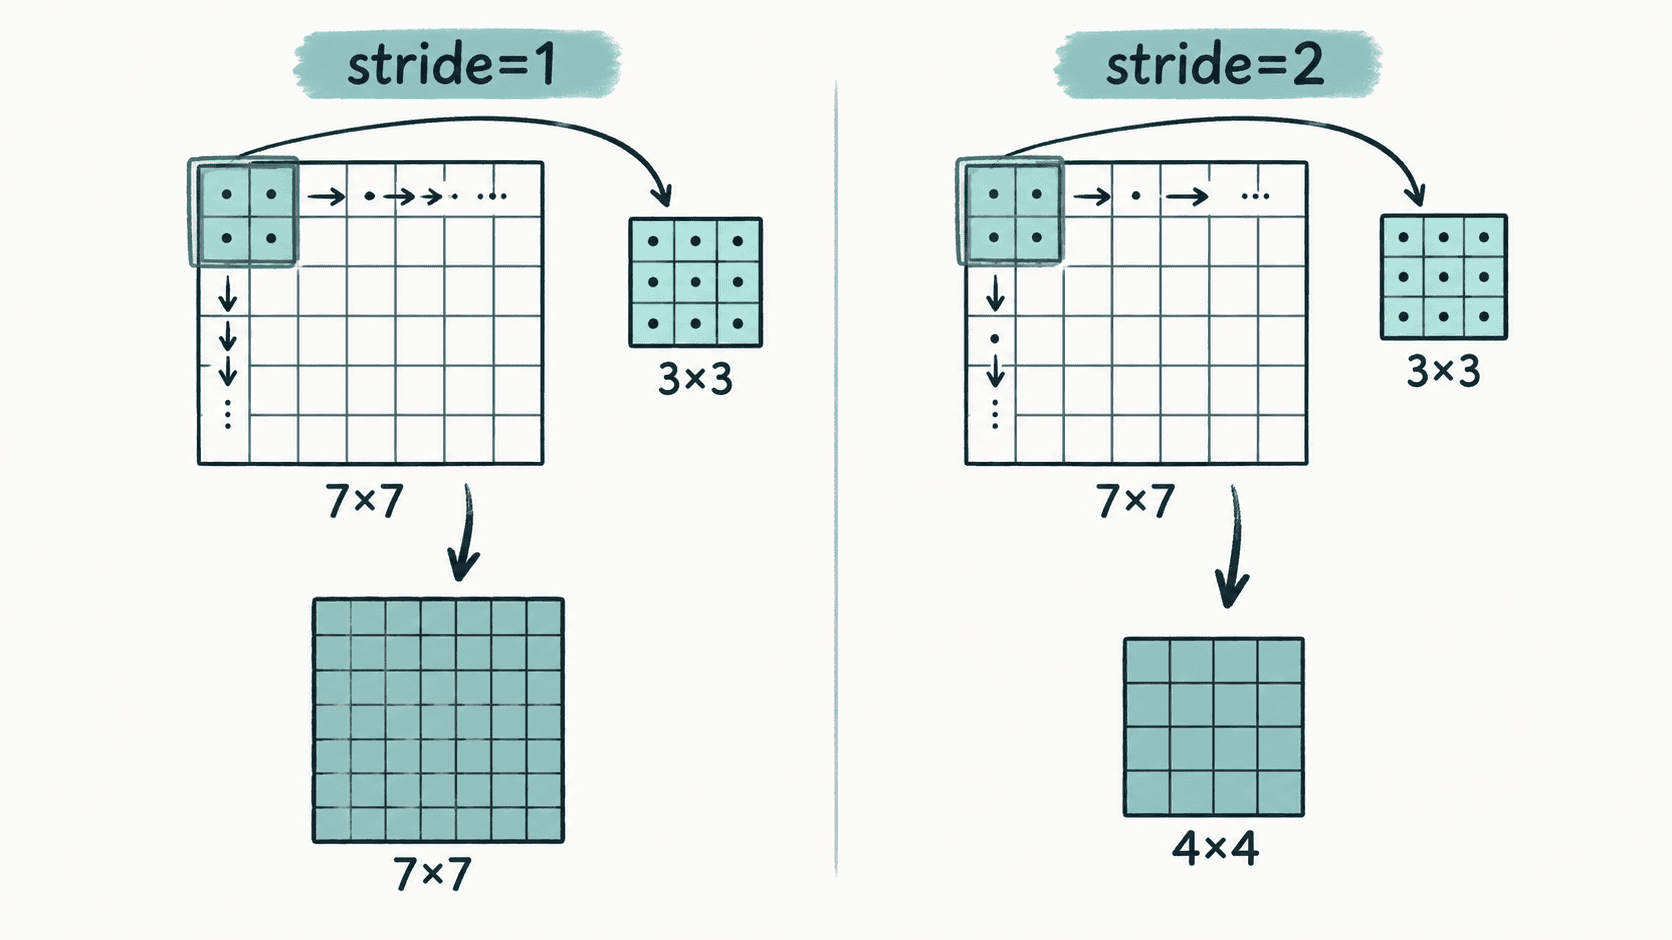
这个区别很重要:stride 控制的是卷积窗口的采样密度。较大的 stride 会减少相邻输出之间的信息冗余,但也更容易跳过局部细节。
用具体尺寸提前验算网络
假设输入张量空间尺寸为 224×224,卷积核 3×3、padding=1、dilation=1。
当 stride=1:
当 stride=2:
如果输入输出通道数和卷积核都不变,卷积主体 MACs 与输出面积近似成正比。空间尺寸从 224×224 降为 112×112,输出位置数变为原来的四分之一,因此这一层的主要计算量也约降为四分之一。
下采样会交换细节与成本
较大的 stride 能快速压缩特征图,降低后续层的显存占用和计算量,但它也降低了空间采样密度。分类模型在较深层通常允许逐步下采样,因为此时更关心高级语义;检测、分割等任务依赖精细位置时,则要更谨慎地控制下降速度。
搭网络前建立尺寸检查表
预测每层尺寸时,先记录输入高宽,再按 kernel、padding、dilation 和 stride 计算输出,不要只凭“stride=2 就减半”的经验。奇数尺寸、不同 padding 或 dilation 都可能让结果偏离简单除法。
最实用的检查顺序是:先算空间尺寸,再确认通道数,最后计算输出张量形状和该层成本。这样在真正运行模型前,就能发现残差分支尺寸不一致、特征图过早缩小或计算量超预算等结构问题。