
机器学习与深度学习 / 系统课时
选择指标评估分类模型
选择指标评估分类模型
图像分类不能只报一个准确率:类别分布一旦不均衡,或者漏检和误报的代价不同,同一个模型可能在不同指标下得到完全不同的结论。本篇建立从错误成本到每类统计、再到统一验证口径的评估方法。
学习目标
- 理解 accuracy、precision、recall 和 F1 分别回答什么问题
- 区分 macro、weighted 与 micro 聚合方式,选择与类别分布匹配的主指标
- 用固定验证集和每类统计建立可复现的模型比较口径
从错误成本定义指标
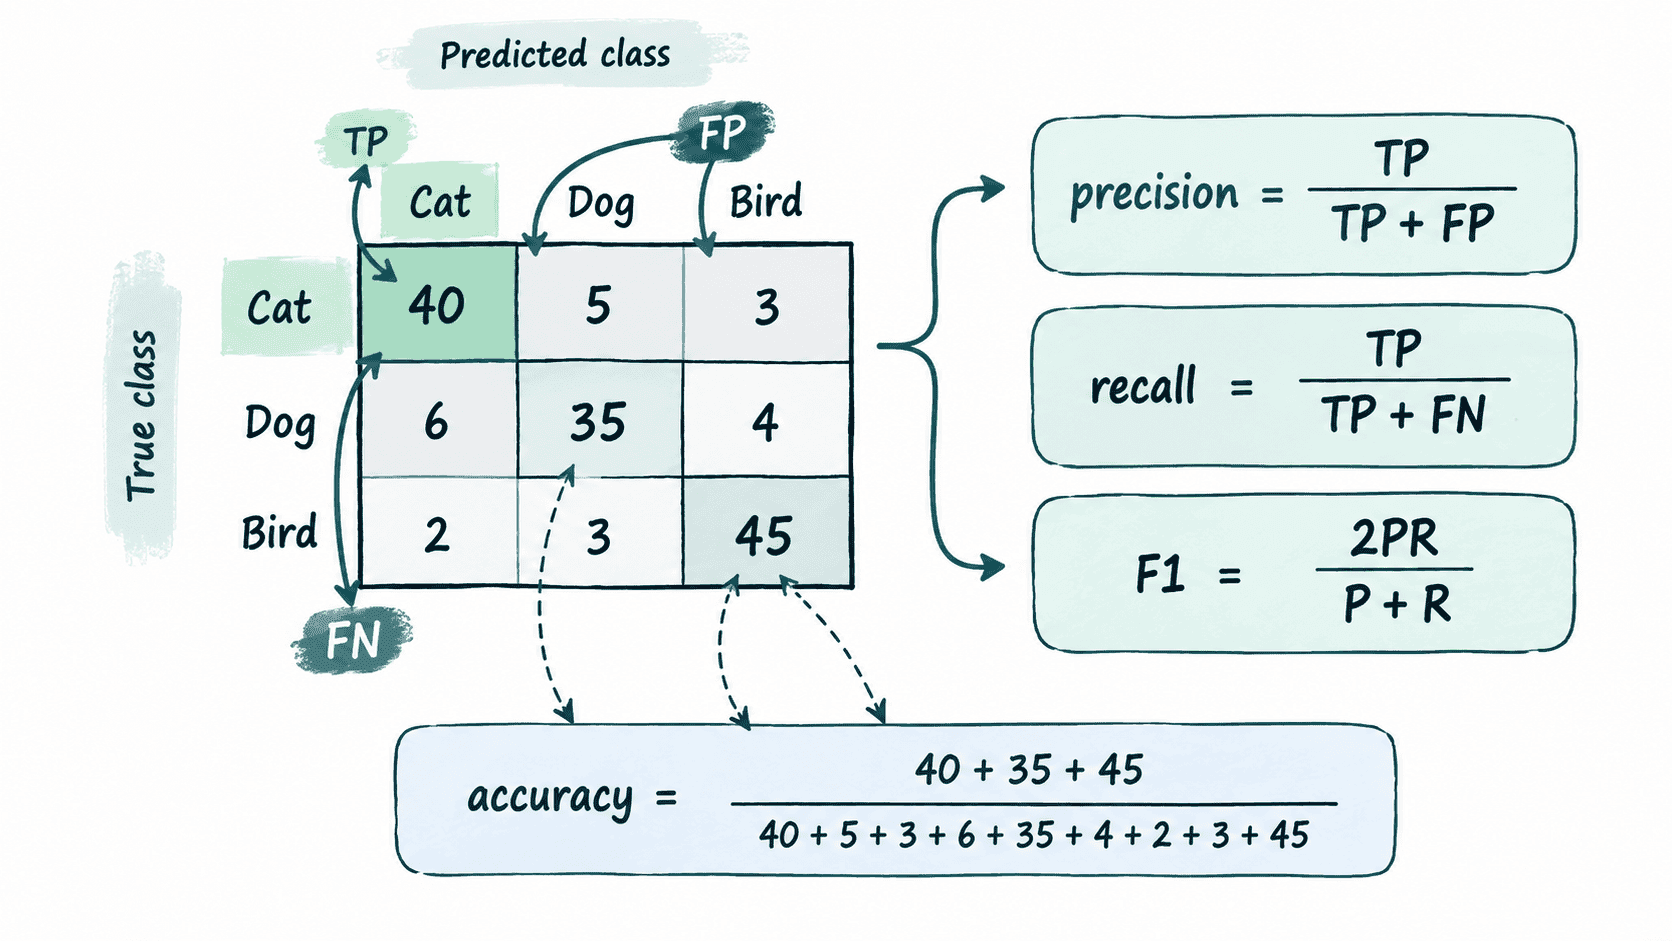
对某一个类别做 one-vs-rest 观察时,预测正确的正样本是 TP,把其他类别错报成它的是 FP,把它漏到其他类别的是 FN。precision 关注“预测成这个类的样本有多少是真的”,recall 关注“这个类的真实样本有多少被找回来”,F1 则用调和平均综合两者。
常用关系可以写成:、、。accuracy 只统计全部样本中预测正确的比例,因此在 95% 样本都属于头部类时,模型即使完全忽略尾部类,也可能得到很高的 accuracy。
选对多分类聚合方式
多分类任务先得到每个类别自己的 precision、recall 和 F1,再决定如何汇总。macro 平均让每个类别权重相同,适合关注少数类别是否被忽略;weighted 平均按每类样本数加权,更接近整体数据分布;micro 先汇总所有类别的 TP、FP、FN,再计算指标。
对于单标签多分类,micro precision、micro recall 和 micro F1 与 accuracy 数值相同,因此它不能替代类别级检查。类别严重不平衡时,通常把 macro F1 作为主要比较指标,再同时报告 accuracy 和每类 recall,比只报 weighted F1 更不容易掩盖尾部类别失败。
用同一组预测计算完整指标
下面用纯 Python 对一组三分类预测计算 accuracy、每类 precision/recall/F1、macro F1 和 weighted F1。实现过程也展示了这些指标如何从混淆统计中得到。
y_true = [0, 0, 0, 1, 1, 1, 2, 2]
y_pred = [0, 0, 1, 1, 1, 0, 2, 0]
labels = sorted(set(y_true) | set(y_pred))

def safe_div(a, b):
    return a / b if b else 0.0

correct = sum(t == p for t, p in zip(y_true, y_pred))
accuracy = correct / len(y_true)

rows = []
for cls in labels:
    tp = sum(t == cls and p == cls for t, p in zip(y_true, y_pred))
    fp = sum(t != cls and p == cls for t, p in zip(y_true, y_pred))
    fn = sum(t == cls and p != cls for t, p in zip(y_true, y_pred))
    support = sum(t == cls for t in y_true)

    precision = safe_div(tp, tp + fp)
    recall = safe_div(tp, tp + fn)
    f1 = safe_div(2 * precision * recall, precision + recall)
    rows.append((cls, precision, recall, f1, support))

macro_f1 = sum(row[3] for row in rows) / len(rows)
weighted_f1 = sum(row[3] * row[4] for row in rows) / len(y_true)

print(f"accuracy={accuracy:.3f}")
for cls, precision, recall, f1, support in rows:
    print(
        f"class={cls} precision={precision:.3f} "
        f"recall={recall:.3f} f1={f1:.3f} support={support}"
    )
print(f"macro_f1={macro_f1:.3f}")
print(f"weighted_f1={weighted_f1:.3f}")
预期输出:
accuracy=0.625
class=0 precision=0.500 recall=0.667 f1=0.571 support=3
class=1 precision=0.667 recall=0.667 f1=0.667 support=3
class=2 precision=1.000 recall=0.500 f1=0.667 support=2
macro_f1=0.635
weighted_f1=0.631
这组结果里,类别 2 的 precision 是 1.0,但 recall 只有 0.5,说明模型一旦预测为 2 基本没错,却漏掉了一半真实的 2 类样本。只看 accuracy 无法直接看出这种错误形态。
建立统一验证口径
模型之间的指标只有在评估条件一致时才可比较。验证集应固定,且与训练数据严格分离;图像尺寸、归一化、类别映射、测试时增强策略和最终决策规则也必须一致。若一次评估使用单中心裁剪,另一次使用多裁剪平均,即使模型权重相同,结果也不能直接横向比较。
在类别不平衡任务中,建议为每次实验固定一组最小报告项:总体 accuracy、macro F1、每类 precision/recall/F1、support,以及混淆矩阵。若业务对某一类的漏检成本特别高,再把该类 recall 设为硬约束,例如“macro F1 提升且关键类 recall 不得下降”。
用指标组合而不是单个数字做决策
precision 高而 recall 低,通常表示模型很保守;recall 高而 precision 低,通常表示模型把更多可疑样本都判成目标类。F1 适合在两者都重要时做平衡,但它仍不会告诉你具体错到了哪个类别,因此要和混淆矩阵、每类 support 一起看。
选择指标时先问“哪种错误更贵”,再问“类别是否均衡”。类别近似均衡且错误成本接近时,accuracy 可以作为主指标;长尾分类更适合用 macro F1 和每类 recall;对关键类别有明确风险约束时,则应直接把该类 precision 或 recall 纳入验收条件。统一口径之后,模型比较才是在比较模型,而不是在比较不同的评估方法。