
机器学习与深度学习 / 系统课时
导出模型并验证数值一致性
导出模型并验证数值一致性
模型导出不是把文件“另存为”就结束,而是要证明独立推理表示与原模型对同一输入给出足够一致的结果。本节用固定样本把 PyTorch 分类器导出为 ONNX,并同时检查 logits 最大误差和最终类别是否一致。
学习目标
- 将推理态模型导出为可由独立运行时加载的 ONNX 文件
- 使用同一固定输入比较导出前后的 logits 数值差异
- 用类别一致性和误差阈值判断导出结果是否可接受
把导出和验证视为同一个流程
导出验证至少要固定四件事:模型参数、推理模式、输入张量和预处理。只要其中一项不同,logits 的差异就不能直接归因于“导出格式”。因此应先准备一个可重复输入,再让原模型与独立运行时分别计算,最后比较两组结果。
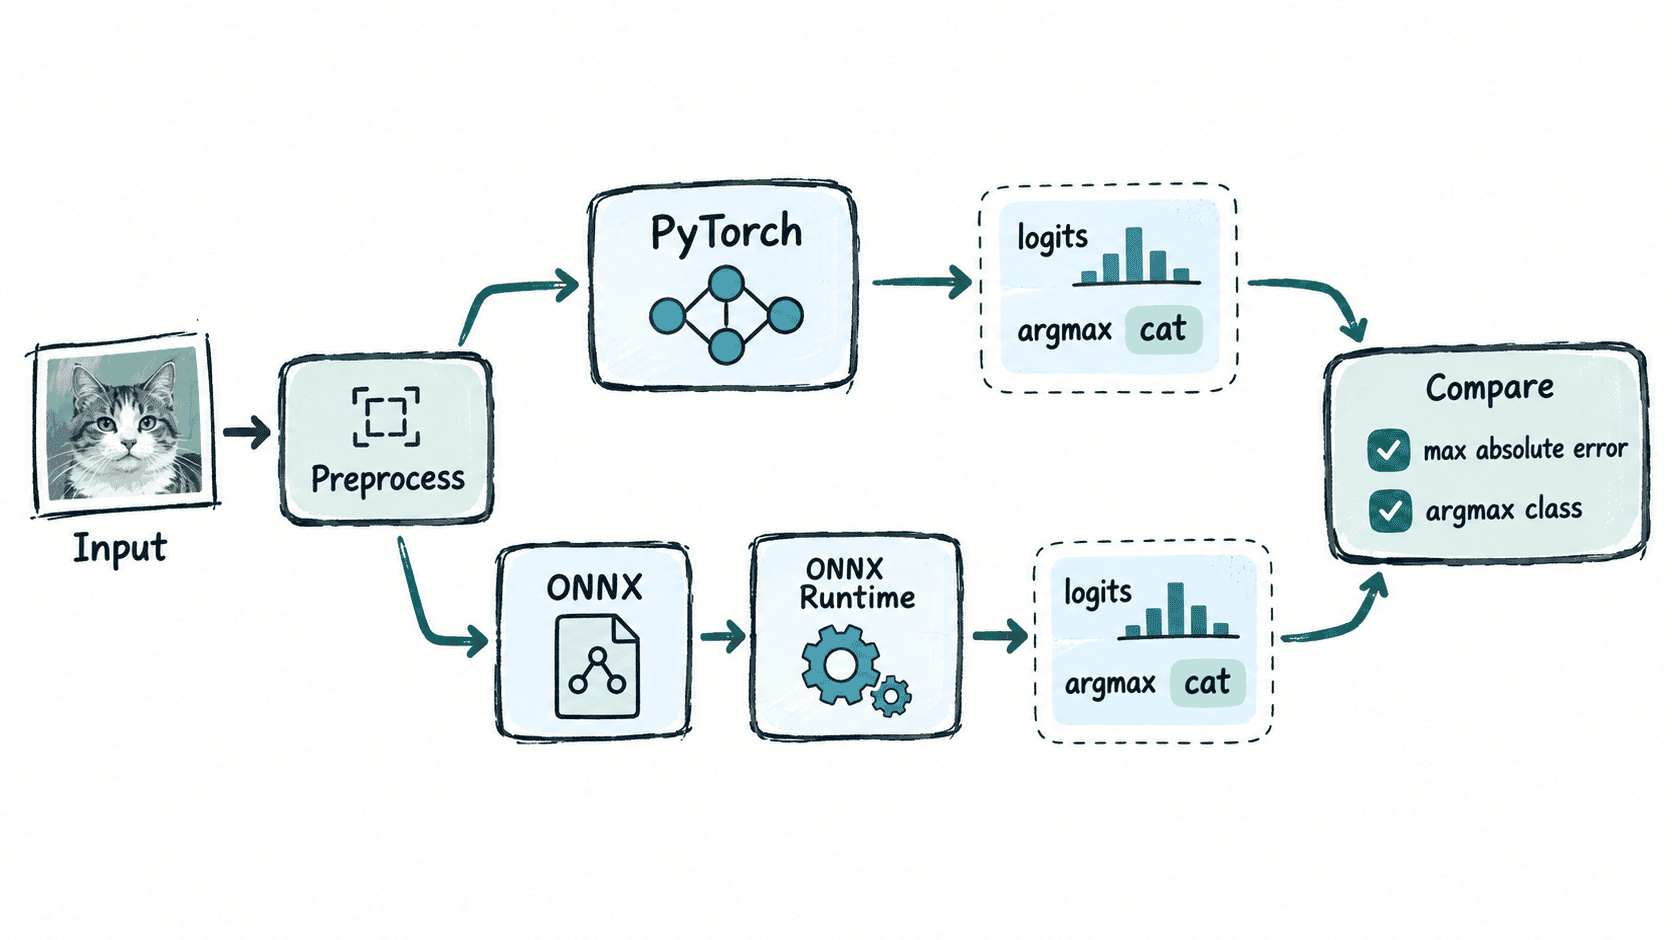
导出一个可独立推理的 ONNX 模型
下面的示例故意使用固定随机种子和固定输入,使验证可以重复执行。真实项目中,把 TinyClassifier() 替换为已经加载训练权重的模型即可,输入形状和预处理必须与训练阶段保持一致。
import numpy as np
import onnxruntime as ort
import torch
from torch import nn

torch.manual_seed(7)

class TinyClassifier(nn.Module):
    def __init__(self):
        super().__init__()
        self.features = nn.Sequential(
            nn.Conv2d(3, 8, kernel_size=3, padding=1),
            nn.ReLU(),
            nn.AdaptiveAvgPool2d((1, 1)),
        )
        self.classifier = nn.Linear(8, 4)

    def forward(self, x):
        x = self.features(x)
        return self.classifier(torch.flatten(x, 1))

model = TinyClassifier().eval()
sample = torch.randn(1, 3, 32, 32)

# 原模型先计算基准输出,导出后仍使用完全相同的 sample。
with torch.no_grad():
    torch_logits = model(sample).cpu().numpy()

torch.onnx.export(
    model,
    sample,
    "classifier.onnx",
    input_names=["images"],
    output_names=["logits"],
    opset_version=18,
)

# 独立运行时只读取导出的 ONNX 文件,不再调用 PyTorch 模型。
session = ort.InferenceSession(
    "classifier.onnx",
    providers=["CPUExecutionProvider"],
)
onnx_logits = session.run(
    ["logits"],
    {"images": sample.cpu().numpy().astype(np.float32)},
)[0]

max_abs_error = float(np.max(np.abs(torch_logits - onnx_logits)))
torch_class = int(np.argmax(torch_logits, axis=1)[0])
onnx_class = int(np.argmax(onnx_logits, axis=1)[0])

print(f"max_abs_error={max_abs_error:.8f}")
print(f"torch_class={torch_class}")
print(f"onnx_class={onnx_class}")
print(f"class_match={torch_class == onnx_class}")
预期输出
max_abs_error=<VALUE>
torch_class=<ID>
onnx_class=<ID>
class_match=True
<VALUE> 与 <ID> 会随模型权重和运行环境变化;关键是两个 <ID> 必须相同,并且最大绝对误差要落在项目预先定义的容忍范围内。若运行环境未安装依赖,可先安装 torch、onnx、onnxruntime 和 numpy。
用两层条件判断是否通过
最终类别一致只能说明 argmax 没变,不能证明整个输出向量一致。例如两个模型都把第 2 类排在第一名,但其余类别分数已经明显漂移,后续若增加阈值判断、Top-K 或校准逻辑,就可能产生不同结果。
因此建议同时检查两层条件:第一层比较 logits 的最大绝对误差或平均误差;第二层比较最终类别、Top-K 或业务阈值结果。误差阈值不要照搬固定常数,而应结合精度类型、算子实现和部署硬件,用一组代表性样本先建立基线。
数值不一致时按输入到算子的顺序排查
如果类别不一致,先确认输入尺寸、通道顺序、归一化参数和数据类型,再确认模型是否处于推理态。输入无误后,再定位是否存在运行时不支持或重写的算子、精度转换以及动态形状差异。
验证通过后,应把固定输入、原始 logits、导出模型 logits 和误差阈值一起纳入自动化测试。这样模型结构或导出配置变化时,可以在部署前发现“文件能加载但数值已经漂移”的问题。