
机器学习与深度学习 / 系统课时
组合正则化抑制过拟合
组合正则化抑制过拟合
当 CNN 在训练集上越来越准,验证集却不再改善时,继续增加训练轮数通常只会放大过拟合。本篇从训练与验证差距出发,区分权重衰减和 Dropout 的作用位置,并建立逐项增加正则化、用验证结果决定是否保留的调参方法。
学习目标
- 根据训练损失、验证损失和准确率差距识别过拟合,而不是把所有验证集问题都归因于模型容量。
- 区分权重衰减与 Dropout 的作用对象,并在 CNN 中选择合理位置。
- 按单变量实验组合正则化,避免一次叠加多个强约束导致欠拟合。
先确认问题确实是过拟合
正则化解决的是“模型对训练数据学得过细”,因此第一步不是直接加 Dropout,而是比较训练集与验证集。若训练和验证表现都差,更可能是模型能力不足、优化尚未完成或数据存在问题;此时继续加强正则化通常会让结果更差。
| 训练与验证现象 | 更可能的判断 | 优先动作 |
|---|---|---|
| 训练损失和验证损失都较高 | 尚未充分拟合 | 先检查优化、模型容量和数据 |
| 训练损失持续下降,验证损失先降后升 | 典型过拟合 | 考虑正则化并保留最佳检查点 |
| 训练准确率很高,验证准确率明显落后 | 泛化差距过大 | 逐步增加正则化 |
| 两侧指标接近且仍同步改善 | 暂无明显过拟合 | 不要为了“保险”额外加码 |
还要观察差距出现的时间。如果验证损失只在训练后段开始回升,说明模型前期仍在学习有效模式,只需要限制后期继续记忆训练样本,而不是从一开始就施加强约束。
两类正则化作用在不同位置
权重衰减作用于参数更新。以 AdamW 为例,优化器在更新卷积核和全连接层权重时主动抑制参数无限增大,使模型更倾向于使用分散、平滑的特征,而不是依赖少量极端权重。
Dropout 作用于中间激活。训练阶段它会以给定概率随机屏蔽部分特征,迫使后续层不能长期依赖某几个固定神经元;调用 model.eval() 后 Dropout 自动关闭,因此推理阶段不会随机丢失特征。
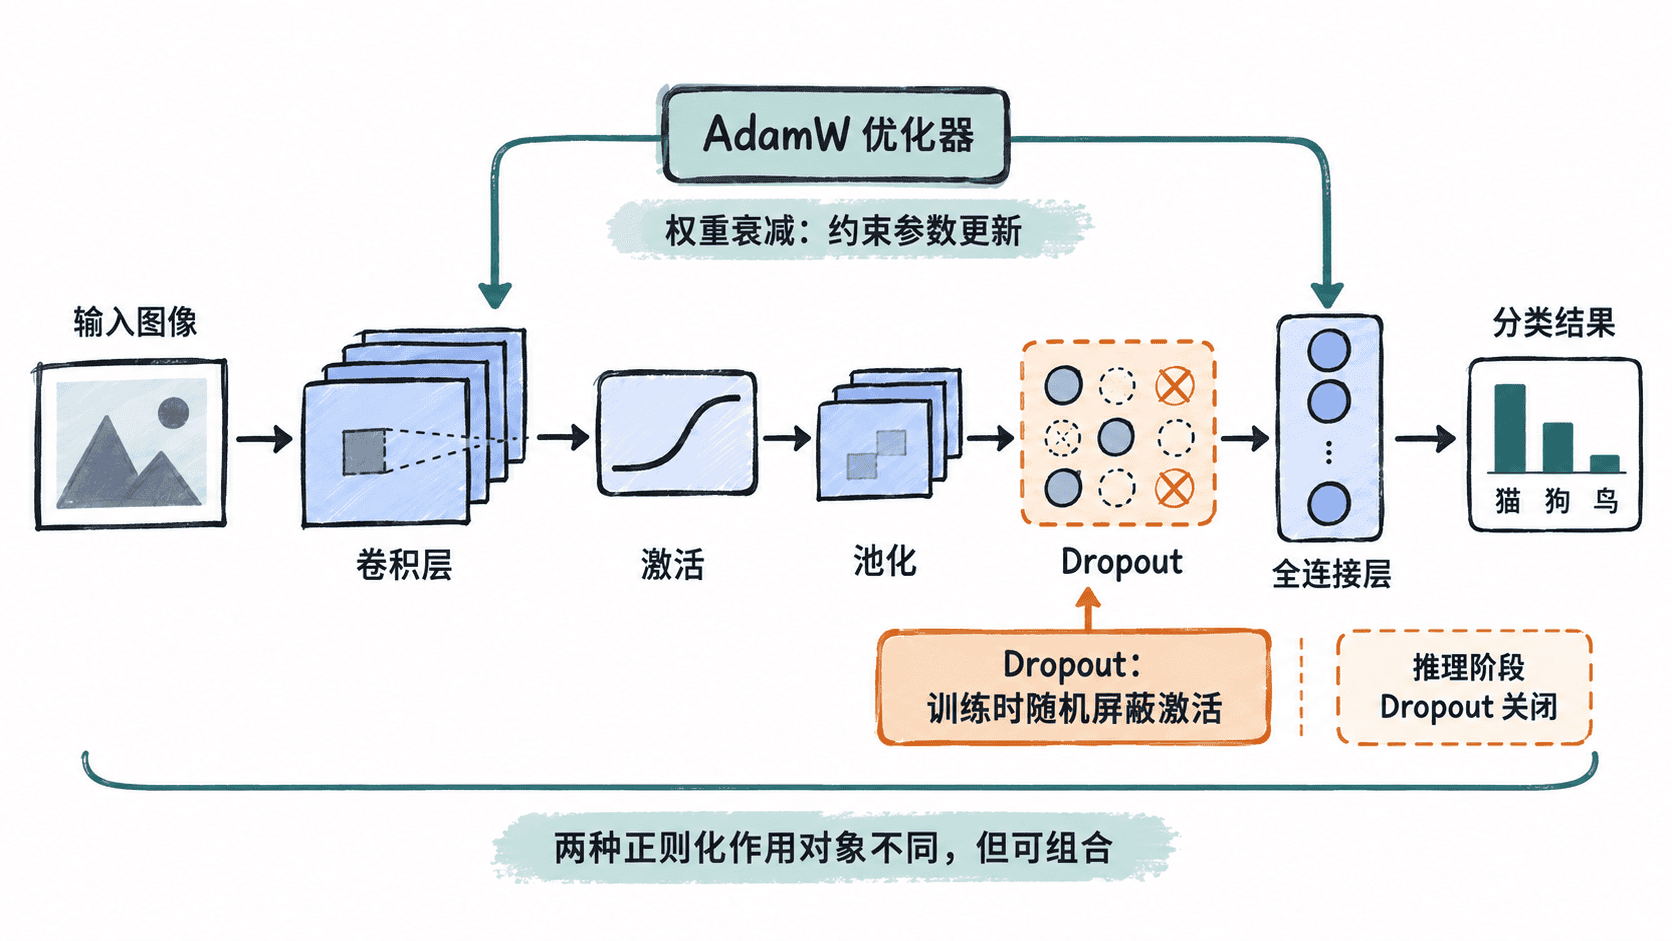
通常不应把较大的普通 Dropout 随意插入每个卷积层。对于常见图像分类网络,更容易控制的起点是在全局池化后的分类头使用 Dropout;若确实需要对卷积特征做随机屏蔽,再评估 Dropout2d 等更符合空间特征结构的方案。
在最小 CNN 中组合两种约束
下面的完整 PyTorch 示例把 Dropout 放在池化后的特征向量上,同时通过 AdamW 的 weight_decay 对可训练参数施加权重衰减。代码还执行一次前向传播,便于确认结构能够正常运行。
import torch
from torch import nn

class TinyCNN(nn.Module):
    def __init__(self) -> None:
        super().__init__()
        self.features = nn.Sequential(
            nn.Conv2d(3, 16, kernel_size=3, padding=1),
            nn.ReLU(),
            nn.AdaptiveAvgPool2d(1),
        )
        # Dropout 放在分类头前,直接约束高层特征的共同适应。
        self.dropout = nn.Dropout(p=0.3)
        self.classifier = nn.Linear(16, 10)

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        x = self.features(x)
        x = torch.flatten(x, 1)
        x = self.dropout(x)
        return self.classifier(x)

model = TinyCNN()
optimizer = torch.optim.AdamW(
    model.parameters(),
    lr=1e-3,
    weight_decay=1e-4,
)

model.train()
inputs = torch.randn(4, 3, 32, 32)
logits = model(inputs)

print(f"weight_decay={optimizer.param_groups[0]['weight_decay']}")
print(f"dropout_p={model.dropout.p}")
print(f"logits_shape={tuple(logits.shape)}")
预期输出
weight_decay=0.0001
dropout_p=0.3
logits_shape=(4, 10)
这里的 weight_decay=1e-4 和 p=0.3 只是可用于建立实验的温和起点,不是通用最优值。真正需要比较的是加入约束之后,训练与验证之间的差距是否缩小,以及最佳验证指标是否提高。
按单变量顺序增加正则化
一次同时改变权重衰减、Dropout、数据增强和网络宽度,即使结果变好,也无法判断哪项修改真正有效。更可靠的做法是固定随机种子、数据划分、优化器和学习率,只修改一个因素。
- 先训练无 Dropout 或弱正则化的基线,记录最佳验证指标和对应轮次。
- 出现明确泛化差距后,先尝试温和的权重衰减,例如从较小量级开始比较。
- 如果训练集仍明显优于验证集,再在分类头加入较低概率 Dropout。
- 每次只改变一个超参数,并同时记录训练指标、验证指标和最佳轮次。
- 若训练集性能大幅下降而验证集没有改善,应撤回最近一次正则化加码。
用验证表现决定是否保留组合
一个正则化组合值得保留,至少应满足两个条件:训练与验证之间的差距缩小,同时最佳验证指标没有下降。若只是训练准确率降低,却没有换来更好的验证结果,就不能认为正则化“生效”。
因此,组合权重衰减与 Dropout 的核心不是把所有防过拟合手段都打开,而是先确认泛化差距,再分别控制参数更新和中间激活,最后用相同实验条件下的验证结果决定每一项约束是否有价值。