
机器学习与深度学习 / 系统课时
载入预训练骨干并替换分类头
载入预训练骨干并替换分类头
迁移学习的第一步不是立刻训练,而是把预训练模型的输入规范、特征维度和分类头接口对齐。本课以 torchvision 的 ResNet-18 为例,完成权重加载、分类头替换和一次前向验证,得到可用于三分类任务的模型。
学习目标
- 使用预训练权重载入卷积骨干,并取得与权重匹配的图像预处理流程。
- 根据骨干输出特征维度替换最终分类层,而不是硬编码接口尺寸。
- 通过一次前向传播验证输入尺寸和新分类头的输出维度。
先对齐预训练模型的接口
预训练模型可以拆成两部分:前面的卷积骨干负责把图像编码成高层特征,最后的分类头把特征映射到原始训练集的类别。迁移到新任务时,通常保留已经学好的视觉表示,只把最后一层换成目标类别数对应的新层。
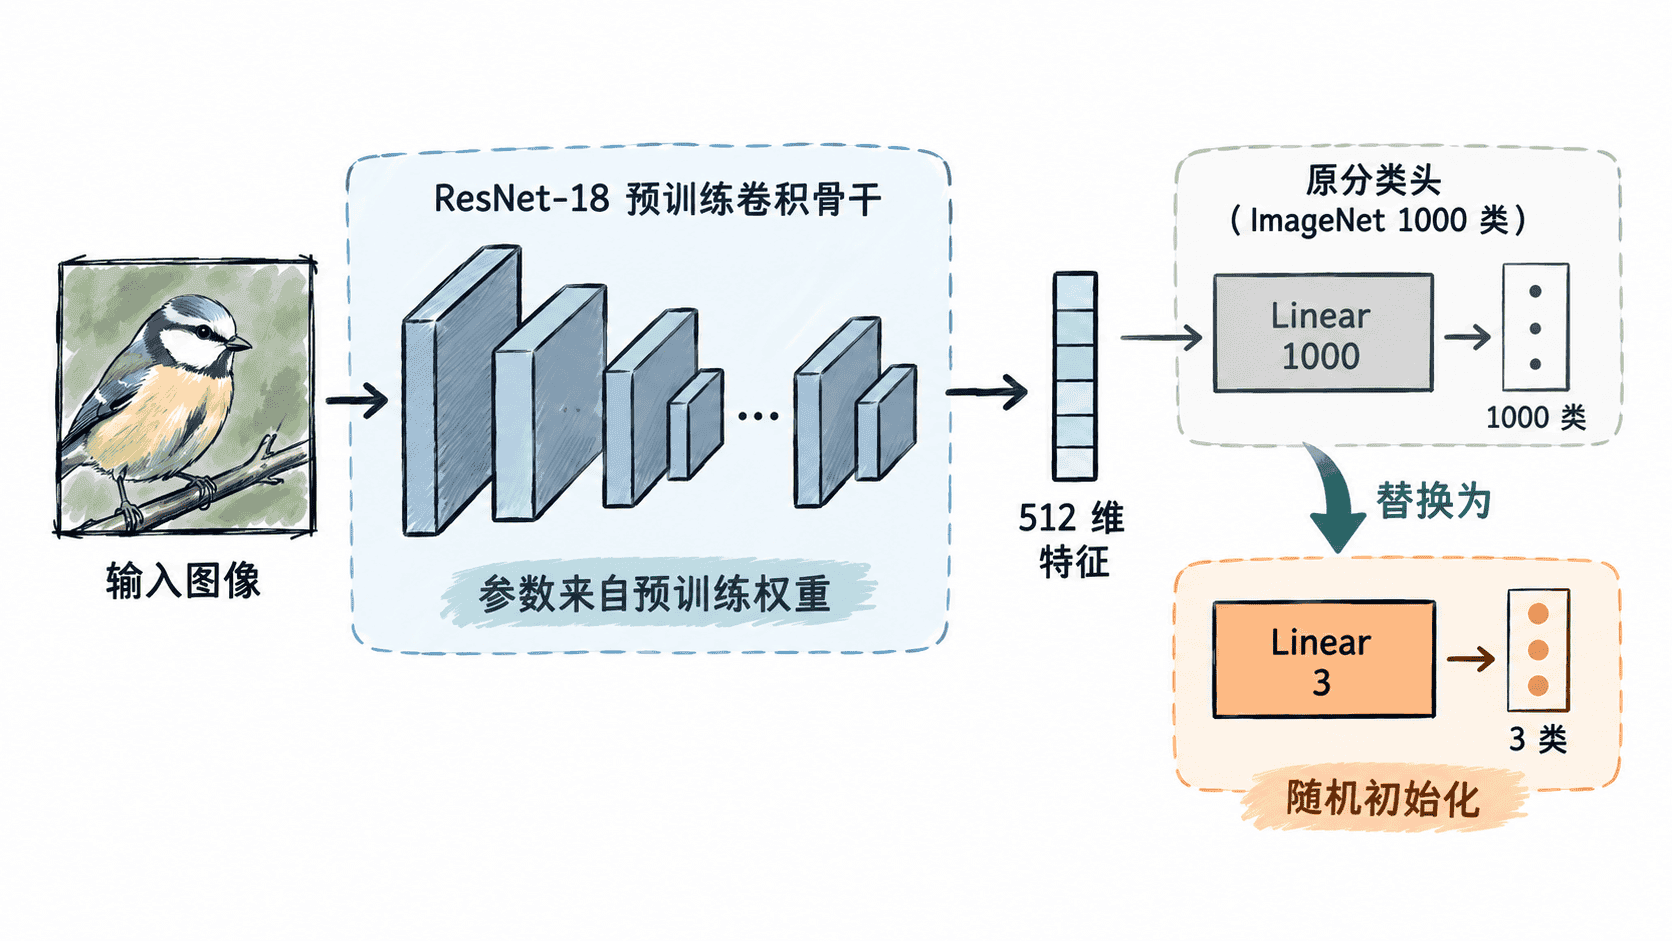
除了网络结构,还要保持预训练权重要求的输入规范。不同权重可能对应不同的缩放、裁剪和归一化参数,因此应优先使用权重对象提供的预处理配置,而不是凭经验手写一组均值和标准差。
替换最终分类层
下面的示例加载 ResNet-18 默认预训练权重,读取原分类层的输入特征数,再为三分类任务创建新的 Linear 层。首次执行如果本机没有缓存权重,需要能够下载对应权重文件。
import torch
from torch import nn
from torchvision.models import ResNet18_Weights, resnet18

num_classes = 3
weights = ResNet18_Weights.DEFAULT
model = resnet18(weights=weights)

# 从现有分类头读取接口,避免把骨干输出维度写死在业务代码中。
feature_dim = model.fc.in_features
model.fc = nn.Linear(feature_dim, num_classes)

# 预处理规则与当前预训练权重保持一致。
preprocess = weights.transforms()
images = torch.rand(2, 3, 256, 256)
inputs = preprocess(images)

model.eval()
with torch.inference_mode():
    logits = model(inputs)

print("feature_dim:", feature_dim)
print("input_shape:", tuple(inputs.shape))
print("logits_shape:", tuple(logits.shape))
预期输出
feature_dim: 512
input_shape: (2, 3, 224, 224)
logits_shape: (2, 3)
logits_shape 的第二维等于 3,说明新的分类头已经接入骨干。这里输出的是未归一化的 logits;使用 CrossEntropyLoss 训练多分类任务时,不需要在模型末尾额外添加 Softmax。
为什么要读取特征维度
直接写成 nn.Linear(512, 3) 在 ResNet-18 上虽然可用,却把代码绑定到了某个具体骨干。换成 ResNet-50、EfficientNet 或其他模型后,最后一个特征向量的维度可能不同,硬编码会立即产生矩阵维度不匹配。
因此替换分类头时应先检查模型本身暴露的接口,例如这里的 model.fc.in_features。其他架构可能把分类头放在 classifier、head 等属性中,迁移时要先确认其模块结构,再选择真正负责类别映射的最后一层。
验收迁移后的模型
完成替换后至少检查三件事:输入经过预训练权重对应的预处理后尺寸正确;骨干输出能够顺利进入新分类头;最终 logits 的最后一维等于目标类别数。如果这三项都通过,模型结构已经具备训练新任务的基本条件。
此时新分类头还是随机初始化状态,真正开始训练前还要决定是冻结骨干只训练这个新层,还是让部分甚至全部预训练参数继续更新。这个选择会直接影响训练成本和小样本条件下的过拟合风险。