
机器学习与深度学习 / 系统课时
用批归一化稳定训练过程
用批归一化稳定训练过程
Batch Normalization 的关键不只是“把数值变标准”,而是让中间特征在训练时维持可控尺度,同时保留可学习的缩放与平移能力。真正容易出错的是训练与推理阶段统计量来源不同。本篇拆开这两条路径,并用 PyTorch 验证同一张样本在 train() 与 eval() 下为何表现不同。
学习目标
- 说明
BatchNorm2d的归一化、缩放和平移分别完成什么工作。 - 区分训练阶段的批统计量与推理阶段的运行统计量。
- 通过可执行示例验证
train()、eval()对 Batch Normalization 行为的影响。
BatchNorm 的计算落在通道维度
对形状为 N × C × H × W 的卷积特征,BatchNorm2d 会对每个通道独立统计当前 mini-batch 中 N × H × W 个位置的均值与方差。训练时可把核心过程写成:
其中 ε 防止分母过小;γ 与 β 是可学习参数。先归一化再学习缩放和平移,意味着网络既能获得稳定的数值尺度,又不会被强制限制在固定的均值 0、方差 1 表达上。
训练与推理使用不同统计量
训练模式下,当前输出使用当前批次的均值和方差,同时模块会持续更新 running_mean 与 running_var。在 PyTorch 默认语义中,momentum 控制新批次统计量写入运行统计量的权重,而不是优化器里的动量概念。
推理模式下,Batch Normalization 不再依赖当前批次统计量,而是使用训练期间累计的运行统计量。这样同一张图片的输出不会因为它恰好和哪些其他图片组成一个批次而改变。调用 model.eval() 会把 Batch Normalization 切换到这条推理路径,同时也会影响 Dropout 等具有训练、推理差异的模块。
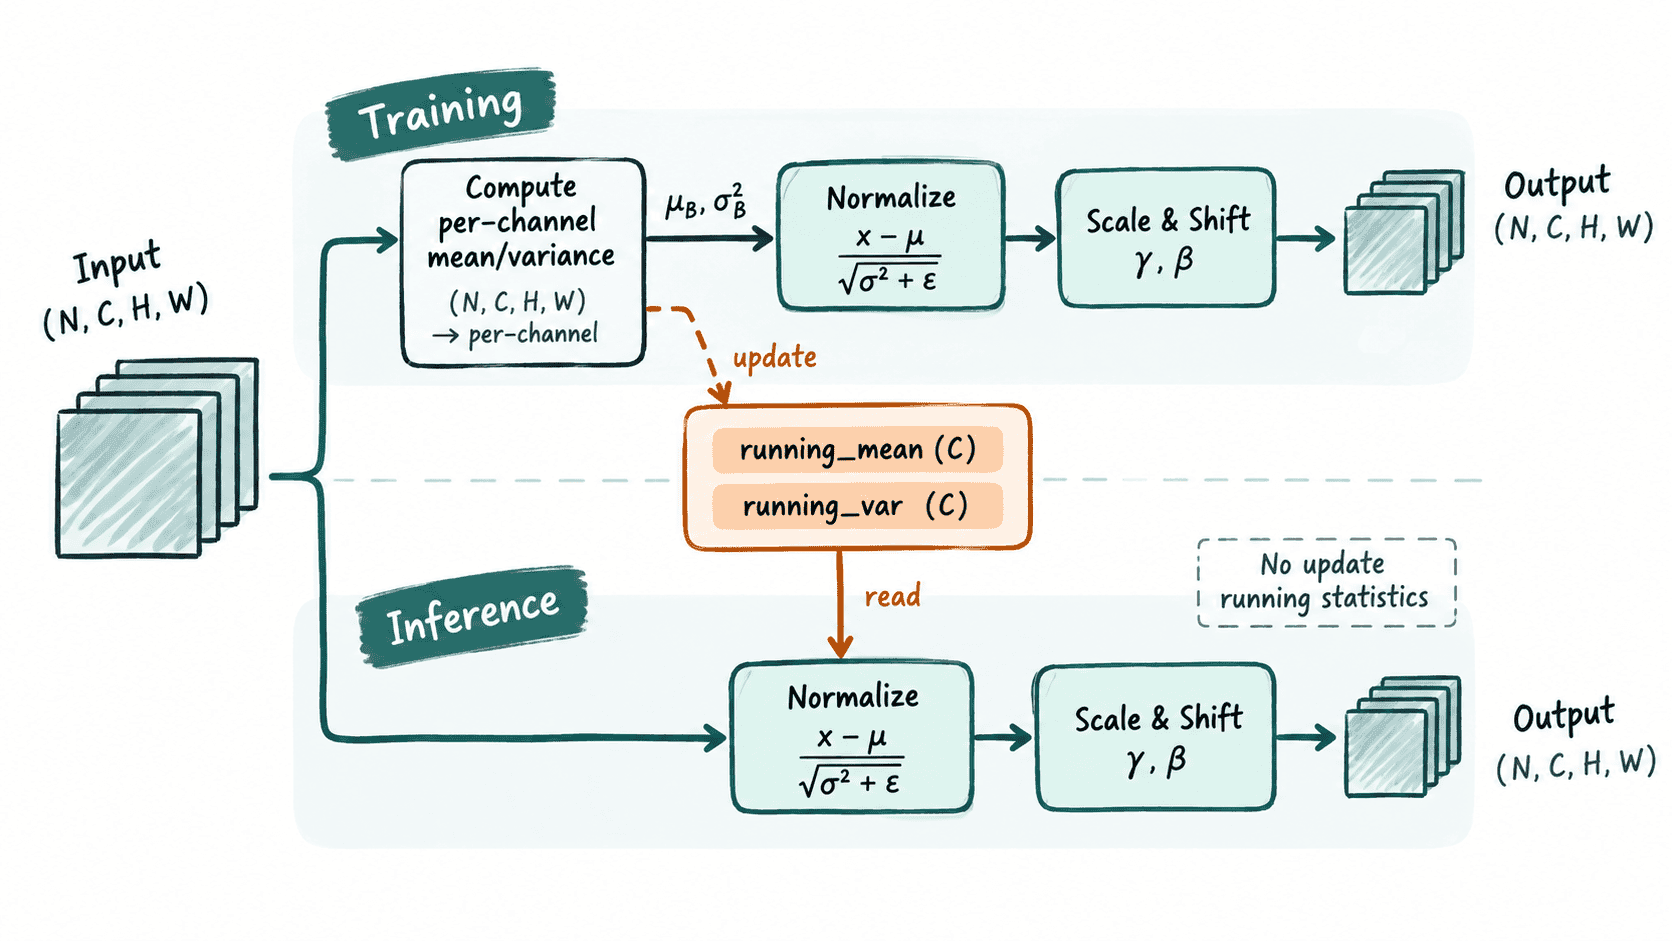
用同一张样本验证 train 与 eval
下面固定一个样本,再让它分别与全 0 和全 10 的样本组成两个批次。若 Batch Normalization 处于训练模式,同一个样本会因为批统计量不同而得到不同输出;切换到推理模式后,输出只依赖运行统计量,因此不再受同批其他样本影响。
import torch
from torch import nn

bn = nn.BatchNorm2d(1, affine=True, momentum=1.0)

with torch.no_grad():
    bn.weight.fill_(1.0)
    bn.bias.zero_()

sample = torch.ones(1, 1, 2, 2)
batch_a = torch.cat([sample, torch.zeros_like(sample)], dim=0)
batch_b = torch.cat([sample, torch.full_like(sample, 10.0)], dim=0)

bn.train()
out_a = bn(batch_a)
running_after_a = bn.running_mean.clone()
out_b = bn(batch_b)
running_after_b = bn.running_mean.clone()

print("train_same_sample_changes:", not torch.allclose(out_a[0], out_b[0]))
print("running_mean_updates:", not torch.allclose(running_after_a, running_after_b))

bn.eval()
before_eval = bn.running_mean.clone()
eval_a = bn(batch_a)
eval_b = bn(batch_b)

print("eval_same_sample_identical:", torch.allclose(eval_a[0], eval_b[0]))
print("eval_running_mean_unchanged:", torch.allclose(before_eval, bn.running_mean))
预期输出
train_same_sample_changes: True
running_mean_updates: True
eval_same_sample_identical: True
eval_running_mean_unchanged: True
示例把 momentum 设为 1.0,只是为了让运行均值的更新更容易观察;真实训练通常不需要这样设置。关键结论是:训练输出取决于当前批次,而推理输出依赖已累计的运行统计量,因此部署前必须正确切换到 eval()。
BatchNorm 为什么能让优化更稳定
归一化把每层输入维持在更可控的数值范围,减少网络对某一层权重尺度变化的敏感度,使梯度在深层网络中更容易保持可训练。γ 与 β 又允许模型在需要时恢复或改变特征尺度,因此稳定性并不是以牺牲表达能力换来的。
Batch Normalization 往往能让训练对初始化和学习率更宽容,但它不是“学习率可以无限增大”的保证。若损失突然发散,仍要同时检查初始化、学习率、数据异常和混合精度溢出,而不能只把问题归因于归一化层。
小批量与冻结统计量的边界
当每个通道参与统计的有效样本很少时,批均值和批方差会变得噪声很大,训练与推理之间的统计偏差也会加重。此时可以增大有效 batch、使用跨设备同步的 SyncBatchNorm,或在适合的任务中改用 Group Normalization 等不依赖批维度的方案。
另一个常见错误是只把 γ、β 的 requires_grad 设为 False,却仍让 Batch Normalization 处于训练模式。这样虽然可学习参数被冻结,running_mean 和 running_var 仍可能继续变化。若目标是连统计量一起冻结,应明确控制这些层的训练、推理状态,并用验证集确认微调后的分布是否仍匹配。
稳定使用 Batch Normalization 的核心判断很简单:训练时让批统计量参与当前归一化并积累运行统计,推理时固定使用运行统计;只要这两条路径没有混淆,Batch Normalization 才能把训练阶段获得的稳定性可靠带到部署阶段。