
机器学习与深度学习 / 系统课时
给分类服务建立性能基线
给分类服务建立性能基线
本节把“感觉服务挺快”变成一组可重复验证的数字。你会固定输入、请求总量和并发度,记录 P50、P95 延迟、吞吐以及 CPU、内存和可选 GPU 指标,并把测试条件一起保存,作为后续模型优化、量化或换硬件时的对照基线。
学习目标
- 设计固定输入、并发度和请求数量的分类服务基准测试。
- 正确计算 P50、P95 延迟与吞吐,并同步采集资源使用。
- 用同一测试条件判断一次优化是否真的改善了服务性能。
先固定测试条件
性能基线首先是“可重复”,其次才是“数值好看”。至少要固定服务版本、模型版本、输入图片、预处理、实例规格、线程数、batch 大小、并发度、请求总量和是否开启冷启动。
延迟与吞吐衡量的不是同一个问题。P50 代表多数请求的典型体验,P95 更容易暴露排队、GC、数据拷贝或 GPU 抢占造成的长尾;吞吐则表示单位时间内服务能完成多少请求。只看平均延迟会把长尾隐藏掉。
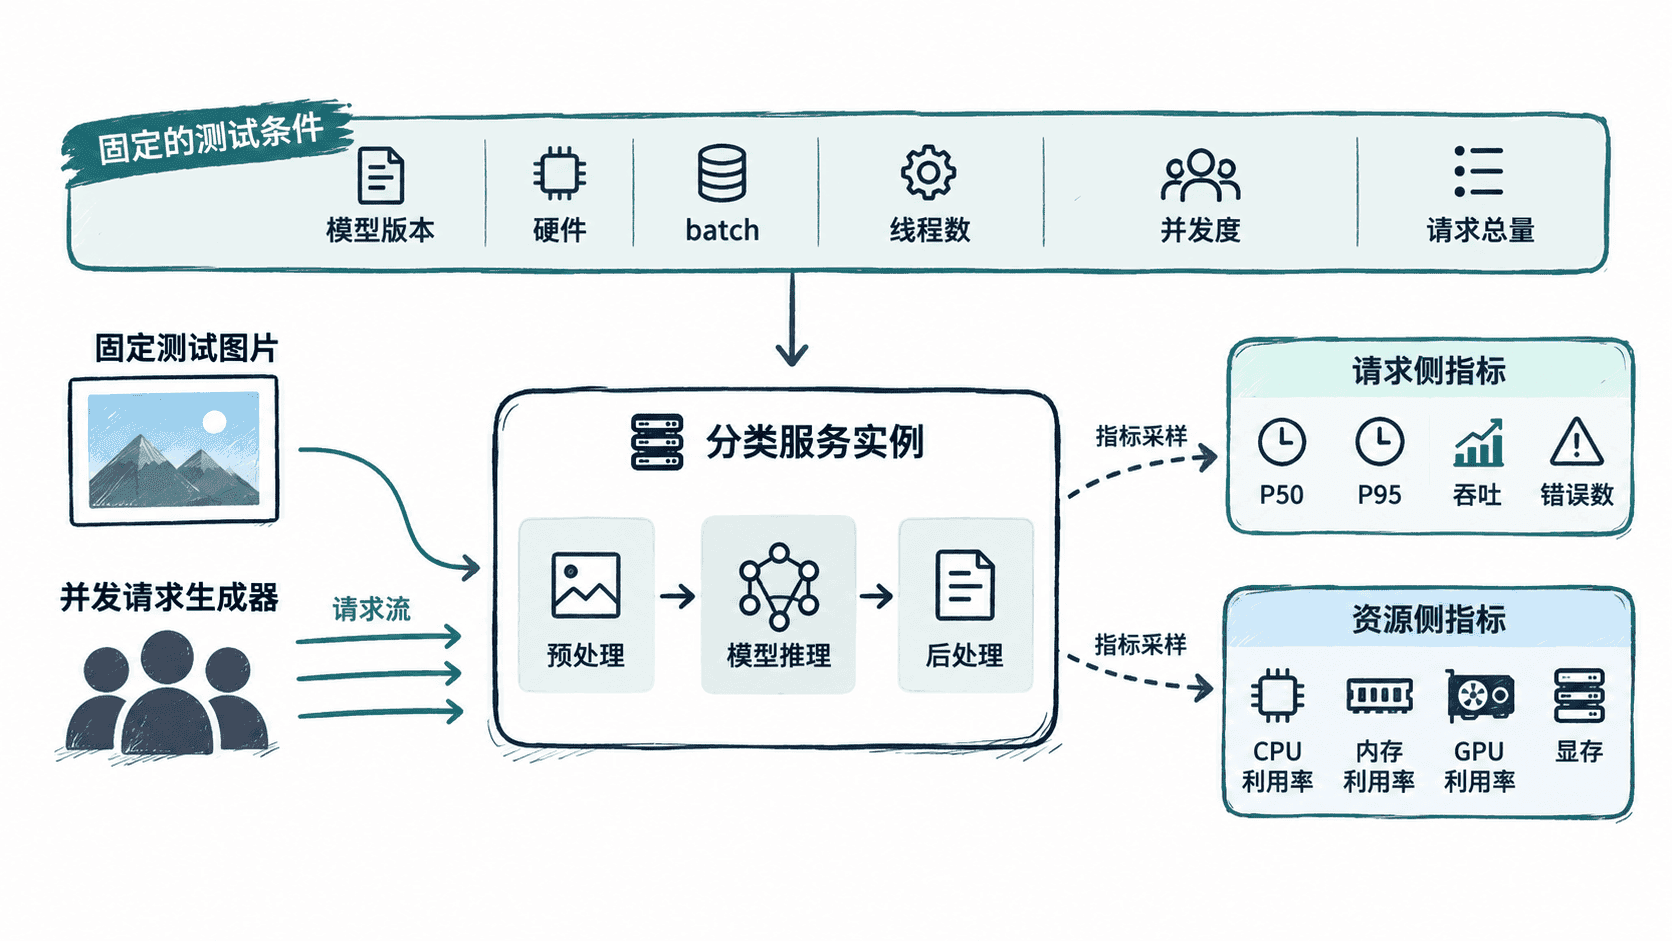
跑一个固定并发基线
下面的脚本假设分类接口为 POST /predict,请求体直接发送同一张图片的二进制数据。若服务与压测脚本运行在同一台机器,可通过 --pid 同步采集该进程的 CPU 与 RSS 内存;若安装了 nvidia-smi,脚本还会记录第一张 GPU 的平均利用率和显存占用。
import argparse
import concurrent.futures
import statistics
import subprocess
import threading
import time

import psutil
import requests

def percentile(values, p):
    ordered = sorted(values)
    index = round((len(ordered) - 1) * p)
    return ordered[index]

def read_gpu():
    try:
        result = subprocess.run(
            [
                "nvidia-smi",
                "--query-gpu=utilization.gpu,memory.used",
                "--format=csv,noheader,nounits",
            ],
            capture_output=True,
            text=True,
            timeout=2,
            check=True,
        )
        first = result.stdout.strip().splitlines()[0]
        util, memory = [float(x.strip()) for x in first.split(",")]
        return util, memory
    except (FileNotFoundError, subprocess.SubprocessError, IndexError, ValueError):
        return None

def main():
    parser = argparse.ArgumentParser()
    parser.add_argument("--url", required=True)
    parser.add_argument("--image", required=True)
    parser.add_argument("--requests", type=int, default=200)
    parser.add_argument("--concurrency", type=int, default=8)
    parser.add_argument("--pid", type=int)
    args = parser.parse_args()

    payload = open(args.image, "rb").read()
    local = threading.local()
    stop = threading.Event()
    cpu_samples, mem_samples, gpu_samples = [], [], []

    process = psutil.Process(args.pid) if args.pid else None
    if process:
        process.cpu_percent(None)

    def sample_resources():
        # 资源采样与压测并行,避免只看到测试结束后的静态值。
        while not stop.is_set():
            if process:
                cpu_samples.append(process.cpu_percent(None))
                mem_samples.append(process.memory_info().rss / 1024 / 1024)
            gpu = read_gpu()
            if gpu:
                gpu_samples.append(gpu)
            stop.wait(0.5)

    def send_one(_):
        # 每个工作线程复用自己的连接,避免共享 Session 的线程安全问题。
        if not hasattr(local, "session"):
            local.session = requests.Session()
        start = time.perf_counter()
        try:
            response = local.session.post(
                args.url,
                data=payload,
                headers={"Content-Type": "application/octet-stream"},
                timeout=30,
            )
            code = response.status_code
        except requests.RequestException:
            code = 0
        elapsed_ms = (time.perf_counter() - start) * 1000
        return code, elapsed_ms

    # 固定并发度执行全部请求,同时采集服务资源曲线。
    sampler = threading.Thread(target=sample_resources, daemon=True)
    sampler.start()

    start = time.perf_counter()
    with concurrent.futures.ThreadPoolExecutor(
        max_workers=args.concurrency
    ) as pool:
        results = list(pool.map(send_one, range(args.requests)))
    wall = time.perf_counter() - start

    stop.set()
    sampler.join(timeout=2)

    # 只用成功请求计算延迟分位数,同时单独报告失败数量。
    ok_latencies = [ms for code, ms in results if 200 <= code < 300]
    errors = len(results) - len(ok_latencies)
    if not ok_latencies:
        raise SystemExit("no successful requests")

    print(f"success={len(ok_latencies)}/{len(results)} errors={errors}")
    print(f"p50_ms={percentile(ok_latencies, 0.50):.2f}")
    print(f"p95_ms={percentile(ok_latencies, 0.95):.2f}")
    print(f"throughput_rps={len(ok_latencies) / wall:.2f}")

    if cpu_samples:
        print(f"cpu_avg_pct={statistics.fmean(cpu_samples):.1f}")
        print(f"rss_avg_mb={statistics.fmean(mem_samples):.1f}")
    else:
        print("cpu_avg_pct=n/a")
        print("rss_avg_mb=n/a")

    if gpu_samples:
        print(f"gpu_avg_pct={statistics.fmean(x[0] for x in gpu_samples):.1f}")
        print(f"gpu_mem_avg_mb={statistics.fmean(x[1] for x in gpu_samples):.1f}")
    else:
        print("gpu_avg_pct=n/a")
        print("gpu_mem_avg_mb=n/a")

if __name__ == "__main__":
    main()
预期输出
success=200/200 errors=0
p50_ms=<TIME>
p95_ms=<TIME>
throughput_rps=<RATE>
cpu_avg_pct=<PERCENT>
rss_avg_mb=<MEMORY>
gpu_avg_pct=<PERCENT|n/a>
gpu_mem_avg_mb=<MEMORY|n/a>
保存脚本为 bench.py 后,运行时把服务地址传给 --url、固定测试图片传给 --image,并显式设置 --requests 与 --concurrency。服务在本机时再传入进程 --pid;服务在远端时省略该参数,CPU 与 RSS 会显示 n/a。
读懂基线而不是只记一个数字
先看错误数。只要压测过程中出现非预期的 4xx/5xx、超时或连接失败,当前延迟和吞吐就不能作为健康基线,因为服务可能通过“更快地失败”获得了虚假的性能提升。
然后同时看 P50、P95 与吞吐。如果 P50 基本不变而 P95 明显升高,通常意味着高并发下开始排队或争用;如果延迟下降但 CPU 长期接近饱和,说明优化可能只是把硬件推到了没有余量的状态。GPU 服务还要结合显存占用判断能否承受更大的 batch 或更多副本。
把一次测试变成可比较记录
基线记录至少保留测试日期、代码或镜像版本、模型版本、硬件、并发度、请求总量、固定输入集合、P50、P95、吞吐、错误数和资源指标。以后做 INT8 量化、修改预处理、换推理引擎或调整线程数时,只改变一个主要变量,再重复同一套测试。
一个有效结论应类似“在同一实例、同一输入和并发 8 下,P95 从 A 降到 B,同时吞吐提升且准确率不变”,而不是“新版本看起来更快”。当测试条件可复现、指标维度完整时,这份基线才真正能约束优化,而不是成为一次性的漂亮数字。