
机器学习与深度学习 / 系统课时
拆解 LeNet 的层级结构
拆解 LeNet 的层级结构
本篇用 LeNet 的经典前向路径练习“读网络”:从输入尺寸开始,逐层计算空间大小、通道数和参数量,并把结构图与代码中的卷积、池化和分类层一一对应。完成后,你可以不依赖框架摘要,也能判断一个卷积网络在每一层把数据变成了什么形状。
学习目标
- 沿 LeNet 路径计算特征图的高、宽和通道数
- 用卷积核、输入通道和输出通道估算层参数量
- 区分原始 LeNet-5 与现代教学版 LeNet 的常见差异
先沿数据流读结构
采用常见的现代化 LeNet-5 教学结构时,输入可写成 1×32×32。第一个 5×5 卷积把通道从 1 提升到 6,空间尺寸从 32 降到 28;2×2、步幅 2 的池化再把空间尺寸减半。随后第二个 5×5 卷积把通道提升到 16,再经过一次池化得到 16×5×5。
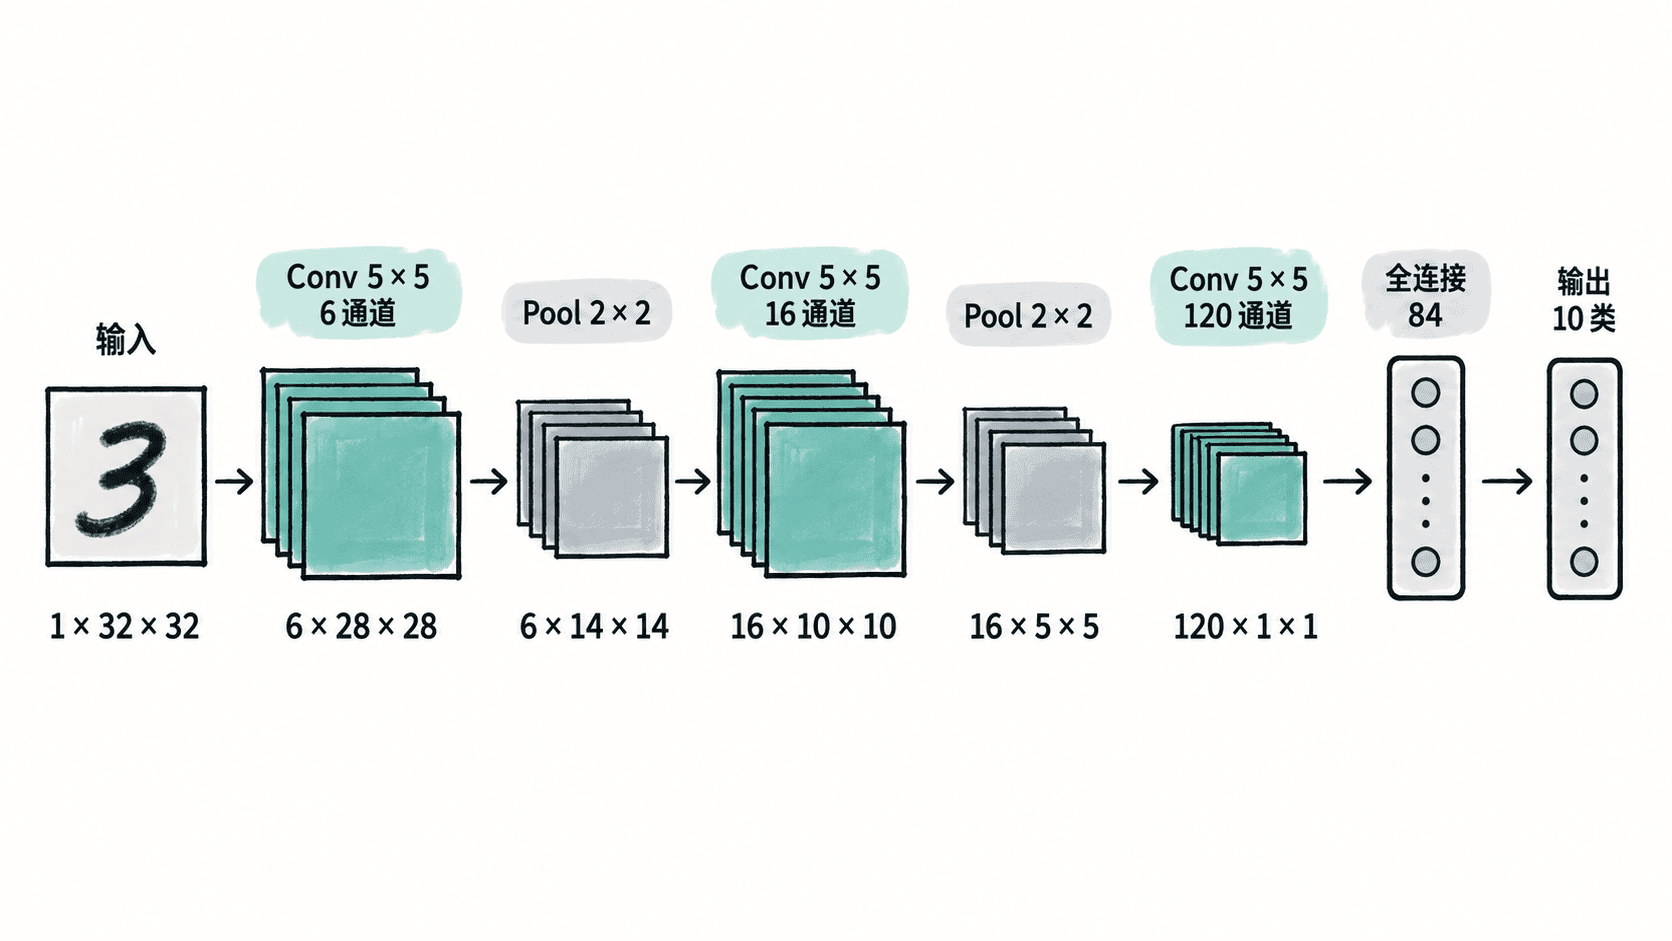
读这种结构时,先看空间尺寸,再看通道变化。对无填充、步幅 1 的卷积,单个空间维度满足:
因此 32→28、14→10、5→1 都来自 5×5 卷积。池化不改变通道数,只按步幅压缩空间尺寸。
参数量和尺寸要分开看
卷积层参数量不由特征图面积决定,而由卷积核大小和通道连接决定。现代“全连接通道”的卷积层参数量可写成:
末尾的 1 表示每个输出通道一个偏置。以第二个卷积为例,6→16、卷积核 5×5,参数量是 16×(6×25+1)=2416。即使输入特征图是 14×14,卷积核参数仍会在所有空间位置共享。
下面的 Python 脚本同时核对形状与参数量。这里使用现代教学版的“通道完全连接”假设,因此参数量不等同于 1998 年原始 LeNet-5 的精确配置。
layers = [
    ("conv1", (1, 32, 32), 6, 5, 1),
    ("pool1", (6, 28, 28), 6, 2, 2),
    ("conv2", (6, 14, 14), 16, 5, 1),
    ("pool2", (16, 10, 10), 16, 2, 2),
    ("conv3", (16, 5, 5), 120, 5, 1),
]

total_params = 0
for name, (cin, h, w), cout, kernel, stride in layers:
    # 卷积与池化都按无填充公式计算输出空间尺寸。
    out_h = (h - kernel) // stride + 1
    out_w = (w - kernel) // stride + 1
    params = 0 if name.startswith("pool") else cout * (cin * kernel * kernel + 1)
    total_params += params
    print(f"{name}: {cout}x{out_h}x{out_w}, params={params}")

# 1×1×120 展平后进入 84 单元分类层,再映射到 10 类。
fc6 = 84 * (120 + 1)
out = 10 * (84 + 1)
total_params += fc6 + out
print(f"fc6 params={fc6}")
print(f"output params={out}")
print(f"total params={total_params}")
预期输出
conv1: 6x28x28, params=156
pool1: 6x14x14, params=0
conv2: 16x10x10, params=2416
pool2: 16x5x5, params=0
conv3: 120x1x1, params=48120
fc6 params=10164
output params=850
total params=61706
从结构图反推模型代码
看到 Conv → Pool → Conv → Pool → Conv/Flatten → Linear 时,不要只记层名,而要为每层维护一张“形状账本”。只要某层的输入通道对不上上一层输出通道,或全连接层的输入特征数与展平结果不一致,模型就会在运行时暴露尺寸错误。
例如第二次池化后是 16×5×5,展平后就是 400 个值;经典 LeNet-5 用一个覆盖整个 5×5 空间的卷积得到 120 个 1×1 特征,也可以在现代实现中改写成接收 400 个输入的全连接层,但两种代码形态不能混着抄。
原始 LeNet-5 不是今天的模板代码
原始 LeNet-5 的 C3 层并非每个输出特征图都连接全部 6 个输入特征图,子采样层也带有可学习参数;现代课程和框架示例通常把它简化为标准卷积与池化。因此,结构阅读方法可以沿用,精确参数量必须以实际实现为准。
真正需要掌握的不是背下 6、16、120、84 这些数字,而是能沿任意 CNN 的数据流持续回答三个问题:当前张量多大、这一层为什么改变它、这一层为此引入了多少可学习参数。