
机器学习与深度学习 / 系统课时
用池化压缩空间分辨率
用池化压缩空间分辨率
池化把相邻区域压缩成更少的空间位置,使后续层用更低的计算量处理更大的感受范围。本节通过可运行示例比较最大池化与平均池化,并说明什么时候应继续使用池化,什么时候可以改用带步幅的卷积。
学习目标
- 说明池化如何降低特征图宽高并扩大后续单元的有效观察范围
- 比较最大池化与平均池化保留局部信息的差异
- 判断池化与步幅卷积在模型设计中的取舍
池化压缩的是空间位置
池化通常独立处理每个通道,在一个局部窗口内计算代表值,再按步幅移动窗口。例如对 4x4 特征图使用 2x2 窗口和步幅 2,每四个相邻位置被压缩成一个位置,输出宽高都减半,空间元素数量从 16 降到 4。
池化本身不会像普通卷积那样混合不同通道。它主要改变宽高,因此一个 C x H x W 特征图经过上述池化后会变成 C x H/2 x W/2,通道数 C 保持不变。
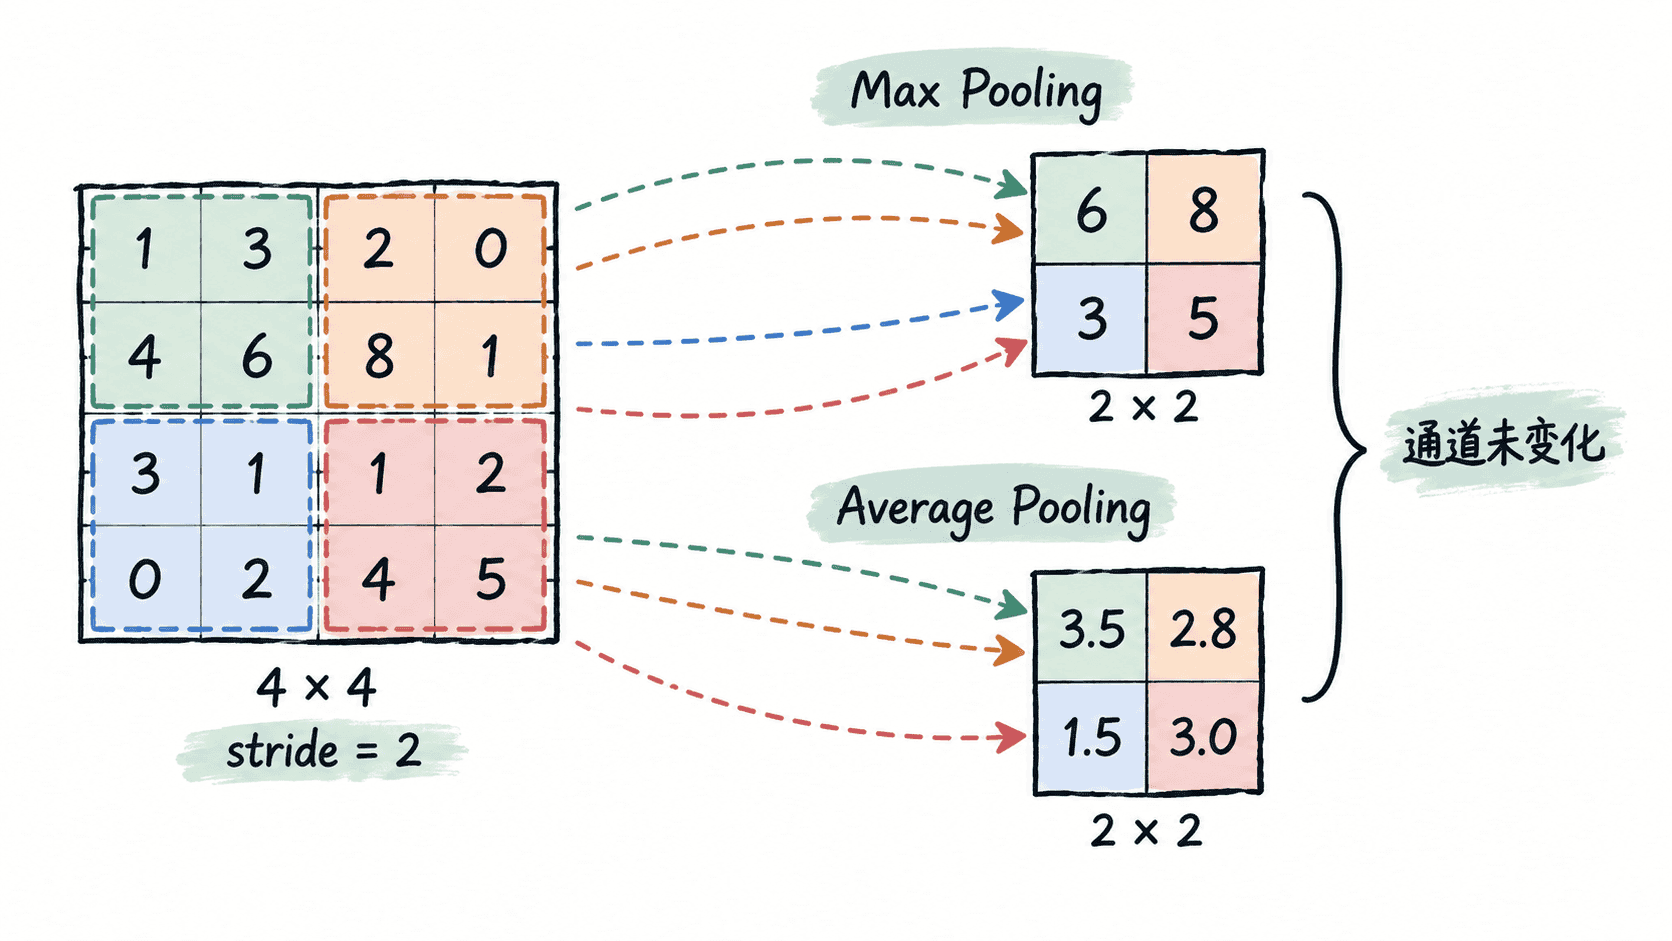
最大池化与平均池化保留的信息不同
最大池化只保留窗口中的最大响应,适合回答“这个局部区域是否出现了强特征”。边缘、纹理或某些激活峰值较突出时,它能让强响应在降采样后继续存在,但弱响应会被完全丢弃。
平均池化保留的是局部总体水平。它不会特别偏向峰值,因此结果通常更平滑,但一个很强的局部响应也会被周围较小数值稀释。二者没有绝对优劣,区别在于希望降采样后留下“最强证据”还是“平均统计”。
下面用纯 Python 对同一个 4x4 特征图执行两种 2x2、步幅 2 的池化。
from typing import Callable, List

Matrix = List[List[float]]

def pool2d(matrix: Matrix, reducer: Callable[[List[float]], float]) -> Matrix:
    output: Matrix = []
    # 2x2 窗口按步幅 2 移动,因此窗口之间不重叠。
    for row in range(0, len(matrix), 2):
        output_row = []
        for col in range(0, len(matrix[0]), 2):
            window = [
                matrix[row][col], matrix[row][col + 1],
                matrix[row + 1][col], matrix[row + 1][col + 1],
            ]
            output_row.append(reducer(window))
        output.append(output_row)
    return output

def average(values: List[float]) -> float:
    return sum(values) / len(values)

def main() -> None:
    feature = [
        [1, 3, 2, 0],
        [4, 6, 1, 2],
        [7, 2, 8, 4],
        [3, 5, 6, 9],
    ]
    print("max:", pool2d(feature, max))
    print("avg:", pool2d(feature, average))

if __name__ == "__main__":
    main()
预期输出
max: [[6, 2], [7, 9]]
avg: [[3.5, 1.25], [4.25, 6.75]]
同一组窗口产生了完全不同的表示:最大池化留下 6、2、7、9 这些局部峰值,而平均池化保留每块区域的整体水平。模型后续层实际接收到的特征因此会不同。
降采样会换来更低的计算量
空间宽高各减半后,特征图位置数量约变为原来的四分之一。后续卷积需要处理的位置更少,因此显存占用和计算量通常都会下降。同时,一个后续单元对应到原图上的区域会更大,这也是池化帮助逐层扩大有效感受范围的重要原因。
代价同样明确:降采样不可逆地丢失空间细节。分类网络通常能够容忍逐步压缩,但分割、关键点定位等任务需要精确位置时,不能过早或过频繁地降低分辨率。
什么时候用步幅卷积替代池化
步幅为 2 的卷积同样可以降低宽高,而且卷积核参数能够通过训练学习“应该保留什么”。这使它比固定的最大值或平均值规则更灵活,也可以在降采样的同时调整通道数。
| 方式 | 是否有可学习参数 | 能否调整通道数 | 典型特点 |
|---|---|---|---|
| 最大池化 | 否 | 否 | 保留局部最强响应 |
| 平均池化 | 否 | 否 | 保留局部平均统计 |
| 步幅卷积 | 是 | 是 | 降采样规则可由训练学习 |
如果目标是使用简单、稳定且几乎没有额外参数的降采样,池化依然合适;如果希望降采样行为也参与学习,或者需要同时改变通道数,步幅卷积通常更自然。二者都不是免费的空间压缩:每次把分辨率降低之前,都应先确认后续任务是否仍需要被丢弃的位置细节。