
机器学习与深度学习 / 系统课时
用量化压缩模型与加速推理
用量化压缩模型与加速推理
本节把一个可运行的 CNN 从 FP32 转成 INT8,并用同一批数据比较模型体积、单样本延迟和分类准确率。你会看到量化真正改变的是权重与算子表示,而“更小”通常成立,“更快”和“精度几乎不掉”则必须通过基准测试验证。
学习目标
- 解释后训练静态量化如何把 FP32 权重与激活映射到 INT8。
- 完成校准、转换,并比较量化前后的体积、延迟和准确率。
- 根据精度损失与硬件表现判断量化是否值得上线。
量化改变了什么
常见 INT8 量化会为浮点张量选择缩放因子与零点,用离散整数近似原始数值。直观地说,权重从每个元素约 4 字节的 FP32 变成约 1 字节的 INT8,同时推理引擎可以调用整数卷积和矩阵乘法。
但量化不是简单把文件“转成整数”。静态量化还需要用一批具有代表性的输入做校准,估计激活范围。如果校准数据偏离线上分布,极端值可能被截断,最终表现为分类精度下降。
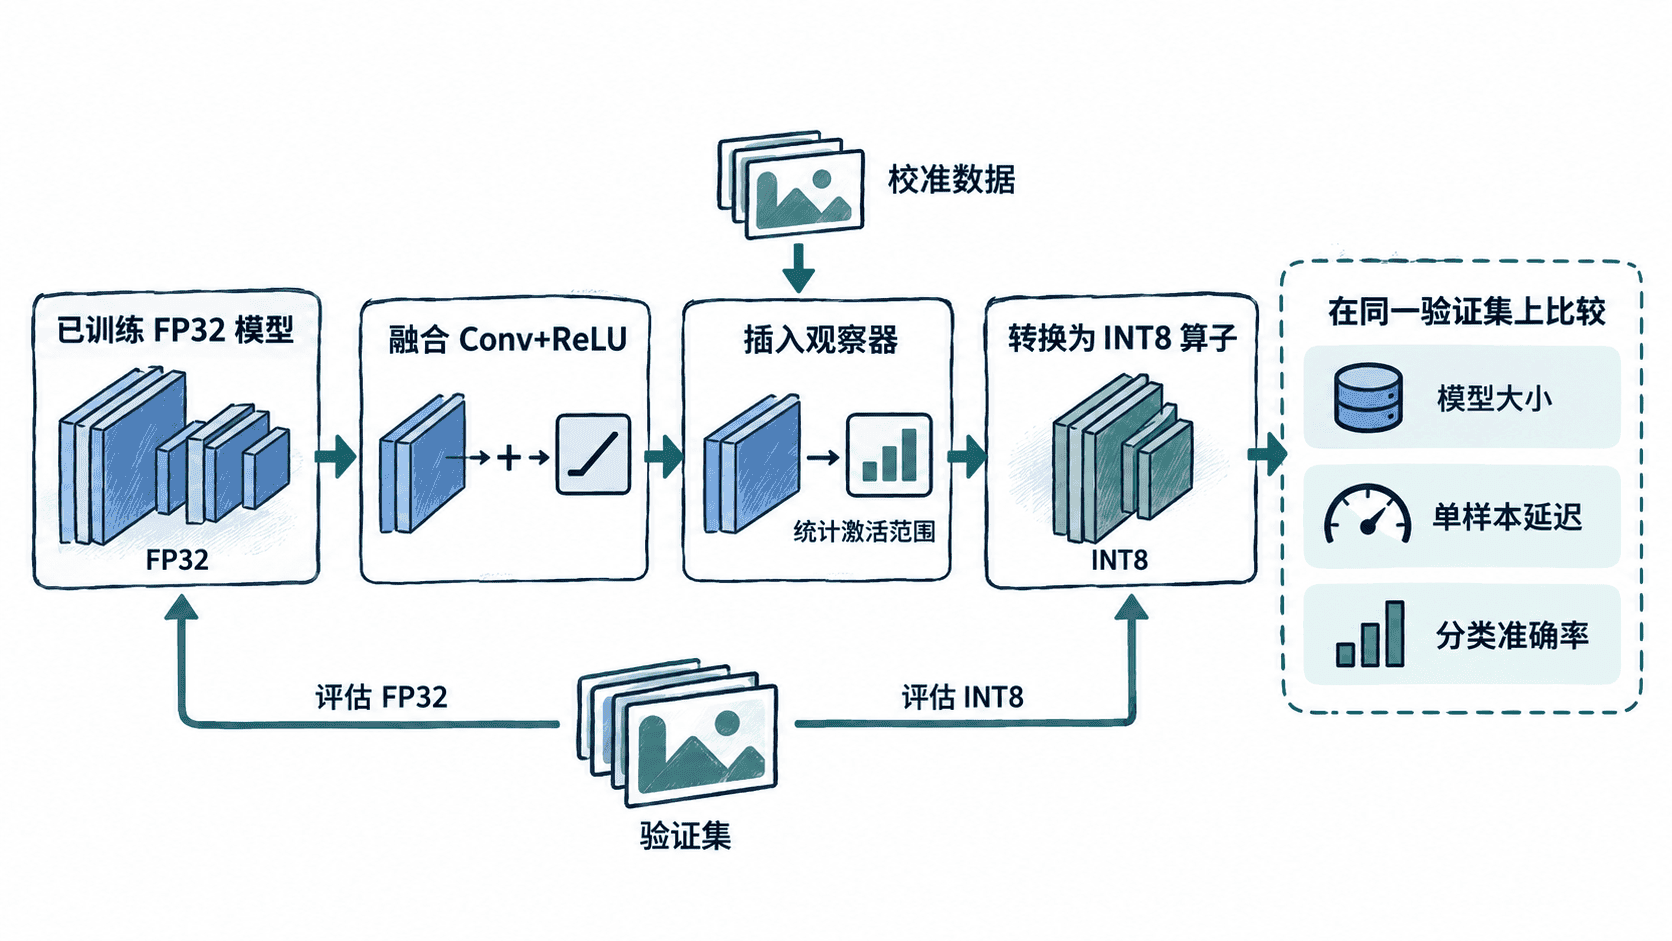
量化收益还取决于后端。桌面或服务器 CPU 往往对 INT8 支持较成熟;GPU 是否更快则取决于具体设备、推理引擎和批量大小。对于很小的网络,量化/反量化和调度开销甚至可能抵消整数计算的收益。
跑一次可复现的量化对比
下面的脚本使用 scikit-learn 自带的手写数字数据集,不需要下载外部图片。它先训练一个小型 CNN,再进行后训练静态量化,并在同一验证集上比较准确率、序列化体积和 batch=1 延迟。安装依赖后可直接运行。
import copy
import io
import time

import numpy as np
import torch
from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split
from torch import nn
from torch.ao.quantization import DeQuantStub, QuantStub

torch.manual_seed(7)
np.random.seed(7)
torch.set_num_threads(1)

class DigitCNN(nn.Module):
    def __init__(self):
        super().__init__()
        self.quant = QuantStub()
        self.conv1 = nn.Conv2d(1, 16, 3, padding=1)
        self.relu1 = nn.ReLU()
        self.conv2 = nn.Conv2d(16, 32, 3, padding=1)
        self.relu2 = nn.ReLU()
        self.fc = nn.Linear(32 * 8 * 8, 10)
        self.dequant = DeQuantStub()

    def forward(self, x):
        x = self.quant(x)
        x = self.relu1(self.conv1(x))
        x = self.relu2(self.conv2(x))
        x = torch.flatten(x, 1)
        x = self.fc(x)
        return self.dequant(x)

def accuracy(model, x, y):
    model.eval()
    with torch.inference_mode():
        pred = model(x).argmax(dim=1)
    return (pred == y).float().mean().item()

def serialized_kb(model):
    buffer = io.BytesIO()
    torch.save(model.state_dict(), buffer)
    return len(buffer.getvalue()) / 1024

def latency_ms(model, sample, rounds=500):
    model.eval()
    with torch.inference_mode():
        for _ in range(50):
            model(sample)
        start = time.perf_counter()
        for _ in range(rounds):
            model(sample)
    return (time.perf_counter() - start) * 1000 / rounds

digits = load_digits()
x = (digits.images.astype("float32") / 16.0)[:, None, :, :]
y = digits.target.astype("int64")

x_train, x_test, y_train, y_test = train_test_split(
    x, y, test_size=0.25, random_state=7, stratify=y
)
x_train = torch.from_numpy(x_train)
y_train = torch.from_numpy(y_train)
x_test = torch.from_numpy(x_test)
y_test = torch.from_numpy(y_test)

# 先训练 FP32 基线,量化只发生在训练完成之后。
fp32 = DigitCNN()
optimizer = torch.optim.Adam(fp32.parameters(), lr=0.01)
loss_fn = nn.CrossEntropyLoss()

fp32.train()
for _ in range(15):
    optimizer.zero_grad()
    loss = loss_fn(fp32(x_train), y_train)
    loss.backward()
    optimizer.step()

fp32.eval()
int8 = copy.deepcopy(fp32)

# 优先使用 x86 量化后端;不可用时回退到其他常见 CPU 后端。
supported = torch.backends.quantized.supported_engines
if "x86" in supported:
    engine = "x86"
elif "fbgemm" in supported:
    engine = "fbgemm"
else:
    engine = "qnnpack"
torch.backends.quantized.engine = engine

torch.ao.quantization.fuse_modules(
    int8,
    [["conv1", "relu1"], ["conv2", "relu2"]],
    inplace=True,
)
int8.qconfig = torch.ao.quantization.get_default_qconfig(engine)
torch.ao.quantization.prepare(int8, inplace=True)

# 校准只做前向推理,目的是让观察器收集激活范围。
with torch.inference_mode():
    for start in range(0, min(512, len(x_train)), 64):
        int8(x_train[start:start + 64])

torch.ao.quantization.convert(int8, inplace=True)

# 使用同一验证集和同一单样本输入比较精度与延迟。
sample = x_test[:1]
fp32_acc = accuracy(fp32, x_test, y_test)
int8_acc = accuracy(int8, x_test, y_test)

print(f"backend={engine}")
print(f"fp32_size_kb={serialized_kb(fp32):.1f}")
print(f"int8_size_kb={serialized_kb(int8):.1f}")
print(f"fp32_latency_ms={latency_ms(fp32, sample):.3f}")
print(f"int8_latency_ms={latency_ms(int8, sample):.3f}")
print(f"fp32_accuracy={fp32_acc:.4f}")
print(f"int8_accuracy={int8_acc:.4f}")
print(f"accuracy_drop={fp32_acc - int8_acc:.4f}")
预期输出
backend=<BACKEND>
fp32_size_kb=<FP32_SIZE_KB>
int8_size_kb=<INT8_SIZE_KB>
fp32_latency_ms=<TIME>
int8_latency_ms=<TIME>
fp32_accuracy=<FP32_ACCURACY>
int8_accuracy=<INT8_ACCURACY>
accuracy_drop=<ACCURACY_DROP>
这些数值会随 PyTorch 版本、CPU 和运行负载变化,因此不应把某台开发机的一次结果写成固定门槛。真正需要观察的是同一环境中的相对变化:INT8 文件是否明显变小、P50/P95 是否改善,以及准确率损失是否落在业务可接受范围内。
正确比较量化前后结果
量化实验必须固定模型、输入集、预处理、线程数和批量大小,否则“加速”很容易来自测试条件变化。尤其是图像分类服务,batch=1 的在线延迟和大 batch 的离线吞吐可能得出相反结论。
准确率比较也必须使用真实验证集。上面的 digits 数据集只是可复现演示;换成自己的模型时,应使用与上线分布一致的验证数据,并同时记录整体准确率与关键类别的召回率。如果整体只下降 0.2%,却让少数高价值类别召回率明显下滑,这个量化版本仍不适合发布。
决定是否上线量化模型
可以把决策压缩成三个问题:体积下降是否足够、延迟或吞吐是否改善、精度损失是否可接受。三者至少要有明确收益且不能破坏服务目标,量化才有部署价值。
对于 CPU 分类服务,后训练 INT8 往往是最先尝试的方案;若精度损失过大,再考虑量化感知训练。对于已经由 GPU 高效执行的模型,则应先确认目标推理引擎支持的精度路径,再决定使用 INT8、FP16 还是保持 FP32。