
机器学习与深度学习 / 系统课时
用批处理提升推理吞吐
用批处理提升推理吞吐
批处理能把多张图片合并成一次前向计算,提高 GPU 或向量化硬件的利用率,但 batch 越大并不代表在线服务越快。本节通过可重复基准测试同时测量吞吐、单批延迟和峰值显存,再据此选择服务侧合理的 batch size。
学习目标
- 测量不同 batch size 下的吞吐和单批推理延迟
- 观察批量增大对显存占用与硬件利用率的影响
- 根据在线延迟目标而不是单一吞吐指标选择批量大小
批处理为什么能提高吞吐
单张图片推理时,很多算子的并行资源没有被完全占满;把多张图片沿 batch 维拼接后,同一组卷积和矩阵运算可以一次处理更多数据,固定调度开销也被更多样本分摊。因此在一定范围内,batch 增大会提高每秒处理图片数。
但服务请求通常不是同时到达。为了凑够一个 batch,系统可能先把请求放入队列等待;batch 继续增大后,计算时间和显存也会上升。于是吞吐、计算延迟、排队延迟和显存之间形成权衡,而不是“越大越好”。
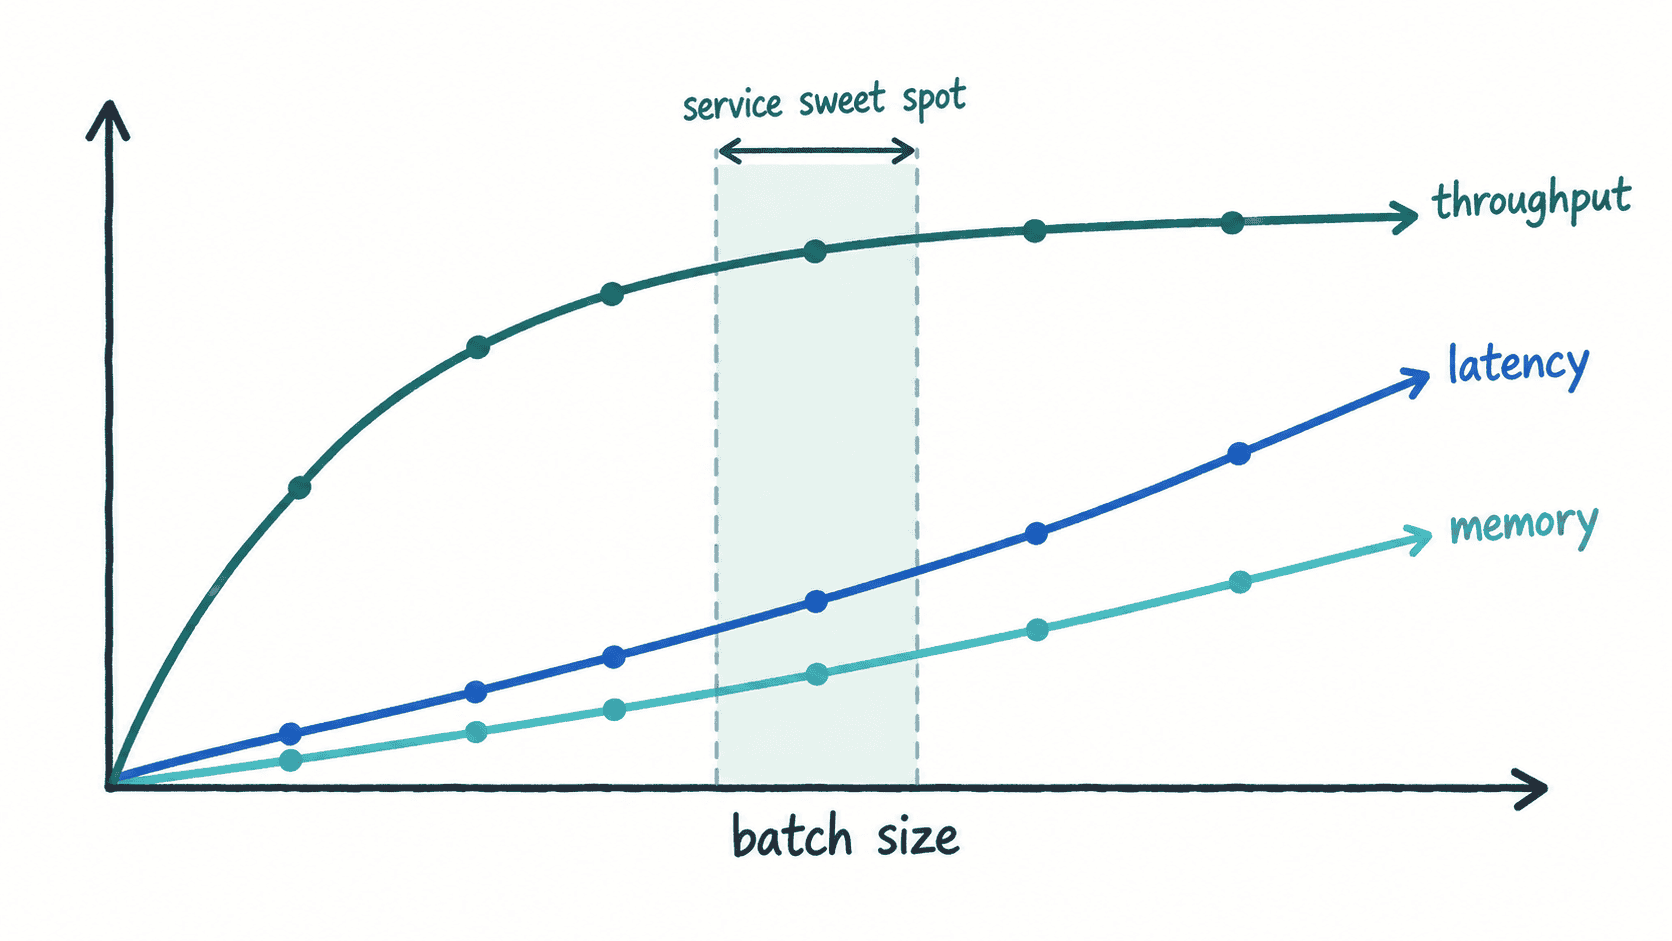
用同一模型测试多个 batch size
基准测试时必须固定模型、输入尺寸、精度和设备,并先做预热,避免把首次内核初始化计入结果。GPU 计时前后还需要同步,否则 CPU 端计时器可能在 GPU 真正完成计算前就结束。
import time
import torch
from torch import nn

device = torch.device("cuda" if torch.cuda.is_available() else "cpu")

model = nn.Sequential(
    nn.Conv2d(3, 32, kernel_size=3, padding=1),
    nn.ReLU(),
    nn.AdaptiveAvgPool2d((1, 1)),
    nn.Flatten(),
    nn.Linear(32, 100),
).to(device).eval()

def sync():
    if device.type == "cuda":
        torch.cuda.synchronize()

def benchmark(batch_size, steps=50):
    x = torch.randn(batch_size, 3, 224, 224, device=device)

    # 预热避免把首次内核初始化和缓存建立计入正式结果。
    with torch.inference_mode():
        for _ in range(10):
            model(x)
    sync()

    if device.type == "cuda":
        torch.cuda.reset_peak_memory_stats()

    start = time.perf_counter()
    with torch.inference_mode():
        for _ in range(steps):
            model(x)
    sync()
    elapsed = time.perf_counter() - start

    latency_ms = elapsed / steps * 1000
    throughput = batch_size * steps / elapsed
    peak_mb = (
        torch.cuda.max_memory_allocated() / 1024**2
        if device.type == "cuda"
        else None
    )
    return latency_ms, throughput, peak_mb

for batch_size in [1, 4, 8, 16, 32]:
    latency, throughput, peak = benchmark(batch_size)
    peak_text = f"{peak:.1f} MB" if peak is not None else "n/a"
    print(
        f"batch={batch_size:>2} "
        f"latency={latency:.2f} ms "
        f"throughput={throughput:.1f} img/s "
        f"peak_memory={peak_text}"
    )
预期输出
batch= 1 latency=<TIME> ms throughput=<THROUGHPUT> img/s peak_memory=<MEMORY>
batch= 4 latency=<TIME> ms throughput=<THROUGHPUT> img/s peak_memory=<MEMORY>
batch= 8 latency=<TIME> ms throughput=<THROUGHPUT> img/s peak_memory=<MEMORY>
batch=16 latency=<TIME> ms throughput=<THROUGHPUT> img/s peak_memory=<MEMORY>
batch=32 latency=<TIME> ms throughput=<THROUGHPUT> img/s peak_memory=<MEMORY>
具体数值由 CPU/GPU、驱动、精度和模型决定;CPU 环境下 peak_memory 会显示 n/a。观察重点是趋势:吞吐通常先随 batch 增大而提升,随后收益变小;与此同时单批延迟和显存占用会增加。
选择服务场景中的批量大小
离线任务通常可以优先追求吞吐,只要显存允许,就把 batch 提高到吞吐接近平台区。在线接口则应先确定延迟预算,再从满足预算的 batch 中选吞吐最高的一档。若服务还使用动态批处理,还要把请求等待时间加入端到端延迟,而不能只看模型前向时间。
一个实用决策顺序是先剔除会触发显存不足的 batch,再剔除单批计算时间已经超过延迟预算的 batch,最后比较剩余候选的吞吐。若 batch 从 16 增到 32 只带来很小的吞吐提升,却明显增加延迟与显存,就应保留 16 而不是盲目追求更大值。
服务验收要看端到端指标
模型基准只覆盖前向计算。上线前还应把图像解码、预处理、排队、批次拼接、推理和后处理都纳入延迟统计,并同时观察 P50、P95 或 P99,而不是只记录平均值。
最终选择的 batch size 应满足三个条件:吞吐足够、尾延迟不越线、峰值显存留有安全余量。批处理的目标不是把 batch 调到最大,而是在真实请求模式下找到吞吐与延迟的稳定平衡点。