
机器学习与深度学习 / 系统课时
把图片转换成批量张量
把图片转换成批量张量
卷积网络接收的不是 PIL 图片或 uint8 像素数组,而是带批次维度的浮点张量。本节用一个可运行的小例子完成像素缩放、通道换位、批次扩展和归一化,并把每一步的形状与数值都打印出来。
学习目标
- 解释图像从
HWC像素数组转换为CHW浮点张量时发生的变化 - 正确读懂批量输入的
BCHW四个维度 - 判断归一化是否放在正确位置,并验证转换后的数值范围
从像素数组到模型输入
常见图像库把 RGB 图片表示为高度、宽度、通道,即 HWC;PyTorch 卷积层通常接收 BCHW。转换过程不仅要移动通道维,还要把 0~255 的整数像素变成浮点数,并在最前面补上批次维度。
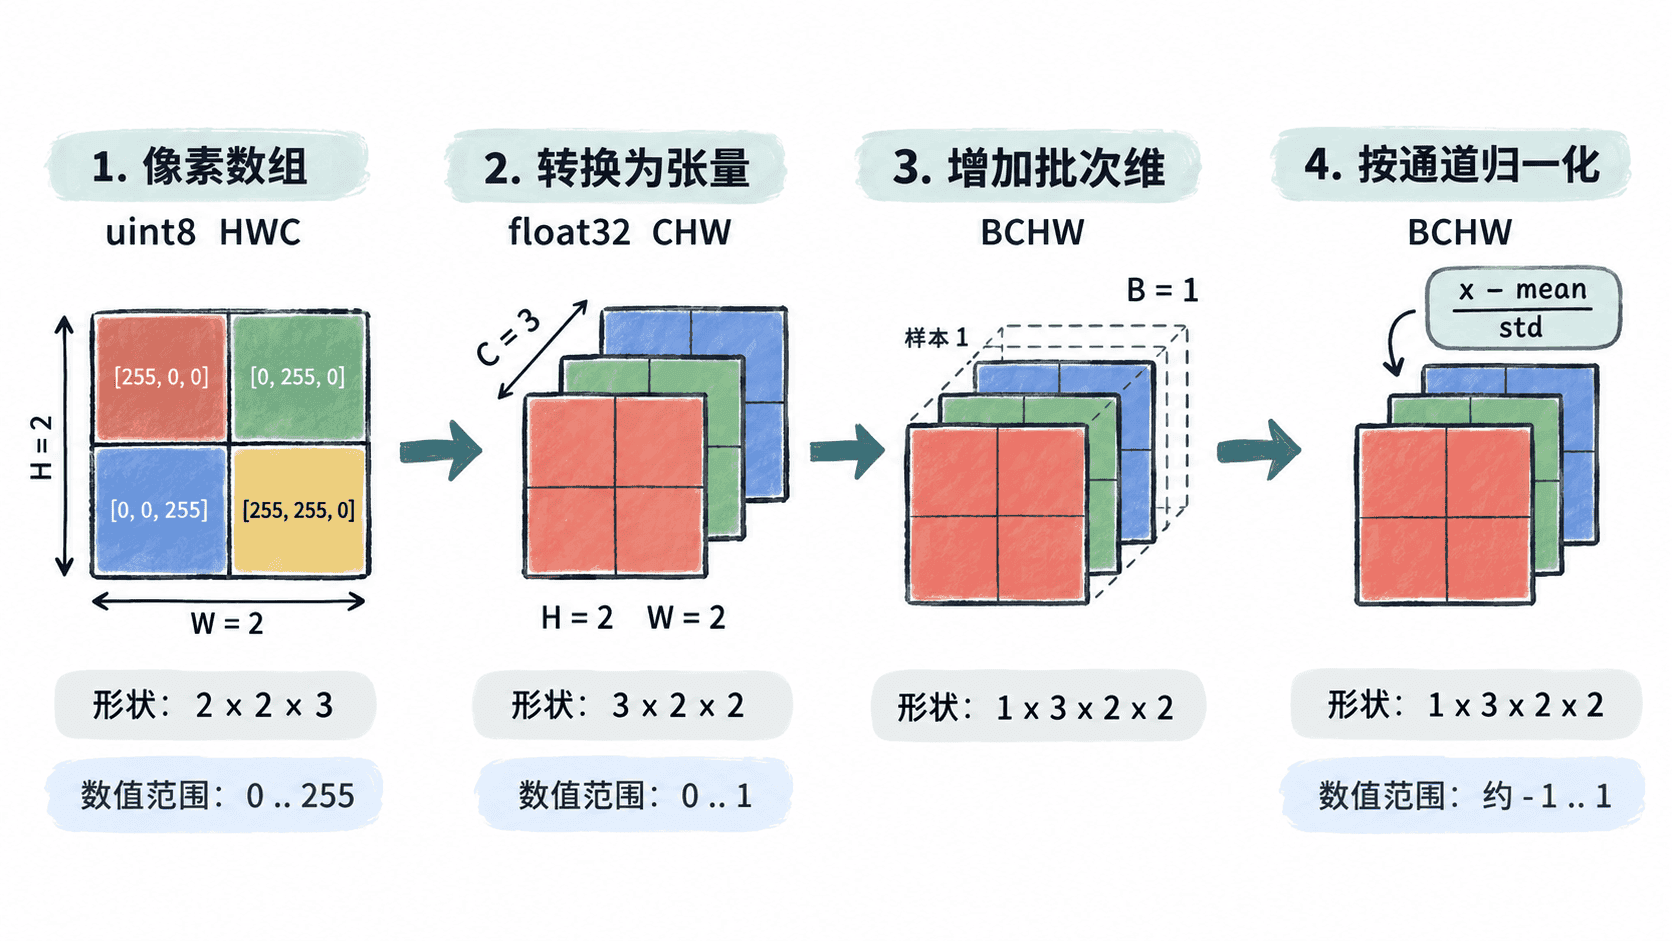
B 表示一次送入模型的图片数量,C 是通道数,H 和 W 是空间尺寸。单张 RGB 图片通常是 3×H×W;只有组成批次后,模型输入才是 B×3×H×W。
运行一次完整转换
下面构造一张 2×2 的 RGB 图片。示例故意使用可检查的像素值,这样可以同时验证形状、缩放与归一化,而不依赖外部图片文件。
import numpy as np
import torch
from PIL import Image
from torchvision import transforms

pixels = np.array(
    [
        [[0, 64, 255], [255, 128, 0]],
        [[32, 200, 100], [64, 16, 240]],
    ],
    dtype=np.uint8,
)

image = Image.fromarray(pixels, mode="RGB")

# ToTensor 会把 HWC uint8 转成 CHW float32,并把 0..255 缩放到 0..1。
tensor = transforms.ToTensor()(image)

# 单张图片没有批次轴;在最前面补 B=1,得到卷积网络常用输入形状。
batch = tensor.unsqueeze(0)

# 先缩放再归一化;这里取 mean=std=0.5,便于直接检查数值变化。
normalize = transforms.Normalize(
    mean=[0.5, 0.5, 0.5],
    std=[0.5, 0.5, 0.5],
)
normalized_batch = normalize(tensor).unsqueeze(0)

print("image.size =", image.size)
print("tensor.shape =", tensor.shape, tensor.dtype)
print("batch.shape =", batch.shape)
print("pixel(0,0) =", [round(v, 3) for v in tensor[:, 0, 0].tolist()])
print(
    "normalized(0,0) =",
    [round(v, 3) for v in normalized_batch[0, :, 0, 0].tolist()],
)
预期输出
image.size = (2, 2)
tensor.shape = torch.Size([3, 2, 2]) torch.float32
batch.shape = torch.Size([1, 3, 2, 2])
pixel(0,0) = [0.0, 0.251, 1.0]
normalized(0,0) = [-1.0, -0.498, 1.0]
第一组像素原本是 [0, 64, 255]。ToTensor() 分别除以 255,因此得到约 [0, 0.251, 1]。当均值和标准差都取 0.5 时,归一化公式是 ,所以它们进一步映射到约 [-1, -0.498, 1]。
归一化影响的是尺度而不是形状
归一化不会改变 BCHW 的维度,只会按通道调整数值分布。训练集和验证集必须使用同一套归一化参数,否则模型在验证时看到的输入尺度与训练阶段不同,指标就失去可比性。
需要特别区分“缩放”和“归一化”:ToTensor() 已把 uint8 的 0~255 缩放到 0~1;Normalize() 再根据给定均值和标准差做线性变换。若把仍处于 0~255 的数据直接套用面向 0~1 的参数,输入尺度会明显错误。
检查维度时抓住三个错误
最常见的问题是把 HWC 直接送入模型、忘记单张图片的批次维,或训练和验证使用不同的通道顺序。遇到形状报错时,先打印 dtype、shape 和一个像素位置的通道值,比盲目改 permute() 更可靠。
进入卷积网络前,只要确认输入是浮点类型、形状为 B×C×H×W,并且数值经过与训练方案一致的缩放和归一化,图片就已经完成了从“可显示数据”到“可训练张量”的转换。