
机器学习与深度学习 / 系统课时
用 1×1 卷积调整通道维度
用 1×1 卷积调整通道维度
1×1 卷积看似没有空间感受野,却是现代 CNN 中非常重要的通道变换工具。它能在不改变特征图高宽的情况下压缩、扩展或重新组合通道,并可用于残差投影和瓶颈结构以显著减少昂贵卷积的计算量。
学习目标
- 解释
1×1卷积如何在每个空间位置进行通道映射 - 使用
1×1卷积完成通道降维与升维 - 分析残差投影和瓶颈结构中使用
1×1卷积的原因
只改变通道而不观察邻域
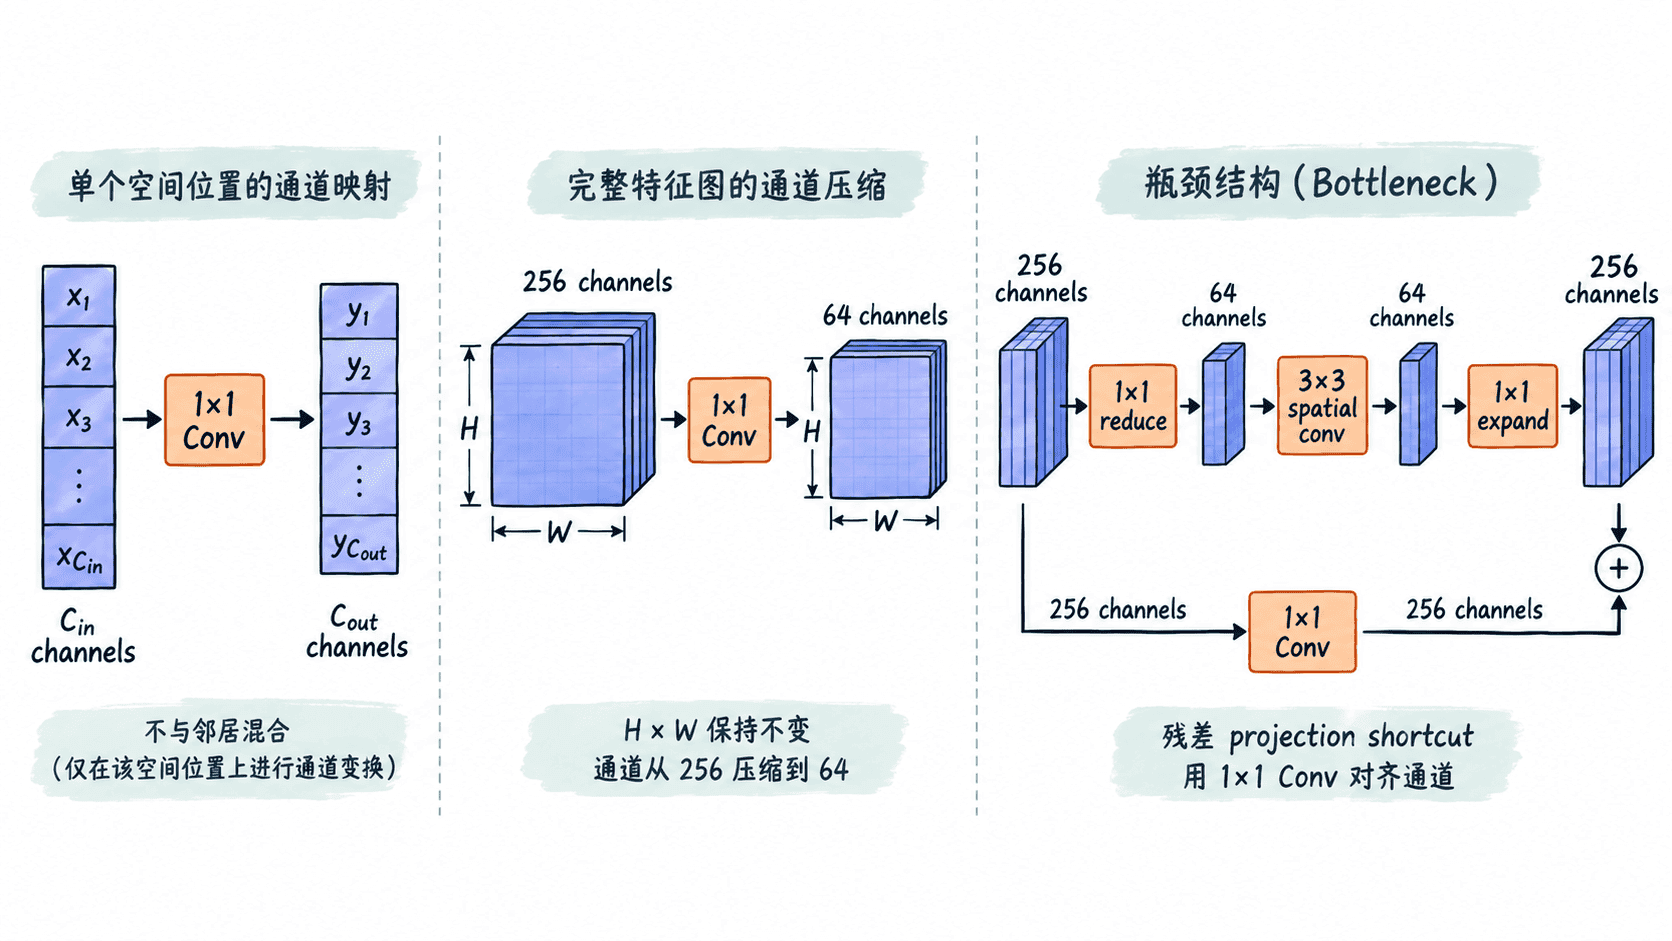
设输入形状为 N×Cin×H×W。普通 3×3 卷积会同时读取一个位置周围的空间邻域和全部输入通道,而 1×1 卷积在每个空间位置只读取该位置的全部通道,再把长度为 Cin 的向量映射成长度为 Cout 的新向量。
因此,只要 stride=1 且不额外改变尺寸,输入的 H×W 会保持不变,通道数则可以从 Cin 任意变为 Cout。同一组权重会共享到所有空间位置,所以它仍然符合卷积层的权重共享规则,而不是给每个像素准备独立的全连接层。
降维可以把昂贵计算放到窄通道上
卷积参数量与输入、输出通道数直接相关。忽略 bias 时,一个 1×1 卷积只有 个参数,而 3×3 卷积需要 个参数。如果先把 256 个通道压缩到 64 个,再执行 3×3 卷积,最昂贵的空间卷积就只需处理较窄的表示。
之后再用另一个 1×1 卷积把 64 个通道升回 256,就形成典型的“降维—空间卷积—升维”瓶颈。降维不是简单删除固定通道,而是通过可学习权重重新组合所有输入通道,因此网络可以训练出更合适的紧凑表示。
用代码比较瓶颈的参数量
下面把一个直接的 256→256、3×3 卷积,与 256→64→64→256 的瓶颈结构进行比较。所有卷积都关闭 bias,使参数数量只反映卷积核权重。
import torch
from torch import nn


x = torch.randn(2, 256, 28, 28)

# 先压缩通道,让成本最高的 3×3 卷积在较窄的张量上运行。
reduce = nn.Conv2d(256, 64, kernel_size=1, bias=False)
spatial = nn.Conv2d(64, 64, kernel_size=3, padding=1, bias=False)
expand = nn.Conv2d(64, 256, kernel_size=1, bias=False)

direct = nn.Conv2d(256, 256, kernel_size=3, padding=1, bias=False)

z = reduce(x)
y = expand(spatial(z))


def parameter_count(*modules):
    return sum(p.numel() for module in modules for p in module.parameters())


direct_params = parameter_count(direct)
bottleneck_params = parameter_count(reduce, spatial, expand)

print(f'input={tuple(x.shape)}')
print(f'after_reduce={tuple(z.shape)}')
print(f'output={tuple(y.shape)}')
print(f'direct_3x3_params={direct_params}')
print(f'bottleneck_params={bottleneck_params}')
print(f'bottleneck_is_smaller={bottleneck_params < direct_params}')
预期输出
input=(2, 256, 28, 28)
after_reduce=(2, 64, 28, 28)
output=(2, 256, 28, 28)
direct_3x3_params=589824
bottleneck_params=69632
bottleneck_is_smaller=True
这里瓶颈的三个卷积合计只有 69632 个权重,而单个直接 3×3 卷积需要 589824 个。实际网络还会加入归一化、激活以及其他层,但先降通道再执行空间卷积仍是降低计算成本的核心原因。
残差投影与瓶颈承担不同职责
在残差网络中,1×1 卷积常同时出现在两个位置,但用途不同。主分支中的 1×1 卷积负责压缩或恢复通道,让中间的 3×3 卷积更便宜;shortcut 上的 1×1 投影则用于把输入调整到与主分支输出相同的形状,使两者可以逐元素相加。
如果输入和输出通道已经相等、空间尺寸也没有变化,shortcut 通常无需额外的 1×1 卷积。只有发生通道变化或下采样时才进行投影,可以避免把无参数的恒等路径无条件替换成额外计算。
不能用 1×1 卷积替代所有空间卷积
1×1 卷积只混合同一空间位置的通道,无法直接读取左、右、上、下的邻域信息。因此它擅长通道重组,却不能单独承担边缘、纹理和局部形状等空间模式的提取。瓶颈结构仍保留 3×3 卷积,正是为了继续完成空间特征建模。
通道压缩也不是越激进越好。若中间通道过少,模型可能丢失完成任务所需的表示容量。实践中应把 1×1 卷积看成可学习的通道映射器:在昂贵空间卷积前后控制宽度,在残差分支需要时对齐形状,而不是把它当作所有卷积层的低成本替代品。