
机器学习与深度学习 / 系统课时
按精度与成本选择网络骨干
按精度与成本选择网络骨干
选择图像分类骨干时,模型更深并不自动意味着更适合部署。本节把准确率、参数量、计算量、输入分辨率、真实延迟和设备能力放进同一张选择表,再用硬约束过滤与 Pareto 比较得到可解释的候选结果。
学习目标
- 用统一口径记录不同骨干的精度与资源成本
- 区分参数量、MACs、激活内存和真实延迟各自代表的约束
- 先过滤不可部署方案,再在剩余候选中做精度与成本权衡
先把部署约束写成门槛
模型选择应从设备和业务约束开始,而不是先挑一个熟悉的网络再想办法塞进去。常见硬约束包括最低验证集准确率、最大 p95 延迟、峰值内存上限、模型包大小,以及目标推理引擎是否支持关键算子和量化方式。
输入分辨率也必须绑定到候选方案。对同一骨干,卷积计算通常近似随输入面积增长,例如从 提到 ,仅面积比例就约为 ,因此不能只记录模型名称而忽略输入尺寸。
建立同口径的选择表
所有候选必须使用同一数据集划分、预处理、精度指标和推理设置。参数量反映权重规模,MACs 反映理论计算量,峰值内存还受到中间激活影响,而真实延迟必须在目标硬件上测量。
| 候选 | 输入 | 参数量 | Top-1 | MACs | p95 延迟 | 峰值内存 | 结果 |
|---|---|---|---|---|---|---|---|
| Backbone-A | 224 | 5.2M | 76.2% | 220M | 7.8 ms | 95 MB | 可候选 |
| Backbone-B | 224 | 8.1M | 77.4% | 310M | 11.3 ms | 118 MB | 延迟超限 |
| Backbone-C | 192 | 3.4M | 75.8% | 150M | 5.9 ms | 74 MB | 精度不足 |
| Backbone-D | 224 | 6.7M | 76.8% | 280M | 9.5 ms | 125 MB | 可候选 |
表中的数值只是演示选择方法的 profile 数据,不代表任何固定模型的官方指标。真正比较时应替换为自己的训练结果和目标设备基准。
先过滤硬约束,再比较 Pareto 候选
推荐的决策顺序是先剔除违反硬约束的方案,再比较剩余候选。若一个模型同时比另一个更准、延迟更低且内存更少,那么后者被支配;若候选各有优势,就保留在 Pareto 前沿,根据业务优先级继续选择。
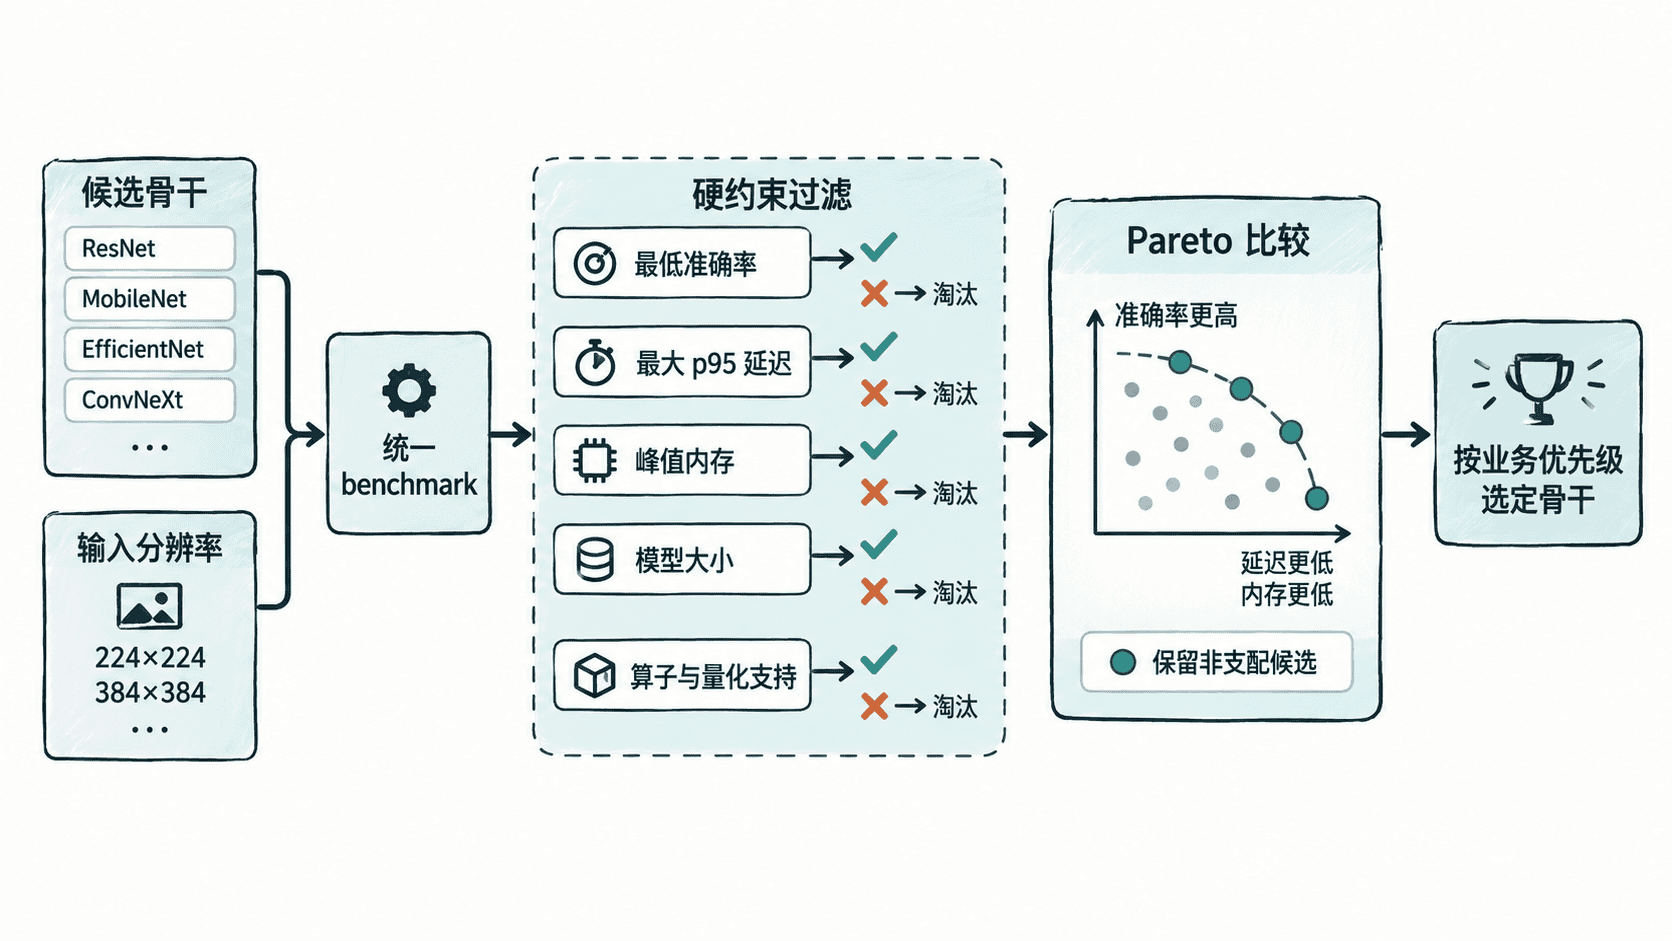
下面用一段可运行脚本复现表中的硬约束过滤。约束设为 Top-1 至少 76.0%、p95 延迟不超过 10 ms、峰值内存不超过 128 MB。
candidates = [
    {"name": "Backbone-A", "params_m": 5.2, "top1": 76.2, "latency_ms": 7.8, "memory_mb": 95, "macs_m": 220},
    {"name": "Backbone-B", "params_m": 8.1, "top1": 77.4, "latency_ms": 11.3, "memory_mb": 118, "macs_m": 310},
    {"name": "Backbone-C", "params_m": 3.4, "top1": 75.8, "latency_ms": 5.9, "memory_mb": 74, "macs_m": 150},
    {"name": "Backbone-D", "params_m": 6.7, "top1": 76.8, "latency_ms": 9.5, "memory_mb": 125, "macs_m": 280},
]
limits = {"min_top1": 76.0, "max_latency_ms": 10.0, "max_memory_mb": 128}

eligible = [
    m for m in candidates
    if m["top1"] >= limits["min_top1"]
    and m["latency_ms"] <= limits["max_latency_ms"]
    and m["memory_mb"] <= limits["max_memory_mb"]
]

for m in sorted(eligible, key=lambda x: (-x["top1"], x["latency_ms"])):
    print(
        f'{m["name"]}: top1={m["top1"]:.1f}%, '
        f'params={m["params_m"]:.1f}M, latency={m["latency_ms"]:.1f}ms, '
        f'memory={m["memory_mb"]}MB, MACs={m["macs_m"]}M'
    )
预期输出
Backbone-D: top1=76.8%, params=6.7M, latency=9.5ms, memory=125MB, MACs=280M
Backbone-A: top1=76.2%, params=5.2M, latency=7.8ms, memory=95MB, MACs=220M
过滤后只剩 A 与 D。D 的准确率更高,A 的延迟、内存和 MACs 更低,因此两者都不能被简单删除;如果业务把延迟上限进一步收紧到 8 ms,A 才会成为唯一满足条件的方案。
避免用一个数字替代真实成本
不要把参数量等同于内存,也不要把 MACs 等同于延迟。参数少的模型仍可能产生很大的中间激活,MACs 较低的模型也可能因为算子碎片化、内存访问或设备缺少优化而更慢。
最终选择应以目标设备上的实测结果为准,并把输入分辨率、batch size、数值精度、推理引擎版本和线程设置一起记录。这样得到的骨干选择不是“哪个模型更先进”,而是“哪个候选在当前精度门槛下,以可接受成本满足部署目标”。