
机器学习与深度学习 / 系统课时
排查数据泄漏与分布偏移
排查数据泄漏与分布偏移
当验证集分数异常高、但线上准确率明显下降时,先不要急着改网络结构。更常见的原因是数据边界被破坏,或训练、验证、线上样本来自不同分布。本节用一套可复现的审计顺序检查重复样本、预处理差异与来源偏置,并给出修复后的验收方法。
学习目标
- 区分数据泄漏与分布偏移造成的典型现象
- 用内容哈希、预处理契约和来源统计定位问题
- 在重新划分数据后验证修复是否真正生效
先区分泄漏与偏移
数据泄漏意味着验证阶段看到了本不该知道的信息。图像任务中最常见的是同一原图、裁剪图或同一主体的近重复样本同时进入训练集和验证集。此时验证分数会虚高,因为模型记住了内容或拍摄条件,而不是学到了可迁移的判别规则。
分布偏移则是训练时学到的输入规律与线上输入不再一致。例如训练集主要来自棚拍,线上却来自手机;训练按 RGB、线上误用 BGR;训练先缩放再归一化,服务端却用了不同尺寸或均值。它通常表现为离线指标正常、上线后某些来源或时间段突然恶化。
按证据顺序定位
排查时先检查划分边界,再检查预处理,最后比较来源分布。这样可以避免把“重复样本造成的虚高”误判成模型能力,也避免只看整体准确率而漏掉某个来源的系统性失败。
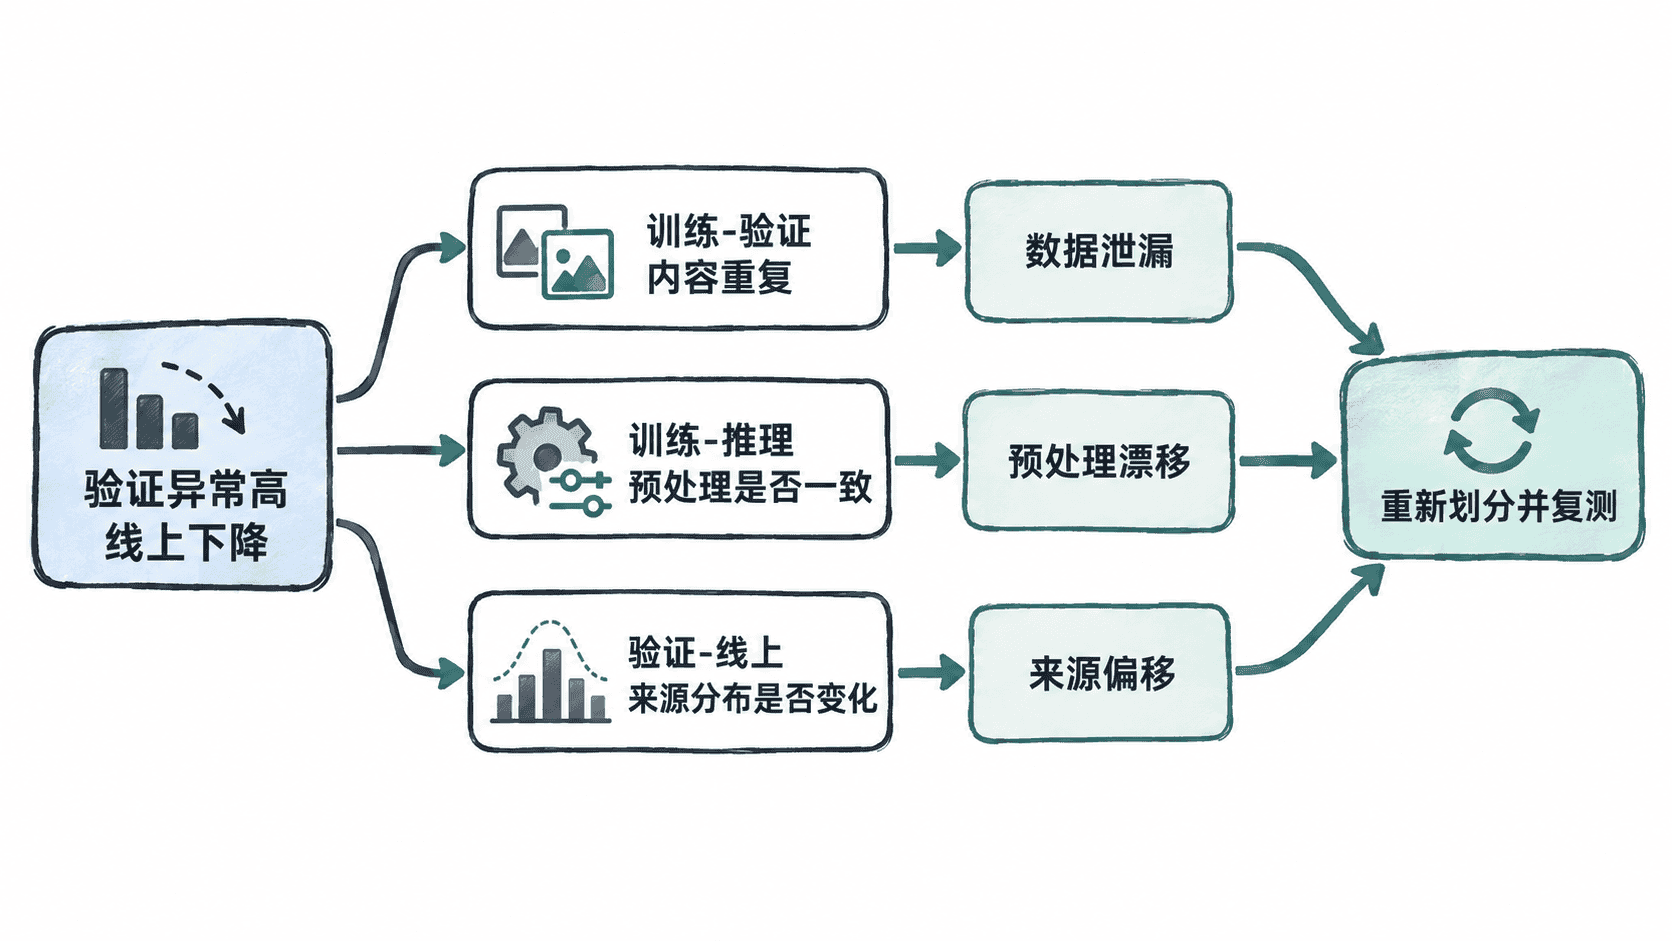
实际项目中还应按用户、设备、视频片段、病例或商品等业务实体做分组检查。即使文件本身不同,只要来自同一实体的高度相似图像跨越了训练与验证边界,也可能形成泄漏。
用最小审计脚本检查
下面的可运行示例同时检查三件事:训练与验证是否存在内容级重复、训练与推理的预处理规格是否一致、验证与线上数据的来源分布是否明显变化。示例用字节内容模拟图像文件,接入真实数据时可把 content 替换为 Path.read_bytes() 的结果。
import hashlib
from collections import Counter

def digest(content: bytes) -> str:
    return hashlib.sha256(content).hexdigest()

def source_ratio(rows):
    counts = Counter(row['source'] for row in rows)
    total = len(rows)
    return {key: counts[key] / total for key in sorted(counts)}

def tv_distance(left, right):
    keys = set(left) | set(right)
    return 0.5 * sum(abs(left.get(k, 0.0) - right.get(k, 0.0)) for k in keys)

train = [
    {'path': 'train/cat-a.jpg', 'content': b'cat-a', 'source': 'studio'},
    {'path': 'train/dog-a.jpg', 'content': b'dog-a', 'source': 'studio'},
]
valid = [
    {'path': 'valid/cat-copy.jpg', 'content': b'cat-a', 'source': 'studio'},
    {'path': 'valid/dog-b.jpg', 'content': b'dog-b', 'source': 'mobile'},
]
online = [
    {'path': 'online/cat-c.jpg', 'content': b'cat-c', 'source': 'mobile'},
    {'path': 'online/dog-c.jpg', 'content': b'dog-c', 'source': 'mobile'},
]

train_by_hash = {digest(row['content']): row['path'] for row in train}
duplicates = []
for row in valid:
    key = digest(row['content'])
    if key in train_by_hash:
        duplicates.append((train_by_hash[key], row['path']))

train_preprocess = {'resize': 224, 'color': 'RGB', 'range': '0..1', 'mean': (0.485, 0.456, 0.406)}
serve_preprocess = {'resize': 256, 'color': 'RGB', 'range': '0..1', 'mean': (0.485, 0.456, 0.406)}
mismatched = [k for k in train_preprocess if train_preprocess[k] != serve_preprocess[k]]

valid_ratio = source_ratio(valid)
online_ratio = source_ratio(online)

print('duplicate_count:', len(duplicates))
print('duplicate_pair:', duplicates[0])
print('preprocess_equal:', not mismatched)
print('mismatched_keys:', mismatched)
print('source_tv_distance:', f'{tv_distance(valid_ratio, online_ratio):.2f}')
预期输出
duplicate_count: 1
duplicate_pair: ('train/cat-a.jpg', 'valid/cat-copy.jpg')
preprocess_equal: False
mismatched_keys: ['resize']
source_tv_distance: 0.50
duplicate_count 大于 0 已经足以说明当前验证集不可信;preprocess_equal 为 False 表示服务端输入语义与训练端不一致。总变差距离这里只作为分布变化的报警量,0.50 说明示例中的来源占比发生了明显变化,但真实项目应结合样本量、类别和业务阈值解释,而不是机械套固定阈值。
修复后重新建立可信基线
发现重复后,应先在划分之前去重,并优先按业务实体分组切分,而不是先随机切分再删重复。若数据按时间产生,线上场景更接近未来数据,还应保留时间顺序做验证,避免未来信息提前进入训练集。
预处理差异要通过一份可版本化的“输入契约”消除:尺寸、裁剪方式、颜色顺序、数值范围、插值方式、均值和标准差都应由训练与服务端共享。仅仅参数名字相同还不够,执行顺序也必须一致。
来源偏移则应把整体指标拆成来源、设备、地区或时间窗口的分组指标。若某一来源持续恶化,应补充该来源的训练样本、调整采样权重,或单独处理采集链路,而不是只依赖全局平均准确率。
修复完成后,至少重新确认三件事:训练与验证不存在跨边界重复;训练与推理预处理契约逐项一致;线上关键来源的分组指标回到可接受范围。只有这三个条件同时成立,新的验证分数才值得用于模型选型。