
机器学习与深度学习 / 系统课时
完成端到端图像分类项目
完成端到端图像分类项目
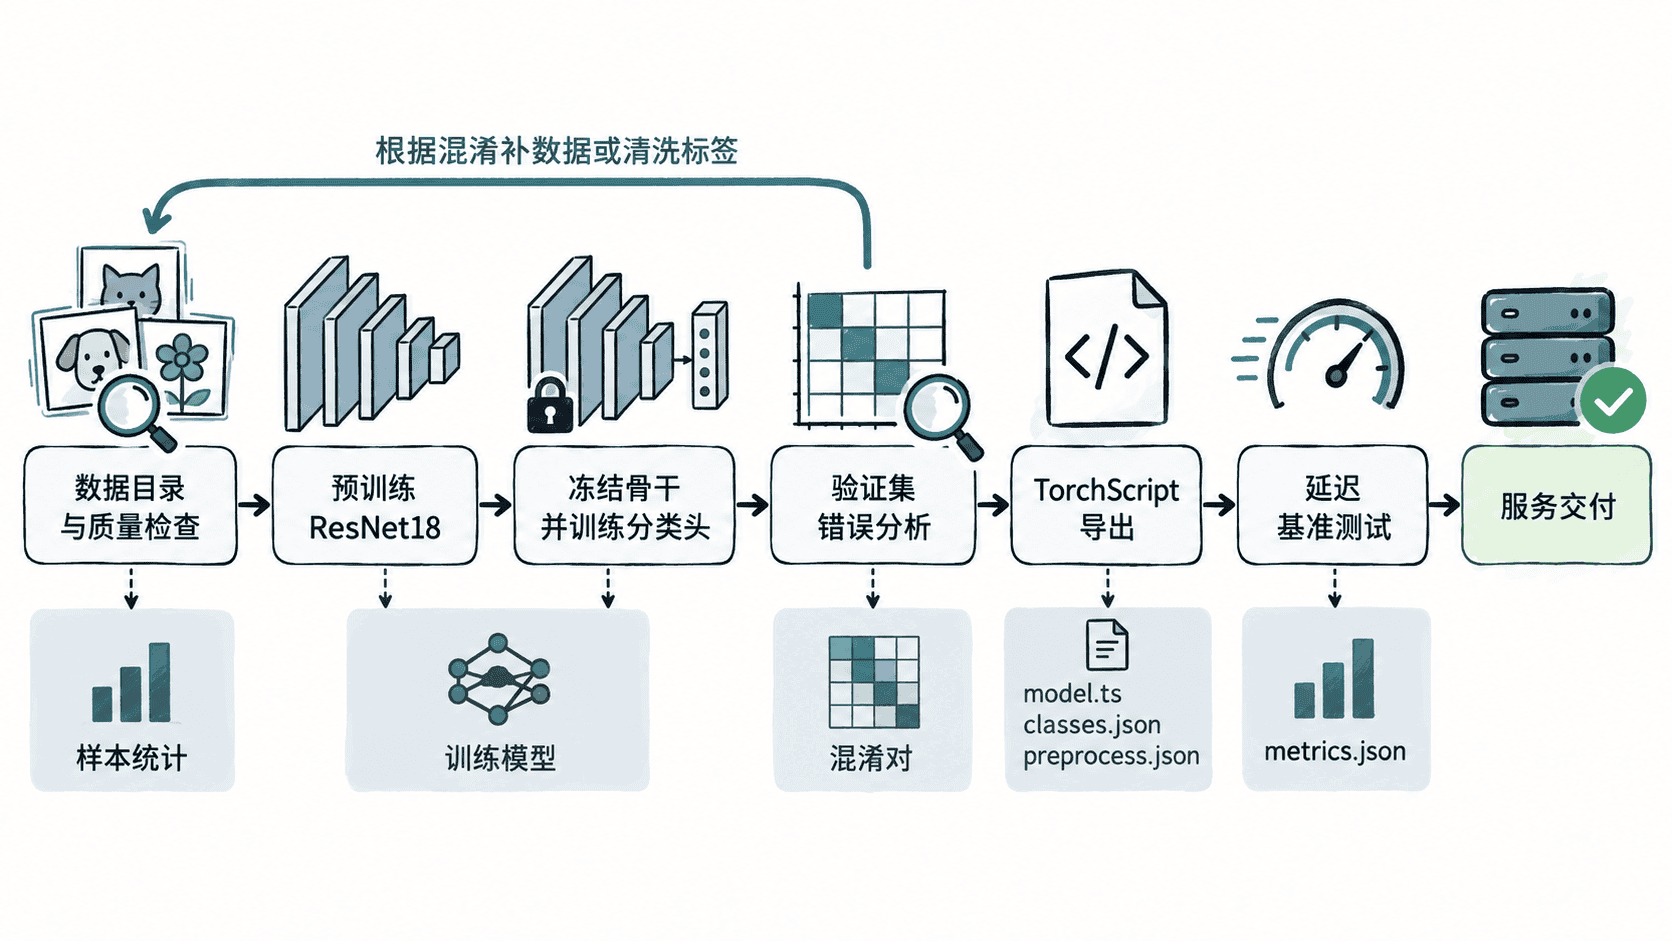
这一节把 CNN 项目从“能训练”推进到“可交付”。以五类可回收物图像分类为例,完成数据契约检查、迁移训练、错误分析、模型导出和延迟验证,并把预处理与类别映射一起固化为部署资产。
学习目标
- 能组织一个可复现的多类别图像分类数据集并完成基础质量检查。
- 能基于预训练 ResNet18 完成迁移训练,并用验证集错误分析发现主要混淆。
- 能导出模型、预处理规范、类别映射和验证指标,形成可部署交付物。
先定义项目交付物
示例任务把图片分成 cardboard、glass、metal、paper、plastic 五类。数据使用 ImageFolder 约定:训练集放在 dataset/train/<class>,验证集放在 dataset/val/<class>,两个分区的类别目录必须完全一致。
最终交付不只是一份权重。至少应包含可加载模型、类别顺序、预处理参数和验证指标,因为线上服务只有同时复现这四部分,离线准确率才有意义。这里输出 model.ts、classes.json、preprocess.json 与 metrics.json 四个文件。
完成迁移训练与错误分析
网络先选 ResNet18 作为迁移学习基线:它的预训练权重与标准预处理都由 TorchVision 提供,模型规模适中,便于先建立可复现的准确率和延迟基线。若后续准确率不足,再解冻高层继续微调;若延迟超标,再考虑更轻量的骨干,而不是一开始就同时更换数据、网络和部署方案。
下面的主脚本要求本机已经安装 PyTorch、TorchVision 与 Pillow,并准备好上述目录。第一次使用 ResNet18_Weights.DEFAULT 时,如果权重未缓存,TorchVision 会下载官方预训练权重。脚本固定随机种子、检查训练与验证类别、只训练新的分类头,并统计验证集中最常见的错误类别对。
import json
import time
from collections import Counter
from pathlib import Path

import torch
from torch import nn
from torch.utils.data import DataLoader
from torchvision.datasets import ImageFolder
from torchvision.models import ResNet18_Weights, resnet18

torch.manual_seed(7)

root = Path('dataset')
out_dir = Path('artifacts')
out_dir.mkdir(exist_ok=True)

weights = ResNet18_Weights.DEFAULT
transform = weights.transforms()
train_ds = ImageFolder(root / 'train', transform=transform)
val_ds = ImageFolder(root / 'val', transform=transform)

if train_ds.classes != val_ds.classes:
    raise ValueError('train/val 类别目录不一致')
if len(train_ds.classes) < 2 or len(train_ds) == 0 or len(val_ds) == 0:
    raise ValueError('数据集必须包含至少两个类别,且 train/val 均非空')

train_loader = DataLoader(train_ds, batch_size=32, shuffle=True, num_workers=0)
val_loader = DataLoader(val_ds, batch_size=32, shuffle=False, num_workers=0)
device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')

model = resnet18(weights=weights)
for parameter in model.parameters():
    parameter.requires_grad = False
model.fc = nn.Linear(model.fc.in_features, len(train_ds.classes))
model.to(device)

optimizer = torch.optim.AdamW(model.fc.parameters(), lr=1e-3)
loss_fn = nn.CrossEntropyLoss()

for epoch in range(2):
    # 冻结骨干后保持 BatchNorm 为评估模式,只训练新的分类头。
    model.eval()
    model.fc.train()
    running_loss = 0.0
    seen = 0

    for images, targets in train_loader:
        images, targets = images.to(device), targets.to(device)
        optimizer.zero_grad()
        logits = model(images)
        loss = loss_fn(logits, targets)
        loss.backward()
        optimizer.step()
        running_loss += loss.item() * images.size(0)
        seen += images.size(0)

    print(f'epoch={epoch + 1} train_loss={running_loss / seen:.4f}')

model.eval()
correct = 0
total = 0
confusions = Counter()

with torch.inference_mode():
    for images, targets in val_loader:
        logits = model(images.to(device))
        preds = logits.argmax(dim=1).cpu()

        correct += int((preds == targets).sum().item())
        total += targets.numel()
        for truth, pred in zip(targets.tolist(), preds.tolist()):
            if truth != pred:
                confusions[(truth, pred)] += 1

accuracy = correct / total
top_confusion = confusions.most_common(1)
if top_confusion:
    (truth, pred), count = top_confusion[0]
    confusion_text = f'{train_ds.classes[truth]}->{train_ds.classes[pred]}:{count}'
else:
    confusion_text = 'none'

# 固化类别顺序与预处理规范,避免部署端自行猜测。
(out_dir / 'classes.json').write_text(
    json.dumps(train_ds.classes, ensure_ascii=False, indent=2),
    encoding='utf-8',
)
preprocess_spec = {
    'resize_size': transform.resize_size,
    'crop_size': transform.crop_size,
    'mean': transform.mean,
    'std': transform.std,
    'interpolation': str(transform.interpolation),
}
(out_dir / 'preprocess.json').write_text(
    json.dumps(preprocess_spec, ensure_ascii=False, indent=2),
    encoding='utf-8',
)

model = model.to('cpu')
example = torch.randn(1, 3, 224, 224)
traced = torch.jit.trace(model, example)
traced.save(str(out_dir / 'model.ts'))

# 在同一 CPU 环境做固定次数基准,记录单张推理平均延迟。
with torch.inference_mode():
    for _ in range(5):
        traced(example)
    start = time.perf_counter()
    for _ in range(20):
        traced(example)
    latency_ms = (time.perf_counter() - start) * 1000 / 20

metrics = {
    'val_accuracy': accuracy,
    'top_confusion': confusion_text,
    'latency_ms': latency_ms,
}
(out_dir / 'metrics.json').write_text(
    json.dumps(metrics, ensure_ascii=False, indent=2),
    encoding='utf-8',
)

print(f'classes={len(train_ds.classes)} train={len(train_ds)} val={len(val_ds)}')
print(f'val_accuracy={accuracy:.4f}')
print(f'top_confusion={confusion_text}')
print('exported=artifacts/model.ts,artifacts/classes.json,artifacts/preprocess.json,artifacts/metrics.json')
print(f'latency_ms={latency_ms:.3f}')
预期输出
epoch=1 train_loss=<LOSS>
epoch=2 train_loss=<LOSS>
classes=5 train=<COUNT> val=<COUNT>
val_accuracy=<ACC>
top_confusion=<CLASS_A>-><CLASS_B>:<COUNT>
exported=artifacts/model.ts,artifacts/classes.json,artifacts/preprocess.json,artifacts/metrics.json
latency_ms=<TIME><LOSS>、<COUNT>、<ACC>、<CLASS_A>、<CLASS_B> 和 <TIME> 会随数据集、硬件和训练结果变化;若验证集没有任何错误,top_confusion 会输出 none。真正需要验收的是产物是否完整、指标是否来自固定验证集,以及同一预处理规范能否在部署端复现。
用错误分析决定下一步
单看总体准确率会掩盖类别级问题。top_confusion 给出验证集里出现次数最多的错误方向,例如 glass->plastic。遇到明显混淆时,先人工检查这两个类别的错例:如果标签错误就清洗数据;如果拍摄背景或尺寸差异明显就补充样本;如果视觉本身接近,再考虑解冻后几层做低学习率微调。
数据不平衡也应在训练前处理。若某一类样本远少于其他类别,优先补数据或在损失与采样策略中显式处理,而不是只增加训练轮数。验证集必须与训练集隔离,且类别目录顺序由 classes.json 固化,避免上线后索引错位。
导出与性能验收
model.ts 只负责“张量到 logits”,因此部署端还必须读取 preprocess.json 按相同的 Resize、Crop、Normalize 处理输入,并按 classes.json 解释输出索引。这样模型文件、预处理与类别语义组成一个不可拆分的版本单元。
性能验收要在目标硬件或接近目标环境中重复执行,并区分单张延迟与吞吐量。示例中的 CPU 基准只用于建立可复现基线;如果服务使用 GPU、批量推理、FP16 或量化,应重新记录对应环境的数据,并同时确认精度没有超出可接受损失。
当数据检查有证据、迁移训练可复现、主要错误类别可解释、导出资产齐全且目标环境的精度与延迟都达到门槛时,这个项目才从“训练实验”变成了可以交给部署系统持续复现的 CNN 分类交付物。