
机器学习与深度学习 / 系统课时
选择分类损失并读懂 logits
选择分类损失并读懂 logits
分类器最后一层输出的不是概率,而是每个类别的原始得分 logits。本篇把 logits、softmax 与交叉熵串成一条完整链路,并用可运行示例验证正确写法,避免重复 softmax 导致损失含义和梯度都发生变化。
学习目标
- 正确解释 logits、类别概率与预测类别之间的关系
- 理解交叉熵为什么通常直接接收 logits
- 根据损失与准确率的变化判断模型是否真的在学习
从 logits 读分类结果
设一个批次有 张图、分类任务有 个类别,CNN 最后一层通常输出形状为 [N, C] 的 logits。每个值只是对应类别的相对得分,可以为负,也不要求总和为 1。
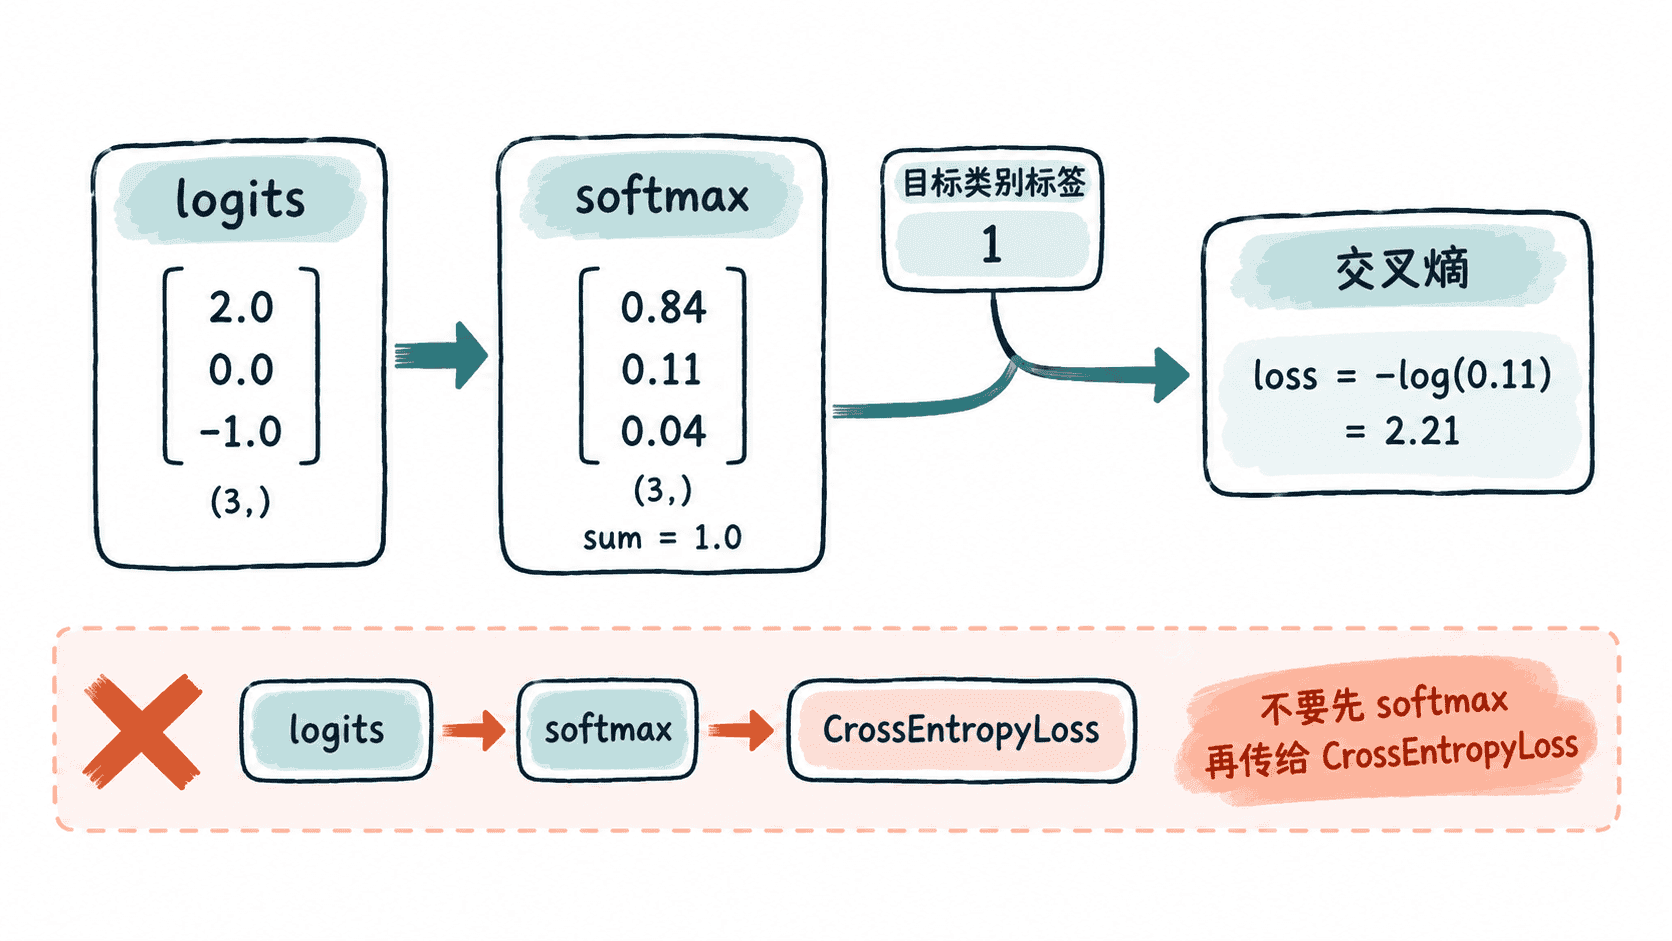
预测类别只取同一行最大 logits 的索引。softmax 则把这些相对得分转成 0 到 1 之间、每行总和为 1 的概率;它不会改变最大值所在的类别,因此推理时即使只需要类别编号,也可以直接对 logits 做 argmax。
交叉熵为什么直接接 logits
单个样本的直觉可以写成 :模型给真实类别的概率 越接近 1,损失越小;越接近 0,惩罚越大。实际训练时,框架不会要求先手动算出概率再取对数,而会把 softmax 与对数计算合并成数值更稳定的实现。
在 PyTorch 中,F.cross_entropy(logits, targets) 期望输入原始 logits。若先执行 softmax,再把概率传给 cross_entropy,函数仍会把这些概率当作新的 logits 再做归一化,损失就不再是原本想优化的量。
import torch
import torch.nn.functional as F

logits = torch.tensor([
    [2.0, 0.0, -1.0],
    [0.2, 1.5, -0.3],
])
targets = torch.tensor([0, 1])

# 训练时直接把原始 logits 交给交叉熵。
loss = F.cross_entropy(logits, targets)
probabilities = torch.softmax(logits, dim=1)

# 这一步可以运行,但属于错误训练用法:概率被再次当成 logits。
wrong_loss = F.cross_entropy(probabilities, targets)

print("probabilities normalized:", torch.allclose(
    probabilities.sum(dim=1), torch.ones(2)
))
print("predicted classes:", probabilities.argmax(dim=1).tolist())
print("loss:", round(loss.item(), 4))
print("double softmax keeps same loss:", torch.allclose(loss, wrong_loss))
预期输出
probabilities normalized: True
predicted classes: [0, 1]
loss: 0.2665
double softmax keeps same loss: False
损失下降到底说明什么
交叉熵下降说明模型总体上正在提高真实类别相对于其他类别的得分,使训练样本的目标类别获得更高概率。但它不等于准确率一定同步提升:只要预测排序没有跨过类别边界,概率从 0.55 提高到 0.80 时准确率仍然不变,而损失会明显下降。
反过来,准确率偶尔提高也不代表训练稳定。如果少量样本变得极度自信但错误,交叉熵可能仍然升高。因此训练分类 CNN 时应同时观察训练损失、验证损失和准确率,而不是只盯一个数字。
当损失持续下降且验证指标同步改善,可以认为 logits 正在朝正确类别拉开间隔;若训练损失下降而验证损失反升,则应优先考虑过拟合,而不是继续通过重复归一化或修改损失输入来“修正”数值。