
机器学习与深度学习 / 系统课时
设置初始化避免梯度失稳
设置初始化避免梯度失稳
CNN 的卷积层如果从不合适的权重尺度开始,信号会在多层传播中持续放大或衰减,最终表现为激活爆炸、梯度接近零或训练早期直接发散。本篇用 ReLU 网络说明初始化的尺度原则,并用 PyTorch 在训练前检查激活与梯度是否处于可用范围。
学习目标
- 识别权重过大或过小时,激活与梯度沿网络深度出现的失稳模式。
- 理解 ReLU 网络中 Kaiming 初始化与
fan_in的关系。 - 用一次前向、反向传播在正式训练前验证初始化是否合理。
初始化问题会沿网络深度累积
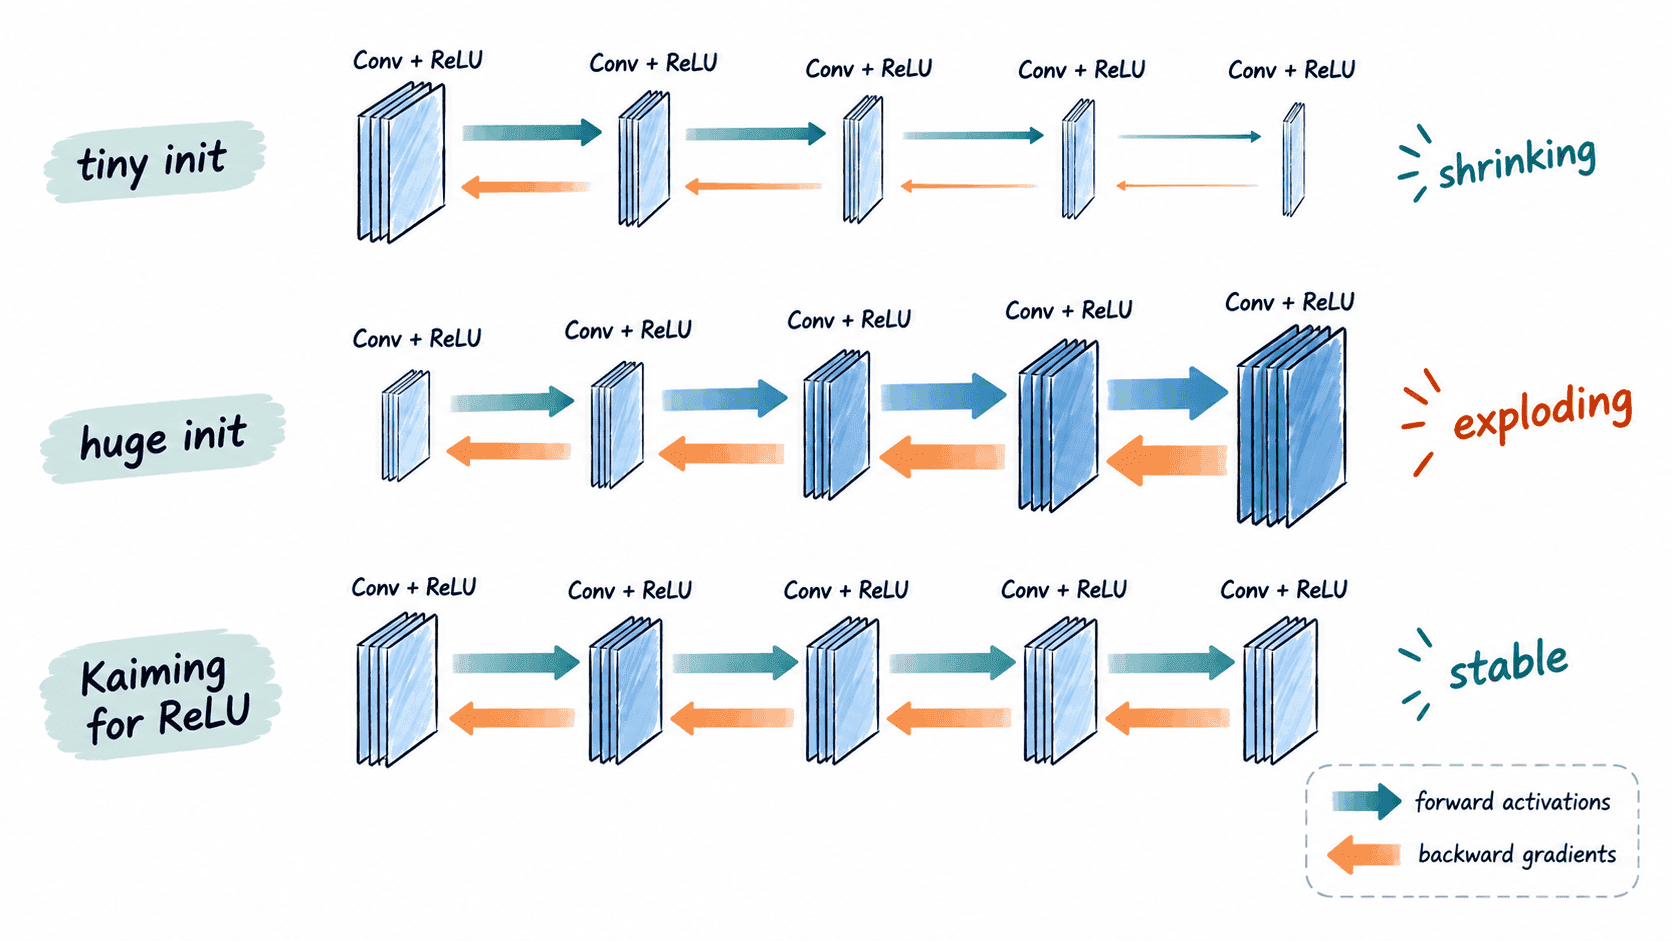
卷积层的输出是许多输入与权重乘积的累加。若每层权重方差偏小,输出方差会逐层收缩;若方差偏大,输出方差则会逐层放大。网络越深,这种偏差越容易呈指数式累积,而不是停留在单层的小误差。
ReLU 又会把负值截断为 0,因此初始化不能只考虑线性层的乘加,还要补偿激活函数造成的方差变化。反向传播时,梯度同样会连续乘上权重和激活函数导数,所以前向激活失稳通常也会伴随梯度过大或过小。
ReLU 为什么适合 Kaiming 初始化
对使用 ReLU 的层,Kaiming 初始化会依据输入连接数 fan_in 调整权重尺度,使前向传播中的方差尽量保持在相近数量级。直觉上,输入连接越多,单个权重就应越小;对 ReLU,常用权重方差约为 2 / fan_in。
在 PyTorch 中,卷积层通常可以使用 nn.init.kaiming_normal_ 或 nn.init.kaiming_uniform_。若目标是优先保持前向激活尺度,使用 mode="fan_in";nonlinearity="relu" 则让初始化公式与 ReLU 匹配。偏置通常初始化为 0 即可。
用激活与梯度直接检查初始化
下面构造同一个 5 层卷积网络,分别使用极小权重、极大权重和 Kaiming 初始化。程序只做一次前向与反向传播,不依赖训练循环,因此适合在正式训练前快速排查数值尺度。
import torch
from torch import nn

torch.manual_seed(7)

class TinyCNN(nn.Module):
    def __init__(self):
        super().__init__()
        self.convs = nn.ModuleList(
            [nn.Conv2d(16, 16, 3, padding=1, bias=False) for _ in range(5)]
        )

    def forward(self, x):
        activation_std = []
        for conv in self.convs:
            x = torch.relu(conv(x))
            activation_std.append(x.detach().std().item())
        return x, activation_std

def init_tiny(module):
    if isinstance(module, nn.Conv2d):
        nn.init.normal_(module.weight, mean=0.0, std=1e-3)

def init_huge(module):
    if isinstance(module, nn.Conv2d):
        nn.init.normal_(module.weight, mean=0.0, std=1.0)

def init_kaiming(module):
    if isinstance(module, nn.Conv2d):
        nn.init.kaiming_normal_(
            module.weight, mode="fan_in", nonlinearity="relu"
        )

def classify_activation(values):
    ratio = values[-1] / values[0]
    if ratio > 10:
        return "exploding"
    if ratio < 0.1:
        return "shrinking"
    return "stable"

def classify_gradient(values):
    largest = max(values)
    if largest > 1000:
        return "too_large"
    if largest < 1e-4:
        return "too_small"
    return "controlled"

def run_case(name, initializer, x):
    model = TinyCNN()
    model.apply(initializer)
    y, activation_std = model(x)

    # 用简单标量损失触发一次反向传播,观察各卷积层梯度范数。
    y.square().mean().backward()
    gradient_norm = [layer.weight.grad.norm().item() for layer in model.convs]

    print(
        f"{name}: activation={classify_activation(activation_std)}, "
        f"gradient={classify_gradient(gradient_norm)}"
    )

x = torch.randn(8, 16, 32, 32)
run_case("tiny", init_tiny, x)
run_case("huge", init_huge, x)
run_case("kaiming", init_kaiming, x)
预期输出
tiny: activation=shrinking, gradient=too_small
huge: activation=exploding, gradient=too_large
kaiming: activation=stable, gradient=controlled
这个检查比只看初始 loss 更直接:极小初始化在深层后几乎抹掉信号,极大初始化则迅速放大数值,而 Kaiming 让各层保持在更接近的尺度。实际模型的具体标准差和梯度范数会随结构、输入和随机种子变化,因此应关注沿深度的趋势,而不是追求某个固定数值。
训练前应该检查什么
初始化完成后,先用一个真实 mini-batch 做一次前向和反向传播。若激活标准差随深度连续缩小几个数量级,或梯度范数出现 0、inf、nan,应先修正初始化、激活函数或网络结构,再调学习率。
还要避免两个常见误区:加载预训练权重后再次执行全模型初始化,会把已学习参数覆盖;使用 LeakyReLU 时,应把负半轴斜率传给对应的 Kaiming 配置,而不是机械沿用 ReLU 参数。初始化的目标不是让每层数值完全相同,而是让信号在训练开始时有足够的动态范围,并且不会随着深度快速失控。