
机器学习与深度学习 / 系统课时
用 CIFAR-10 建立数据基线
用 CIFAR-10 建立数据基线
在改网络结构之前,先把数据管线固定下来,后续实验才有可比性。本节用 CIFAR-10 建立可重复的训练与验证划分,分别配置预处理,并检查类别、样本数量、批次形状和归一化范围。
学习目标
- 构建互不污染的训练集与验证集数据管线
- 检查 CIFAR-10 的类别、样本分布和
BCHW批次形状 - 用可重复的随机划分和确定性的验证预处理建立实验基线
先固定数据基线
CIFAR-10 的训练部分包含 50000 张 32×32 RGB 图片,共 10 个类别。这里从训练部分固定划出 5000 张作为验证集,剩余 45000 张用于训练;官方测试集暂不参与调参,避免把测试结果反复用于模型选择。
训练管线可以包含随机增强,验证管线则应保持确定性。两条管线必须使用同一份划分索引和同一套归一化尺度,但验证集不能继承训练时的随机翻转等增强。
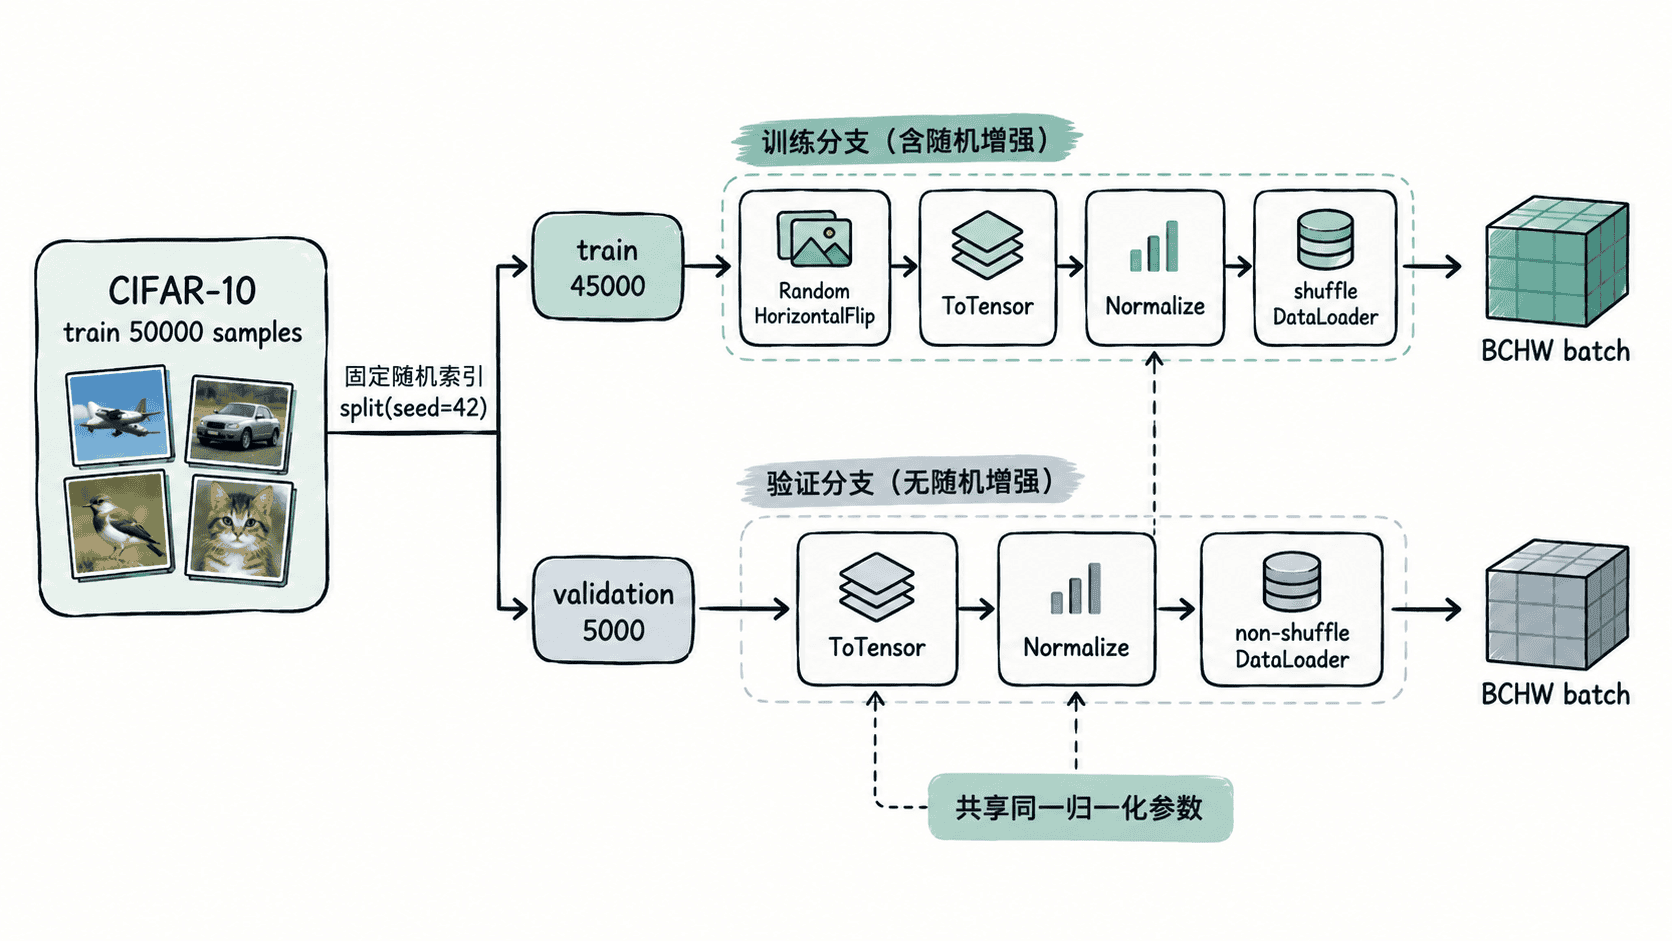
构建训练和验证数据管线
下面的脚本会自动下载数据,使用固定随机种子划分训练和验证索引,并创建两个 DataLoader。训练集加入随机水平翻转,验证集只执行确定性的张量转换和归一化。
from collections import Counter

import torch
from torch.utils.data import DataLoader, Subset
from torchvision import datasets, transforms

ROOT = "./data"
BATCH_SIZE = 64

train_transform = transforms.Compose(
    [
        transforms.RandomHorizontalFlip(),
        transforms.ToTensor(),
        transforms.Normalize([0.5] * 3, [0.5] * 3),
    ]
)
eval_transform = transforms.Compose(
    [
        transforms.ToTensor(),
        transforms.Normalize([0.5] * 3, [0.5] * 3),
    ]
)

# 建立两个指向同一批原始样本的数据集实例,让训练和验证拥有不同 transform。
train_source = datasets.CIFAR10(
    ROOT, train=True, download=True, transform=train_transform
)
eval_source = datasets.CIFAR10(
    ROOT, train=True, download=False, transform=eval_transform
)

# 固定索引划分,保证重复运行时 train/val 成员不漂移。
generator = torch.Generator().manual_seed(42)
indices = torch.randperm(len(train_source), generator=generator).tolist()
val_indices = indices[:5000]
train_indices = indices[5000:]

train_set = Subset(train_source, train_indices)
val_set = Subset(eval_source, val_indices)

train_loader = DataLoader(
    train_set,
    batch_size=BATCH_SIZE,
    shuffle=True,
    num_workers=0,
    generator=torch.Generator().manual_seed(42),
)
val_loader = DataLoader(
    val_set,
    batch_size=BATCH_SIZE,
    shuffle=False,
    num_workers=0,
)

# 先检查源数据分布,再取一个训练批次检查模型真正收到的张量。
source_counts = Counter(eval_source.targets)
distribution = {
    train_source.classes[i]: source_counts[i]
    for i in range(len(train_source.classes))
}
images, labels = next(iter(train_loader))

print("classes =", train_source.classes)
print("source distribution =", distribution)
print("train/val =", len(train_set), len(val_set))
print("batch =", images.shape, labels.shape, images.dtype)
print(
    "normalized range valid =",
    bool((images >= -1.0).all() and (images <= 1.0).all()),
)
首次运行时会额外出现下载进度;数据已经存在时也可能出现缓存校验提示。与数据基线直接相关的预期输出如下。
预期输出
classes = ['airplane', 'automobile', 'bird', 'cat', 'deer', 'dog', 'frog', 'horse', 'ship', 'truck']
source distribution = {'airplane': 5000, 'automobile': 5000, 'bird': 5000, 'cat': 5000, 'deer': 5000, 'dog': 5000, 'frog': 5000, 'horse': 5000, 'ship': 5000, 'truck': 5000}
train/val = 45000 5000
batch = torch.Size([64, 3, 32, 32]) torch.Size([64]) torch.float32
normalized range valid = True
读懂四项基线检查
类别列表用于确认标签语义没有错位;源数据每类 5000 张,说明原始训练部分是均衡的。随机划分后的训练集与验证集不保证每类数量完全相等,因此后续若要做严格分层抽样,需要单独按标签构造索引。
批次形状 64×3×32×32 说明模型收到的是 BCHW。标签形状是 64,表示每张图片对应一个类别编号。使用 mean=0.5、std=0.5 后,原本位于 0~1 的张量会映射到 -1~1,布尔检查为 True 即表示本批数据没有越出预期范围。
训练集启用了随机水平翻转,因此同一张图片在不同 epoch 可能得到不同输入;验证集没有随机增强,所以同一模型在相同权重和环境下能得到稳定、可比较的验证结果。
出现异常时先检查数据而不是改模型
如果批次不是 B×3×32×32,先检查是否误用了通道顺序或 transform;如果标签数量和图片数量不一致,检查 Subset 是否使用了同一组索引;如果验证指标波动异常,确认验证 transform 中没有随机增强。
这份基线的价值不在于复杂,而在于把划分、预处理、批次形状和验证规则固定下来。后续更换 CNN 结构、优化器或学习率时,只要保持这条数据基线不变,实验差异才主要来自模型本身。