
机器学习与深度学习 / 系统课时
搭建第一个卷积分类器
搭建第一个卷积分类器
这一节把卷积、ReLU、池化和全连接分类头真正连成一个可训练的 CNN。你会先把每层张量形状算清楚,再用一个可分的合成图像数据集完成训练、验证与单样本预测,确保前向、损失、反向传播和推理链路都能闭环。
学习目标
- 能组合
Conv2d、ReLU、MaxPool2d、Flatten与Linear搭建基础分类器。 - 能从输入尺寸推导每层输出形状,并定位全连接层维度不匹配。
- 能区分训练、验证与单样本预测时的模型状态和梯度处理。
先固定输入与网络形状
示例使用单通道 16×16 图像和两个类别。输入张量遵循 NCHW:批量大小 N、通道数 C、高度 H、宽度 W。第一个卷积把通道从 1 扩到 4,第二个卷积再扩到 8;两个 2×2 最大池化各把空间尺寸减半。
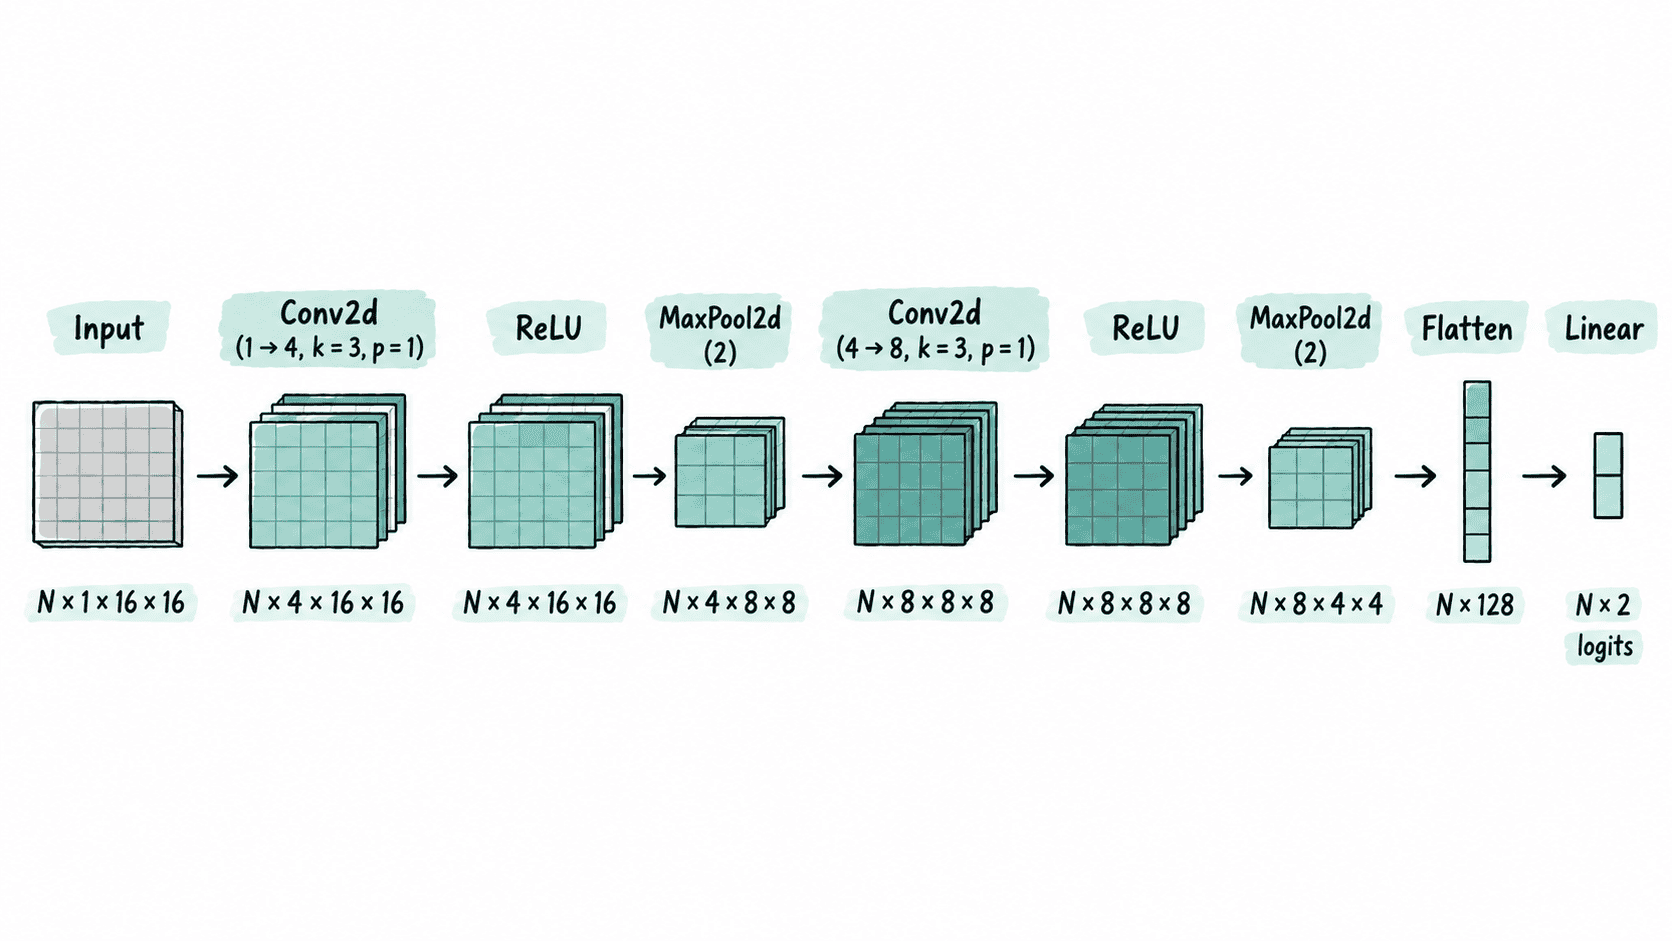
最后一次池化得到 8×4×4,因此每张图展平后是 128 个特征,全连接层必须写成 Linear(128, 2)。这一步如果算错,前向传播会直接在矩阵乘法处报维度不匹配。
实现可运行的最小分类器
下面的程序不依赖外部数据下载。类别 0 在图像上方生成亮条带,类别 1 在下方生成亮条带,并加入少量噪声;CNN 只需学会区分局部亮区出现的位置。
import torch
from torch import nn
from torch.utils.data import DataLoader, TensorDataset

torch.manual_seed(7)

def make_dataset(n: int):
    labels = torch.arange(n) % 2
    images = torch.zeros(n, 1, 16, 16)
    images[labels == 0, :, 2:6, 2:14] = 1.0
    images[labels == 1, :, 10:14, 2:14] = 1.0

    # 加少量噪声,避免模型只记住完全相同的像素模板。
    images = (images + 0.05 * torch.randn_like(images)).clamp(0, 1)
    order = torch.randperm(n)
    return images[order], labels[order]

class TinyCNN(nn.Module):
    def __init__(self):
        super().__init__()
        self.conv1 = nn.Conv2d(1, 4, kernel_size=3, padding=1)
        self.pool1 = nn.MaxPool2d(2)
        self.conv2 = nn.Conv2d(4, 8, kernel_size=3, padding=1)
        self.pool2 = nn.MaxPool2d(2)
        self.classifier = nn.Sequential(
            nn.Flatten(),
            nn.Linear(8 * 4 * 4, 2),
        )

    def forward(self, x):
        x = self.pool1(torch.relu(self.conv1(x)))
        x = self.pool2(torch.relu(self.conv2(x)))
        return self.classifier(x)

    def trace_shapes(self, x):
        print("input=", tuple(x.shape))
        x = torch.relu(self.conv1(x))
        print("conv1=", tuple(x.shape))
        x = self.pool1(x)
        print("pool1=", tuple(x.shape))
        x = torch.relu(self.conv2(x))
        print("conv2=", tuple(x.shape))
        x = self.pool2(x)
        print("pool2=", tuple(x.shape))
        print("logits=", tuple(self.classifier(x).shape))

train_x, train_y = make_dataset(128)
val_x, val_y = make_dataset(32)
train_loader = DataLoader(
    TensorDataset(train_x, train_y),
    batch_size=16,
    shuffle=True,
)

model = TinyCNN()
model.trace_shapes(train_x[:2])

loss_fn = nn.CrossEntropyLoss()
optimizer = torch.optim.Adam(model.parameters(), lr=0.01)

# 训练阶段需要梯度、反向传播和参数更新。
for _ in range(5):
    model.train()
    for x, y in train_loader:
        optimizer.zero_grad()
        loss = loss_fn(model(x), y)
        loss.backward()
        optimizer.step()

# 验证和预测都关闭梯度,避免额外保存计算图。
model.eval()
with torch.no_grad():
    val_pred = model(val_x).argmax(dim=1)
    val_acc = (val_pred == val_y).float().mean().item()
    one_pred = model(val_x[:1]).argmax(dim=1).item()

print(f"validation_accuracy={val_acc:.2f}")
print(f"single_prediction={one_pred} target={val_y[0].item()}")
预期输出
input= (2, 1, 16, 16)
conv1= (2, 4, 16, 16)
pool1= (2, 4, 8, 8)
conv2= (2, 8, 8, 8)
pool2= (2, 8, 4, 4)
logits= (2, 2)
validation_accuracy=1.00
single_prediction=1 target=1
这个数据集故意设计得很容易分,固定随机种子时应很快达到满分;若底层数值实现不同,训练中的浮点细节可能略有差异,但张量形状不会变化。
读懂分类器中的形状变化
| 位置 | 每个批次的张量形状 | 作用 |
|---|---|---|
| 输入 | N×1×16×16 |
一批单通道图像 |
| 第一次卷积后 | N×4×16×16 |
提取 4 组局部特征 |
| 第一次池化后 | N×4×8×8 |
空间尺寸减半 |
| 第二次卷积后 | N×8×8×8 |
组合更丰富的局部模式 |
| 第二次池化后 | N×8×4×4 |
再次压缩空间尺寸 |
| 展平后 | N×128 |
把特征图交给分类头 |
| 线性层后 | N×2 |
为两个类别输出 logits |
CrossEntropyLoss 直接接收这两个 logits 和整数类别标签,因此 forward 中不需要先做 Softmax。预测时再用 argmax(dim=1) 取分数最大的类别即可。
把训练、验证和预测分清
训练阶段要执行 model.train()、清零梯度、计算损失、backward() 和 optimizer.step();验证阶段使用 model.eval() 与 torch.no_grad(),只统计预测结果,不更新参数。单样本预测仍要保留批量维度,所以示例使用 val_x[:1] 而不是 val_x[0]。
当输入分辨率、池化次数或卷积步幅发生变化时,最容易失效的是全连接层的 in_features。先打印形状再改网络,比看到矩阵乘法报错后盲猜数字更可靠;只要能解释 N×1×16×16 如何变成 N×128,这个基础 CNN 的数据流就真正跑通了。