
机器学习与深度学习 / 系统课时
处理类别不平衡与难样本
处理类别不平衡与难样本
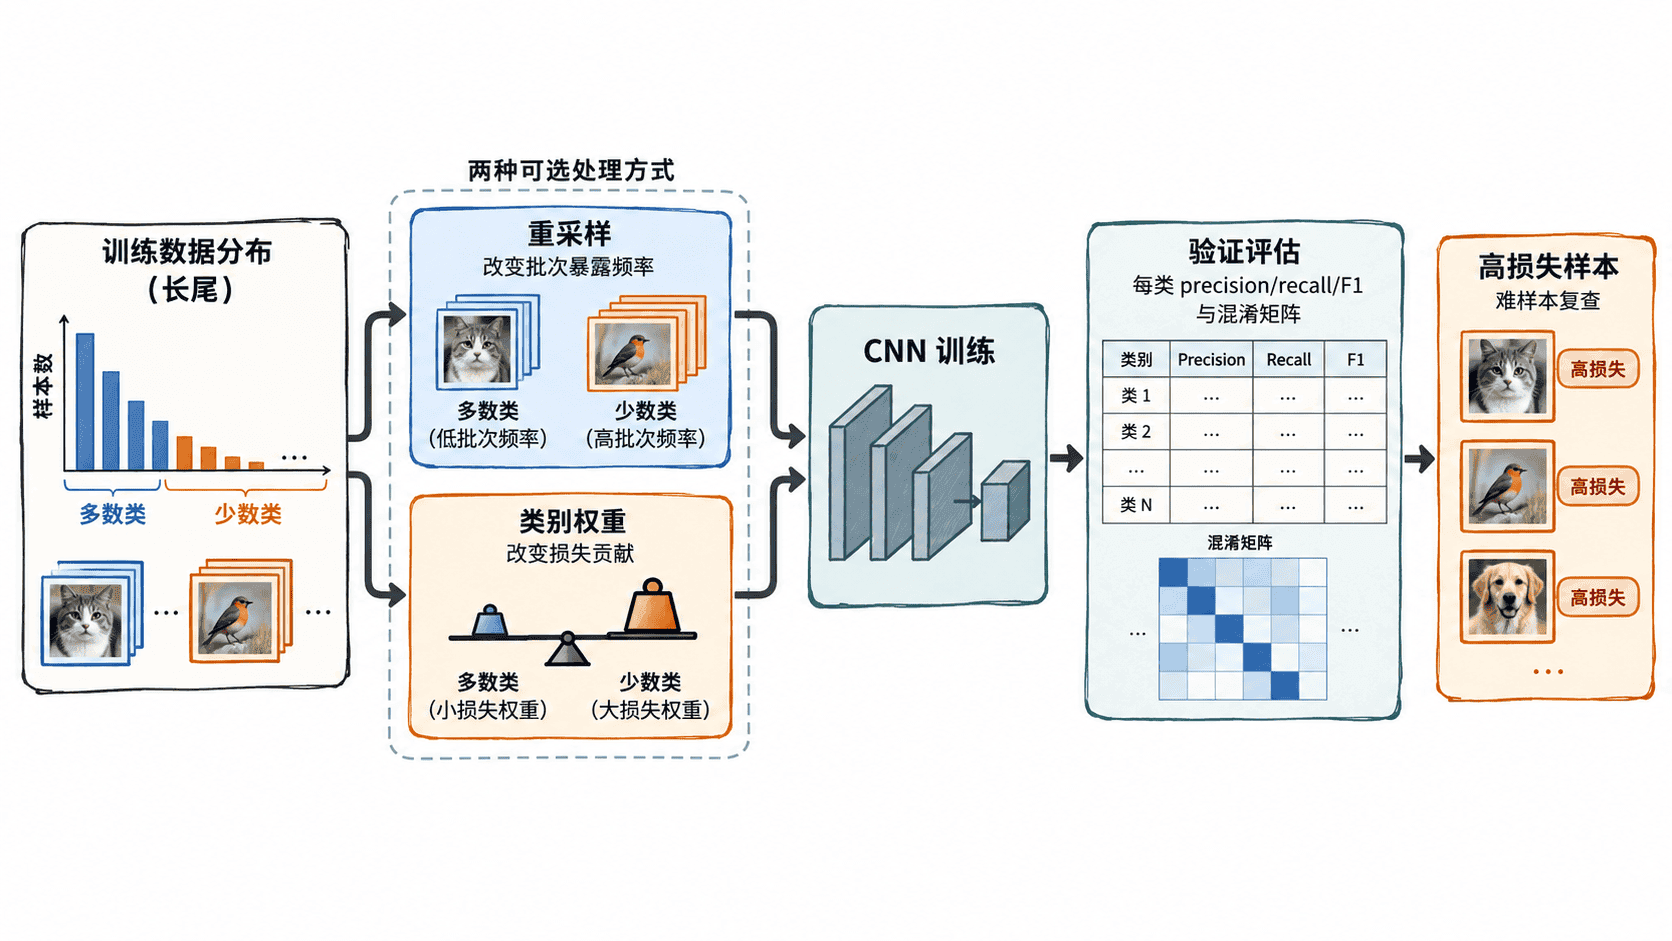
小样本分类里,整体准确率变高并不代表模型真的学会了少数类别。本篇用“先量化分布,再选择重采样或类别权重,最后按每类指标与难样本复查”的路径,建立一套可验证的处理方法。
学习目标
- 识别长尾分布造成的多数类偏置,并区分数据问题与模型问题
- 根据场景选择重采样、类别权重或难样本处理,而不是盲目叠加策略
- 用每类精确率、召回率和混淆情况验证少数类别是否真正改善
先确认偏置来自哪里
类别不平衡首先改变模型“看见各类别的频率”。假设训练集有 1000 张 A、200 张 B、20 张 C,即使随机打乱,梯度更新仍主要由 A 驱动。模型只要优先预测 A,就可能得到看似不错的总体准确率,却让 C 的召回率接近零。
因此先记录每类样本数,再同时看每类召回率和混淆去向。若少数类召回率低、且大量被预测成头部类,才说明长尾偏置明显;若少数类本身标注错误、图像过暗或类别边界含混,单纯加权反而会放大噪声。
在采样和损失之间做选择
重采样和类别权重解决的是同一偏置的不同位置。重采样让少数类在训练批次里出现得更频繁;类别权重保持原始采样分布,但让少数类样本产生更大的损失贡献。一个常用的反频率权重是 ,其中 是总样本数, 是类别数, 是第 类样本数。
| 情况 | 优先策略 | 主要风险 |
|---|---|---|
| 少数类样本较干净,只是数量偏少 | 类别权重 | 权重过大会放大异常样本 |
| 少数类极少,普通批次经常看不到 | 重采样或有约束的数据增强 | 重复样本过多导致过拟合 |
| 多数样本很容易,少量边界样本持续出错 | 难样本挖掘或 Focal Loss | 过早聚焦高损失样本会追噪声 |
不要一开始同时使用强重采样和很大的类别权重,否则少数类可能被“双重放大”。更稳妥的顺序是先建立无处理基线,再只改变一个因素,比较少数类召回率、宏平均 F1 和多数类退化幅度。
计算权重并筛出高损失样本
下面的脚本用一个长尾标签列表计算反频率权重,并从已有单样本损失中找出最难的三个样本。它不依赖深度学习框架,结果可直接帮助你检查权重数量级和难样本索引。
from collections import Counter

labels = [0, 0, 0, 0, 0, 0, 1, 1, 1, 2]
sample_losses = [0.08, 0.11, 0.20, 0.05, 0.14, 0.31, 0.70, 0.42, 0.55, 1.40]

counts = Counter(labels)
total = len(labels)
class_count = len(counts)

# 反频率权重让稀有类别在损失中获得更高贡献。
class_weight = {
    cls: total / (class_count * count)
    for cls, count in counts.items()
}

# 高损失样本只是复查候选,不能直接等同于“值得加强训练”的样本。
hard_indices = sorted(
    range(len(sample_losses)),
    key=sample_losses.__getitem__,
    reverse=True,
)[:3]

print("counts =", dict(counts))
print("class_weight =", {k: round(v, 2) for k, v in class_weight.items()})
print(
    "hard_samples =",
    [(i, labels[i], sample_losses[i]) for i in hard_indices],
)
预期输出:
counts = {0: 6, 1: 3, 2: 1}
class_weight = {0: 0.56, 1: 1.11, 2: 3.33}
hard_samples = [(9, 2, 1.4), (6, 1, 0.7), (8, 1, 0.55)]
在 PyTorch 中,这组类别权重可以按类别顺序转换成张量后传给 CrossEntropyLoss(weight=...);如果改用 WeightedRandomSampler,则应给每个样本分配与其类别频次相关的采样权重。两种方法的目的不同,不要把“类别权重”误当成“样本采样概率”。
难样本先复查再强化
高损失样本通常有三类:真正位于决策边界的样本、数据质量差但标签正确的样本,以及标签本身错误的样本。只有前两类可能值得增加训练关注,第三类应先修正或移除,否则模型会被迫拟合错误监督信号。
难样本挖掘最好在模型已经具有基本识别能力后进行,并限制每个批次中难样本的比例。若从训练一开始就只追逐最高损失样本,随机初始化阶段的“高损失”没有稳定语义,还可能让少数异常值主导梯度。
用每类指标验收改动
最终判断标准不是训练损失下降,而是独立验证集上的类别级表现。至少固定同一验证集、同一预处理和同一决策规则,对比基线与新策略的每类 precision、recall、F1,以及宏平均 F1。
当少数类召回率上升时,还要检查它是否以大量误报为代价。若 C 类召回从 0.30 提升到 0.70,但 precision 从 0.80 跌到 0.25,就不能只凭“召回提升”宣布成功。一个可靠的改动应同时说明改善了哪个类别、牺牲了什么,以及这种交换是否符合实际错误成本。