
NoSQL 与搜索 / 系统课时
控制文档增长与 16MB 上限
控制文档增长与 16MB 上限
MongoDB 的灵活文档结构很容易把“先放进数组里”演变成长期增长的巨型文档。问题往往在真正撞到 16 MiB 之前就出现:更新越来越重、索引条目增多、读取携带大量无关数据。本节用可测量的 BSON 大小和拆分策略,把增长控制在设计阶段。
学习目标
- 理解 16 MiB BSON 文档上限与性能风险的区别
- 识别无界数组、频繁追加和大字段导致的增长问题
- 用子集合、分桶和有限子集设计稳定的拆分边界
把 16 MiB 当硬边界而不是容量目标
MongoDB 单个 BSON 文档必须小于 16 MiB。这个限制针对整个文档,不只是某个数组或字符串;字段名、数组元素、嵌套对象等编码开销也计入 BSON 大小。因此,不能用“业务数据还没到 16 MB”来估算安全余量。
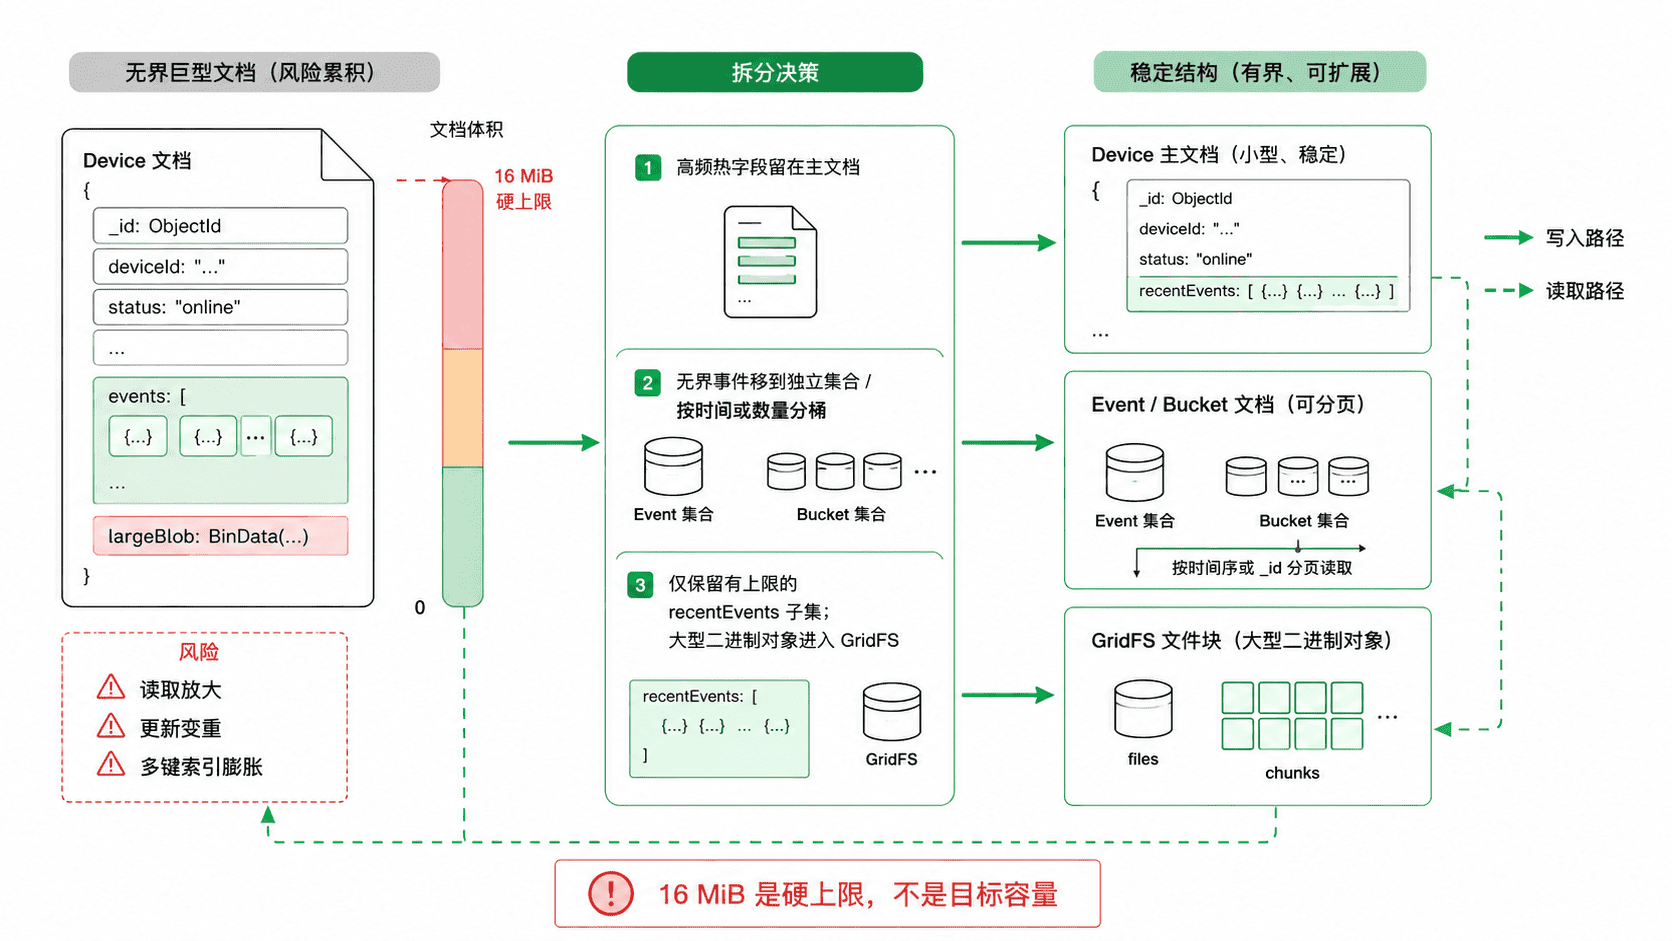
更重要的是,接近上限并不代表设计仍然健康。一个经常读取的文档如果带着几 MB 的历史数组或大文本,会放大网络传输和工作集占用;持续 $push 的大数组还会增加更新与多键索引维护成本。容量上限是最后一道硬限制,性能边界通常更早出现。
用 BSON 大小观察真实增长
不要只用 JSON 字符数估算。MongoDB 可以用 $bsonSize 计算文档编码后的字节数,适合抽样找出集合中的大文档。下面先创建三条事件,再直接测量整份文档。
db.devices.drop();

db.devices.insertOne({
  _id: "device-1",
  status: "online",
  events: [
    { ts: ISODate("2026-08-26T10:00:00Z"), type: "boot" },
    { ts: ISODate("2026-08-26T10:05:00Z"), type: "heartbeat" },
    { ts: ISODate("2026-08-26T10:10:00Z"), type: "heartbeat" }
  ]
});

db.devices.aggregate([
  {
    $project: {
      _id: 1,
      eventCount: { $size: "$events" },
      sizeBytes: { $bsonSize: "$$ROOT" }
    }
  }
]);
预期输出
{ _id: 'device-1', eventCount: 3, sizeBytes: <VALUE> }<VALUE> 是该文档实际编码后的 BSON 字节数,具体数值由字段和值决定。生产中可以定期按 sizeBytes 排序抽样,观察 P95/P99 文档大小和增长最快的实体,而不是等写入失败后才处理。
按生命周期拆开无界数据
判断是否应该拆分时,先问“这部分数据会不会一直增加”和“主页面是否每次都必须读取它”。设备事件、评论、消息、审计记录这类集合通常没有稳定上限,应放入子集合,并用父 ID 与时间建立索引;主文档只保存当前状态、计数器或最近少量条目。
例如把事件从 devices.events 拆到 deviceEvents 后,可以使用 { deviceId: 1, ts: -1 } 支持“读取某设备最近事件”。如果业务天然按小时、天或固定条数批量读取,可进一步使用 Bucket Pattern,把一段有上限的事件放进一个桶文档;时间序列数据则优先评估 MongoDB time series collection,而不是自己维护无限数组。
对于“首页只看最近 20 条,但历史必须保留”的场景,可以在主文档保留受 $slice 约束的 recentEvents 作为有限子集,同时把完整历史保存在子集合。此时要明确哪一份是权威数据以及失败后的修复方式,避免把同一事件的两份副本都当作事实源。
大字段与异常大实体单独处理
大图片、视频或其他二进制对象如果可能让单个文档超过 16 MiB,应使用 GridFS 或对象存储,而不是把 Base64 字符串塞进普通 BSON 文档。对少量异常大的业务实体,也可以采用 Outlier Pattern:普通实体保持紧凑,只有异常对象把大数组移到额外文档。
拆分标准不应只看字节数,还要一起看读取局部性和写入频率。经常一起读、一起改且大小有稳定上限的数据适合嵌入;会无界增长、独立分页、独立更新或体积明显偏大的数据应拆开。 这样既远离 16 MiB 硬限制,也让常用文档长期保持可预测的读写成本。