
NoSQL 与搜索 / 系统课时
使用 Subset Pattern 控制热文档
使用 Subset Pattern 控制热文档
当一个主文档包含不断增长的评论、事件或历史记录时,常用详情查询会被迫反复读取大量冷数据。Subset Pattern 把最常访问的一小部分保留在主文档,把完整集合拆到独立文档中,用更小的热文档换取更稳定的读取成本。
学习目标
- 识别“主文档很热,但其中大部分数组元素很冷”的访问模式。
- 设计主文档热子集与完整明细集合之间的边界和索引。
- 处理子集更新、重复数据一致性与失败后的重建策略。
从访问模式确定热子集
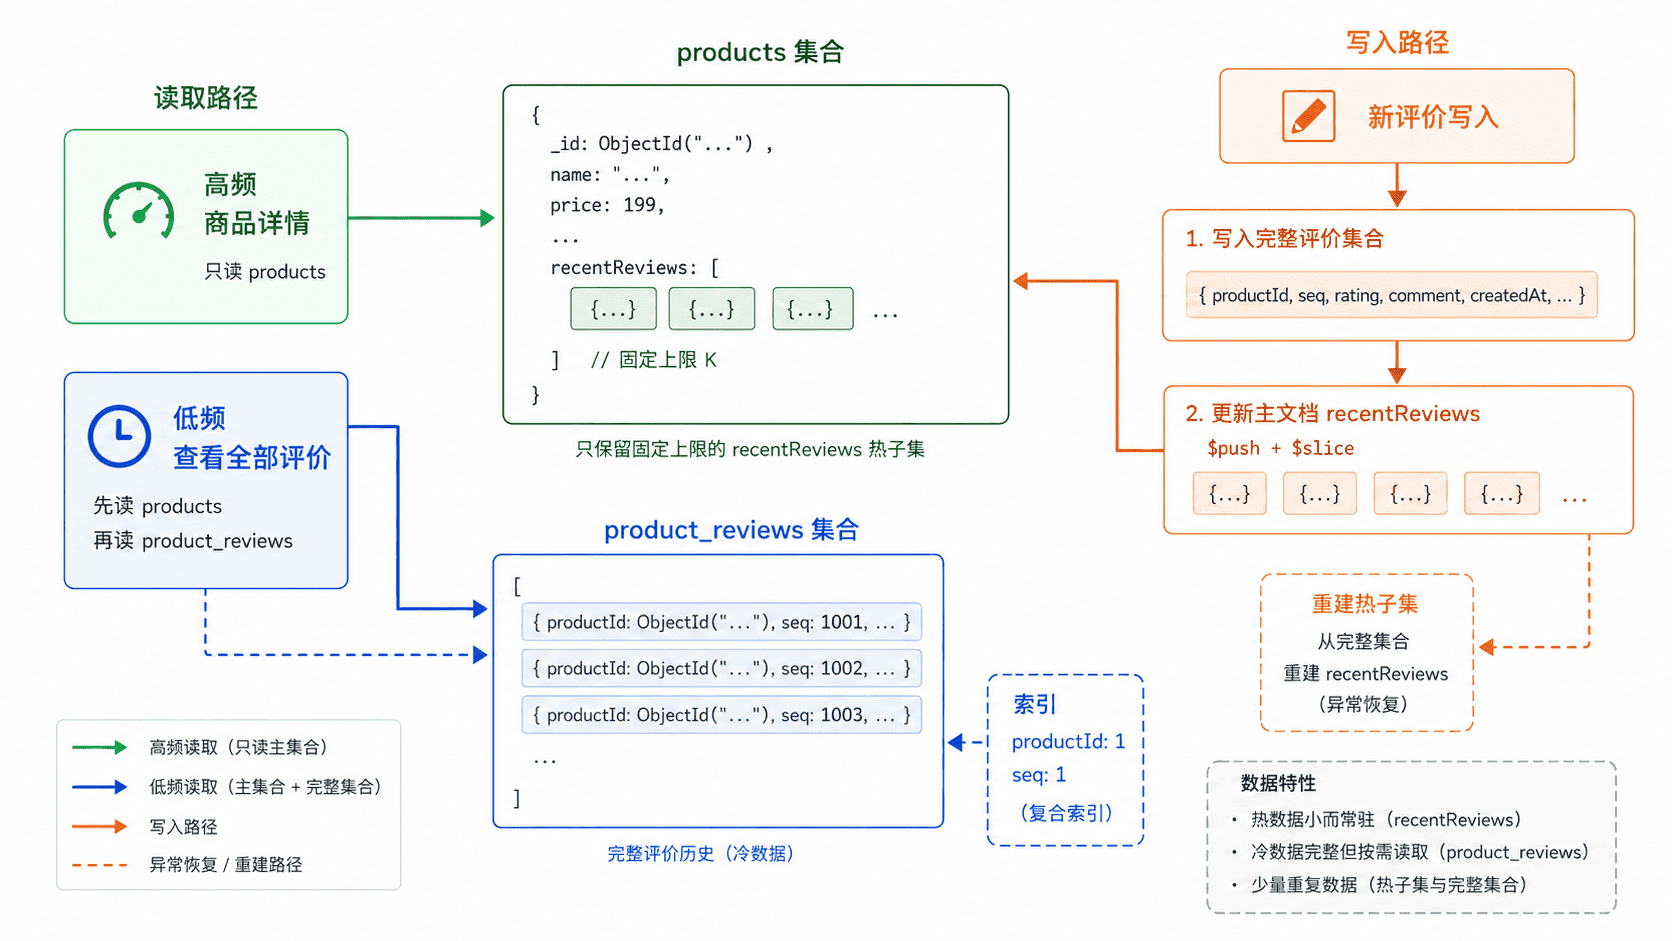
假设商品详情页几乎每次都展示最新两条评价,而“查看全部评价”只有少量请求会进入。如果把所有评价永久嵌入 products.reviews,数组会持续增长,详情查询读取的数据量也随历史累积。Subset Pattern 则只在商品文档中保留最新两条,同时把所有评价存入 product_reviews。
这里的关键不是“把大文档随便拆开”,而是先找到稳定的热数据边界:主路径一次读取就够用,冷路径允许额外查询。热子集应有明确上限,例如最新 2 条、前 5 个成员或常用的少量摘要字段。
建立主文档和完整明细
下面的样例让 products.recentReviews 只保存最新两条评价,而 product_reviews 保存全部记录。冷数据查询按 productId 过滤、按 seq 倒序,因此建立与访问路径一致的复合索引。
db.products.drop();
db.product_reviews.drop();

db.products.insertOne({
  _id: "p1",
  name: "机械键盘",
  recentReviews: [
    { reviewId: "r3", rating: 5, text: "手感稳定" },
    { reviewId: "r2", rating: 4, text: "声音略大" }
  ]
});

db.product_reviews.insertMany([
  { _id: "r1", productId: "p1", seq: 1, rating: 3, text: "包装一般" },
  { _id: "r2", productId: "p1", seq: 2, rating: 4, text: "声音略大" },
  { _id: "r3", productId: "p1", seq: 3, rating: 5, text: "手感稳定" }
]);

db.product_reviews.createIndex({ productId: 1, seq: -1 });

const hot = db.products.findOne(
  { _id: "p1" },
  { _id: 0, name: 1, recentReviews: 1 }
);
const latest = db.product_reviews
  .find({ productId: "p1" })
  .sort({ seq: -1 })
  .limit(2)
  .toArray();

print(`${hot.name}:${hot.recentReviews.map(r => r.reviewId).join(",")}`);
print(latest.map(r => r._id).join(","));
预期输出:
机械键盘:r3,r2
r3,r2
详情页只需要读取商品文档即可得到常用信息;完整历史仍然存在于 product_reviews,需要时再分页读取。主文档中的两条评价是为高频访问复制的子集,不应被视为完整历史的唯一事实来源。
让热子集始终有界
新增评价时,完整记录与热子集都要更新。$push 配合 $position: 0 和 $slice 可以把新元素放到数组头部,并把数组截断到固定长度,避免热文档重新变成无界数组。
片段示例:以下操作承接前面的样例数据,先写完整评价,再刷新商品上的两条热评价。
const review = {
  _id: "r4",
  productId: "p1",
  seq: 4,
  rating: 5,
  text: "键帽不错"
};

db.product_reviews.insertOne(review);

db.products.updateOne(
  { _id: "p1" },
  {
    $push: {
      recentReviews: {
        $each: [
          {
            reviewId: review._id,
            rating: review.rating,
            text: review.text
          }
        ],
        $position: 0,
        $slice: 2
      }
    }
  }
);

print(
  db.products.findOne({ _id: "p1" })
    .recentReviews.map(r => r.reviewId)
    .join(",")
);
预期输出:
r4,r3这两个写操作跨文档、跨集合,默认不是一个原子动作。若业务要求“评价落库”和“详情页立即看到最新子集”必须同时成功,应使用事务;若允许短暂延迟,可以把 product_reviews 作为事实来源,再通过异步任务更新或重建 recentReviews。
判断是否值得使用
Subset Pattern 适合三个条件同时成立的场景:主文档访问频繁、其中存在明显的冷热数据差异、热子集可以被固定上限稳定描述。它不仅减少单次返回体积,也避免常用查询反复携带长数组进入工作集。
如果几乎每次读取都需要完整明细,拆出子集只会增加一次额外查询;如果被复制字段更新极其频繁且不能容忍短暂不一致,维护成本也可能超过收益。设计时应把完整集合视为可重建热子集的事实来源,并为冷数据查询建立贴合筛选和排序的索引,这样性能收益才不会以不可控的一致性风险为代价。