
NoSQL 与搜索 / 系统课时
监控 Oplog 与复制延迟
监控 Oplog 与复制延迟
复制集出现 lag 时,关键不是只看“落后了多少秒”,而是把复制延迟、oplog 可追赶窗口和成员状态放在同一条时间线上判断。本课会建立一套可重复的检查顺序,并用磁盘、网络和写入峰值解释常见异常。
学习目标
- 读取 oplog window、成员状态与 secondary 相对 primary 的复制时间差。
- 区分短时抖动、持续 lag 与 oplog 窗口不足三类风险。
- 按磁盘、网络和写入压力的顺序定位复制延迟根因。
先看三组信号
复制健康度至少要同时观察三组值:primary 与 secondary 的 optimeDate 差值、oplog 从最旧到最新记录覆盖的时间范围,以及成员当前的 stateStr、health 等状态。rs.printSecondaryReplicationInfo() 可快速查看 secondary 落后时间,rs.printReplicationInfo() 或 db.getReplicationInfo() 可查看 oplog 的时间跨度。:contentReference[oaicite:0]{index=0}
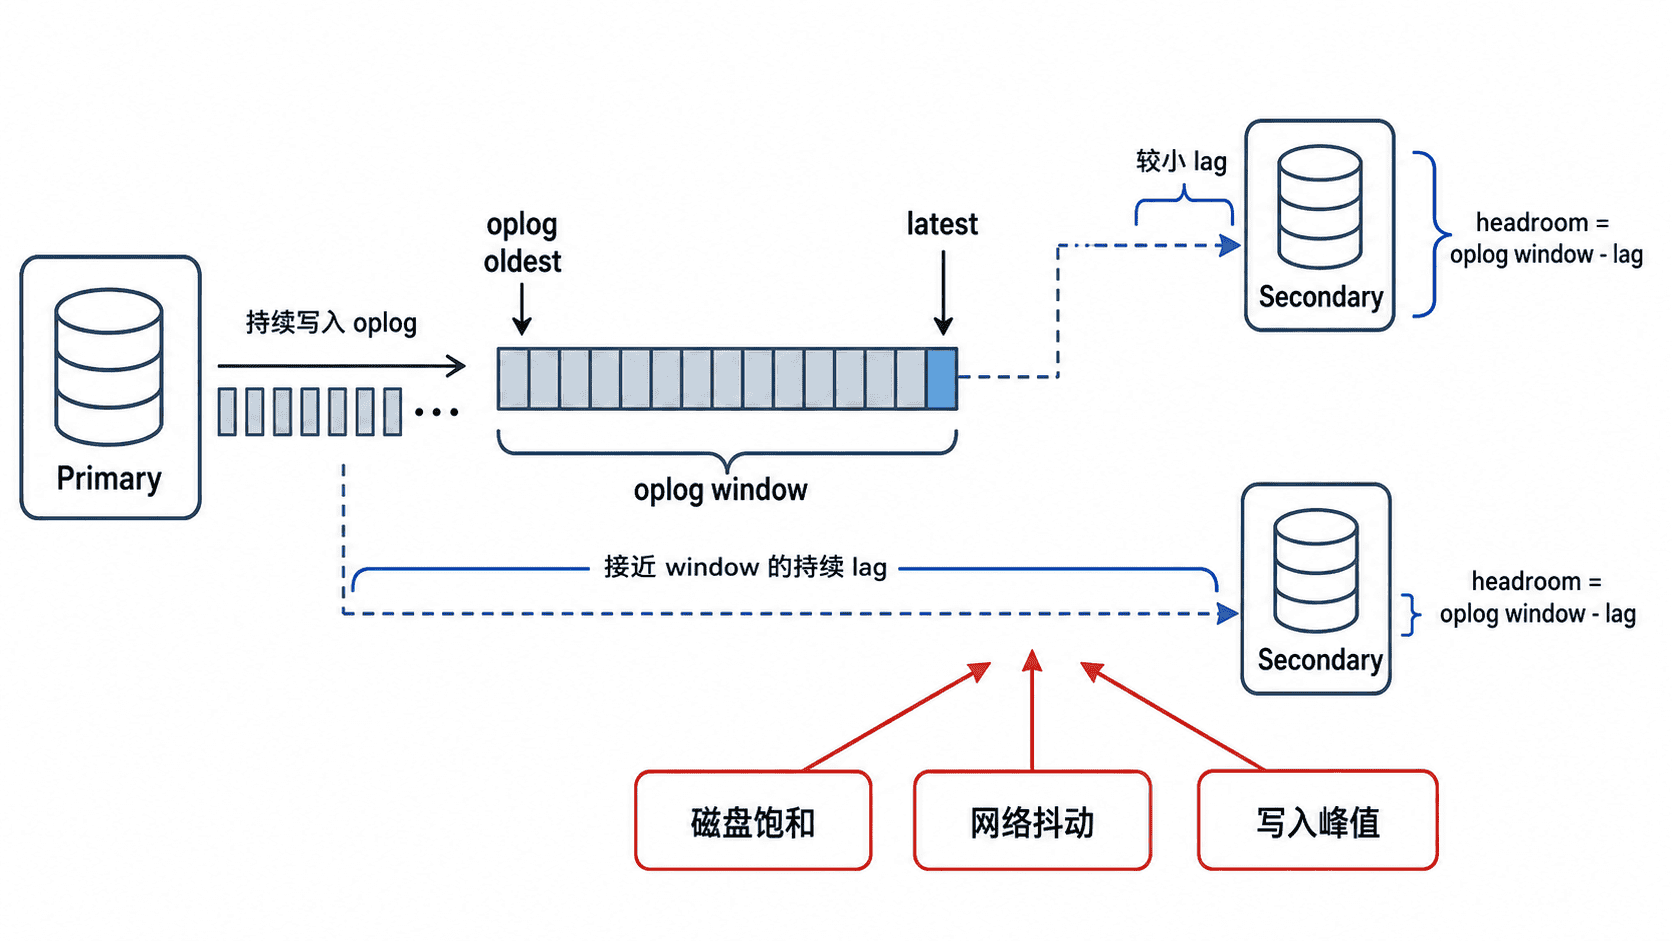
可以把风险直观理解为“可追赶余量 = oplog window - 最大复制 lag”。lag 很小但 window 也很短,仍可能经不起维护或网络中断;lag 持续增长并逼近 window,则表示 secondary 正在失去依靠增量 oplog 追赶的安全空间。
采集一份可比较的快照
在 primary 的 mongosh 中执行下面脚本。它把成员的 optimeDate 转成相对 primary 的秒级 lag,并同时输出当前成员的 oplog 信息,适合手工检查或复制到值班记录中。
const status = rs.status();
const primary = status.members.find((m) => m.stateStr === "PRIMARY");

if (!primary) {
  throw new Error("当前状态中没有 PRIMARY,先检查是否正在选举或失去多数派");
}

const lagRows = status.members.map((m) => ({
  name: m.name,
  state: m.stateStr,
  health: m.health,
  optimeDate: m.optimeDate,
  lagSeconds: m.optimeDate
    ? Math.max(0, (primary.optimeDate - m.optimeDate) / 1000)
    : null
}));

printjson(lagRows);
printjson(db.getReplicationInfo());
预期输出
[
  { name: 'mongo-a:<PORT>', state: 'PRIMARY', health: 1, optimeDate: ISODate('<TIME>'), lagSeconds: 0 },
  { name: 'mongo-b:<PORT>', state: 'SECONDARY', health: 1, optimeDate: ISODate('<TIME>'), lagSeconds: <VALUE> },
  { name: 'mongo-c:<PORT>', state: 'SECONDARY', health: 1, optimeDate: ISODate('<TIME>'), lagSeconds: <VALUE> }
]
{
  logSizeMB: <VALUE>,
  usedMB: <VALUE>,
  timeDiff: <VALUE>,
  timeDiffHours: <VALUE>,
  tFirst: '<TIME>',
  tLast: '<TIME>',
  now: '<TIME>'
}<PORT>、<TIME> 和 <VALUE> 会随部署与采样时刻变化。单次快照只能回答“现在怎样”,生产监控还应把最大 lag、oplog window 和状态变化做成连续指标。
按因果链定位 lag
如果 lag 只在写入峰值期间升高,峰值结束后很快回落,先比较 primary 的 oplog 产生速率与 secondary 的应用能力;如果 lag 持续爬升,则说明 secondary 长时间消费不过来。MongoDB 的排障文档也把网络连通性和 primary/secondary 资源不足列为复制问题的重要方向。:contentReference[oaicite:1]{index=1}
磁盘问题通常表现为 secondary 写延迟、I/O 等待或队列深度同步升高,复制应用速度下降。网络问题更常伴随跨可用区 RTT 增长、丢包、重传或成员心跳异常。写入峰值则会让 oplog 增长更快,导致相同容量的 oplog 覆盖时间缩短,因此需要把“lag 秒数”和“window 小时数”一起看。
修复后按同一标准验收
修复动作应针对瓶颈本身:磁盘饱和就提升 IOPS 或降低同盘竞争,网络异常就处理链路质量,持续写入峰值则评估写入模型与 oplog 容量。扩大 oplog 能增加追赶缓冲,但不会消除 secondary 本身处理不过来的根因。
验收时重新采集同样的快照,确认 secondary 的 lag 不再持续增长,成员保持 SECONDARY 且 health 正常,并且 oplog window 明显大于预期最长中断加最大日常 lag。若所需 oplog 已经被滚出窗口,单纯等待不会恢复增量追赶,应按复制集恢复流程评估重新同步。