
NoSQL 与搜索 / 系统课时
选择高质量 Shard Key
选择高质量 Shard Key
Shard Key 一旦进入生产,就会决定数据如何切分、查询能否定向路由,以及写入热点会落在哪个 shard。本课给出一套从访问模式反推候选键的方法,并用基数、频率、单调性和查询局部性比较 ranged 与 hashed sharding,避免只凭“字段唯一”做选择。
学习目标
- 用基数、值频率、单调性和访问模式评估候选 shard key
- 判断 ranged sharding 与 hashed sharding 分别适合什么读写特征
- 用样例数据量化高频值风险,并把查询效率与写入均衡放到同一决策中
先从真实访问模式反推候选键
先列出最重要的查询和写入,而不是先找一个看起来“分布均匀”的字段。对每类请求记录过滤条件、排序范围、写入速率以及是否必须只访问少量 shard。一个键如果写入分布很好,却让核心查询长期 scatter-gather,整体成本仍然可能更高。
候选键至少要回答五个问题:值的基数是否足够高;单个值出现频率是否过高;新值是否单调增长;核心查询能否带上完整键或可用前缀;某个租户、地区或时间段是否可能形成长期热点。高基数不等于低频率,hashed 也无法修复大量文档拥有同一个键值的问题。
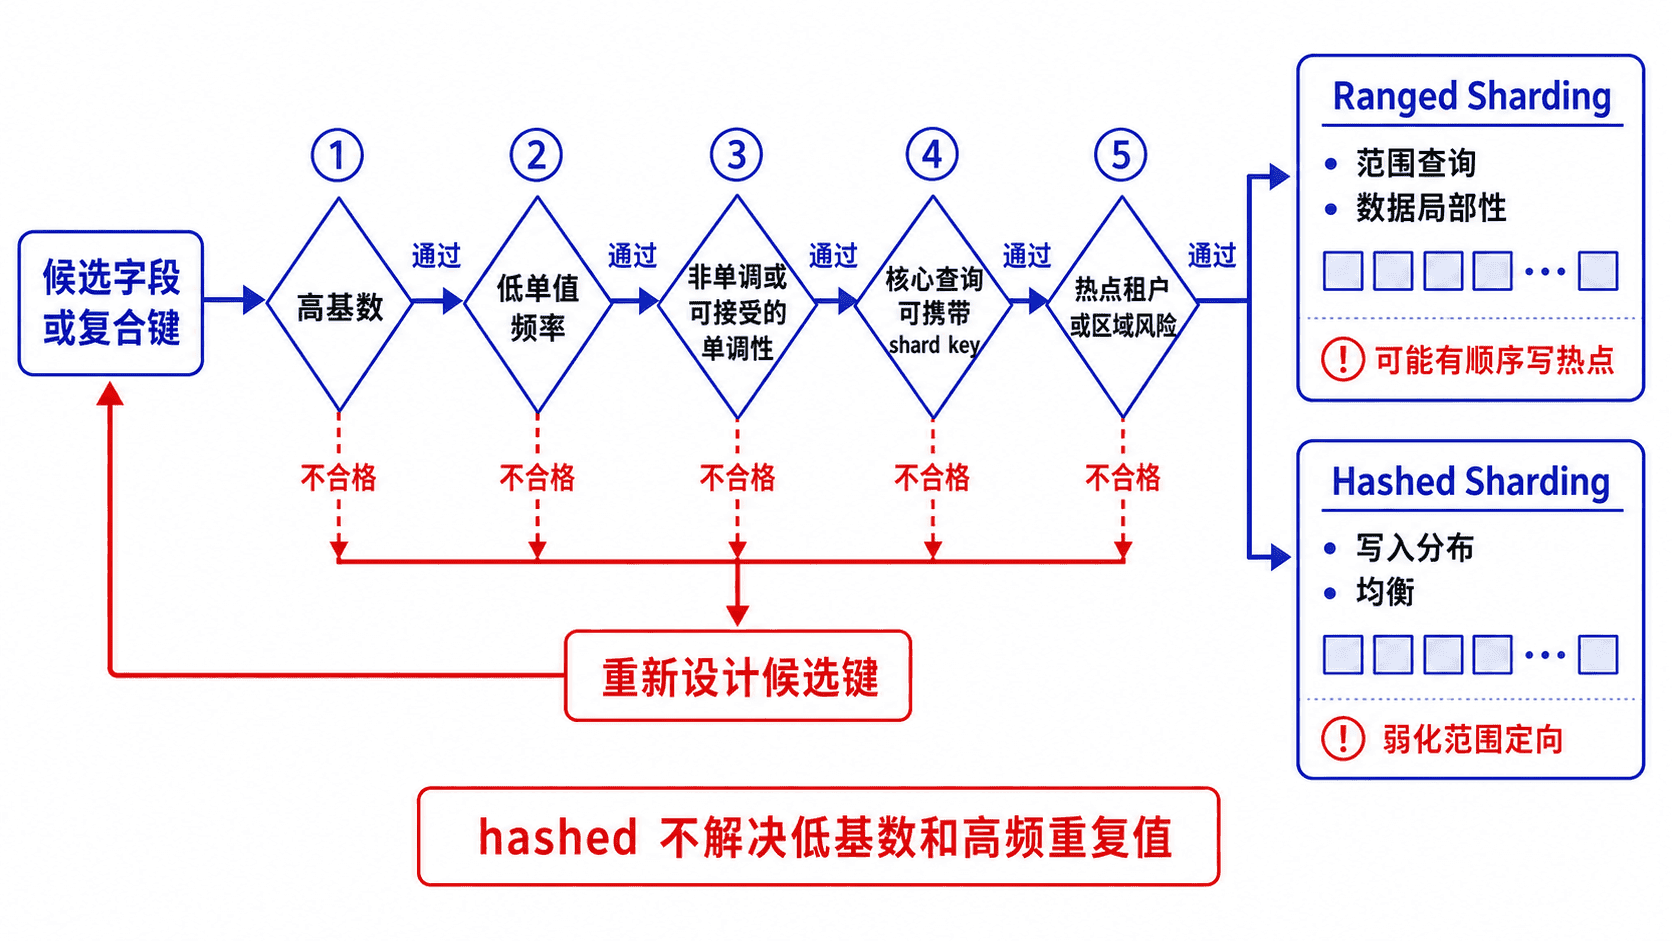
用五个维度判断质量
基数决定键空间能否被切成足够多的范围;基数太低时,即使数据量巨大,也缺少可供拆分和分布的边界。频率看的是单个键值对应多少文档,高频值会形成无法继续按该值内部拆开的集中区域。
单调性主要影响 ranged sharding。时间戳、自增序号等持续变大的键,会让最新写入长期落在最右侧 chunk,形成单 shard 写热点。查询局部性则决定 mongos 能否定向到少量 shard;一个均匀但查询从不携带的键,常常会把读请求变成广播。
最后还要检查业务倾斜。多租户系统中,即使 tenantId 基数很高,只要一个超级租户占据大部分写入,它仍可能成为热点来源。复合 shard key 的价值通常就在于同时表达“业务定位”和“分布熵”。
比较 ranged 与 hashed sharding
| 维度 | Ranged | Hashed |
|---|---|---|
| 数据分布 | 按原始键值范围切 chunk | 按键值哈希后的空间分布 |
| 范围查询 | 若查询条件与 shard key 范围匹配,定向能力强 | 对被哈希字段做范围查询时通常需要更大范围扇出 |
| 顺序写入 | 单调键容易把新写入压到末端 chunk | 能把连续增长值打散到不同 shard |
| 数据局部性 | 相邻业务值容易落在相邻范围 | 原始相邻值通常被打散 |
| 低基数或高频重复值 | 风险明显 | 仍然有风险,哈希不会把同一个值拆成多个值 |
例如,按时间范围查询很多、且写入不会集中在单一尾部时,{ tenantId: 1, createdAt: 1 } 这样的 ranged 复合键可能更合适;如果主键持续增长且主要是等值查询,{ orderId: "hashed" } 可以优先换取更均匀的写入。最终选择必须用真实工作负载验证,而不是把 hashed 当作默认答案。
用样例数据量化频率风险
下面示例在独立测试集合中构造 12 条订单,并统计 tenantId 的基数、最大单值频率与占比。它不需要先启用分片,适合在选键前做最小化数据画像。
const lab = db.getSiblingDB("shard_key_lab");
lab.orders.drop();

// 构造一个明显倾斜的多租户样本:tenant-a 占一半文档。
lab.orders.insertMany([
  { orderId: 1, tenantId: "tenant-a" },
  { orderId: 2, tenantId: "tenant-a" },
  { orderId: 3, tenantId: "tenant-a" },
  { orderId: 4, tenantId: "tenant-a" },
  { orderId: 5, tenantId: "tenant-a" },
  { orderId: 6, tenantId: "tenant-a" },
  { orderId: 7, tenantId: "tenant-b" },
  { orderId: 8, tenantId: "tenant-b" },
  { orderId: 9, tenantId: "tenant-b" },
  { orderId: 10, tenantId: "tenant-c" },
  { orderId: 11, tenantId: "tenant-c" },
  { orderId: 12, tenantId: "tenant-d" }
])

const stats = lab.orders.aggregate([
  { $group: { _id: "$tenantId", docs: { $sum: 1 } } },
  { $group: {
      _id: null,
      cardinality: { $sum: 1 },
      maxFrequency: { $max: "$docs" },
      total: { $sum: "$docs" }
  } },
  { $project: {
      _id: 0,
      cardinality: 1,
      maxFrequency: 1,
      total: 1,
      maxFrequencyRatio: { $divide: ["$maxFrequency", "$total"] }
  } }
]).toArray()

printjson(stats)
预期输出:
[
  {
    cardinality: 4,
    maxFrequency: 6,
    total: 12,
    maxFrequencyRatio: 0.5
  }
]
这个结果说明 tenantId 虽然能区分四个租户,但最大单值已经占 50%。在真实系统里还要把同样统计扩展到生产样本,并结合每个租户的写入 QPS、数据增长速度和查询模式判断;仅看 distinct 数量会掩盖这种倾斜。
把候选键落成工程决策
可以把决策收敛成一个顺序:先淘汰低基数或高频值严重的字段,再排除会产生不可接受顺序写热点的 ranged 键,随后用核心查询验证是否能定向路由,最后比较剩余方案的迁移、索引和运维成本。
如果业务同时要求“按租户定向”和“单个大租户内部继续打散”,通常需要复合键、哈希字段或业务桶等额外熵,但每增加一层分散,都可能牺牲范围查询和数据局部性。高质量 Shard Key 不是分布最随机的键,而是在写入均衡、查询定向、可拆分性和未来增长之间取得可验证平衡的键。