
NoSQL 与搜索 / 系统课时
控制 $lookup 的使用边界
控制 $lookup 的使用边界
$lookup 能在聚合管道中连接两个集合,但它不等于“MongoDB 里的免费 JOIN”。本课从索引、输入规模、返回数组和分布式代价四个维度判断连接成本,并给出何时继续引用、何时改成嵌入、冗余或预计算的决策方法。
学习目标
- 能判断
$lookup是否有合适的连接键索引,并用explain验证 - 能识别高输入量、高扇出和大结果数组造成的连接风险
- 能根据读写模式选择引用、冗余、嵌入或预计算,而不是默认使用
$lookup
先看一次连接实际做了什么
假设订单只保存 customerId,报表需要同时显示客户等级。使用 localField 与 foreignField 的等值 $lookup 时,每个进入该阶段的订单都要根据连接键到 customers 集合查找匹配文档,结果作为数组写入当前文档。
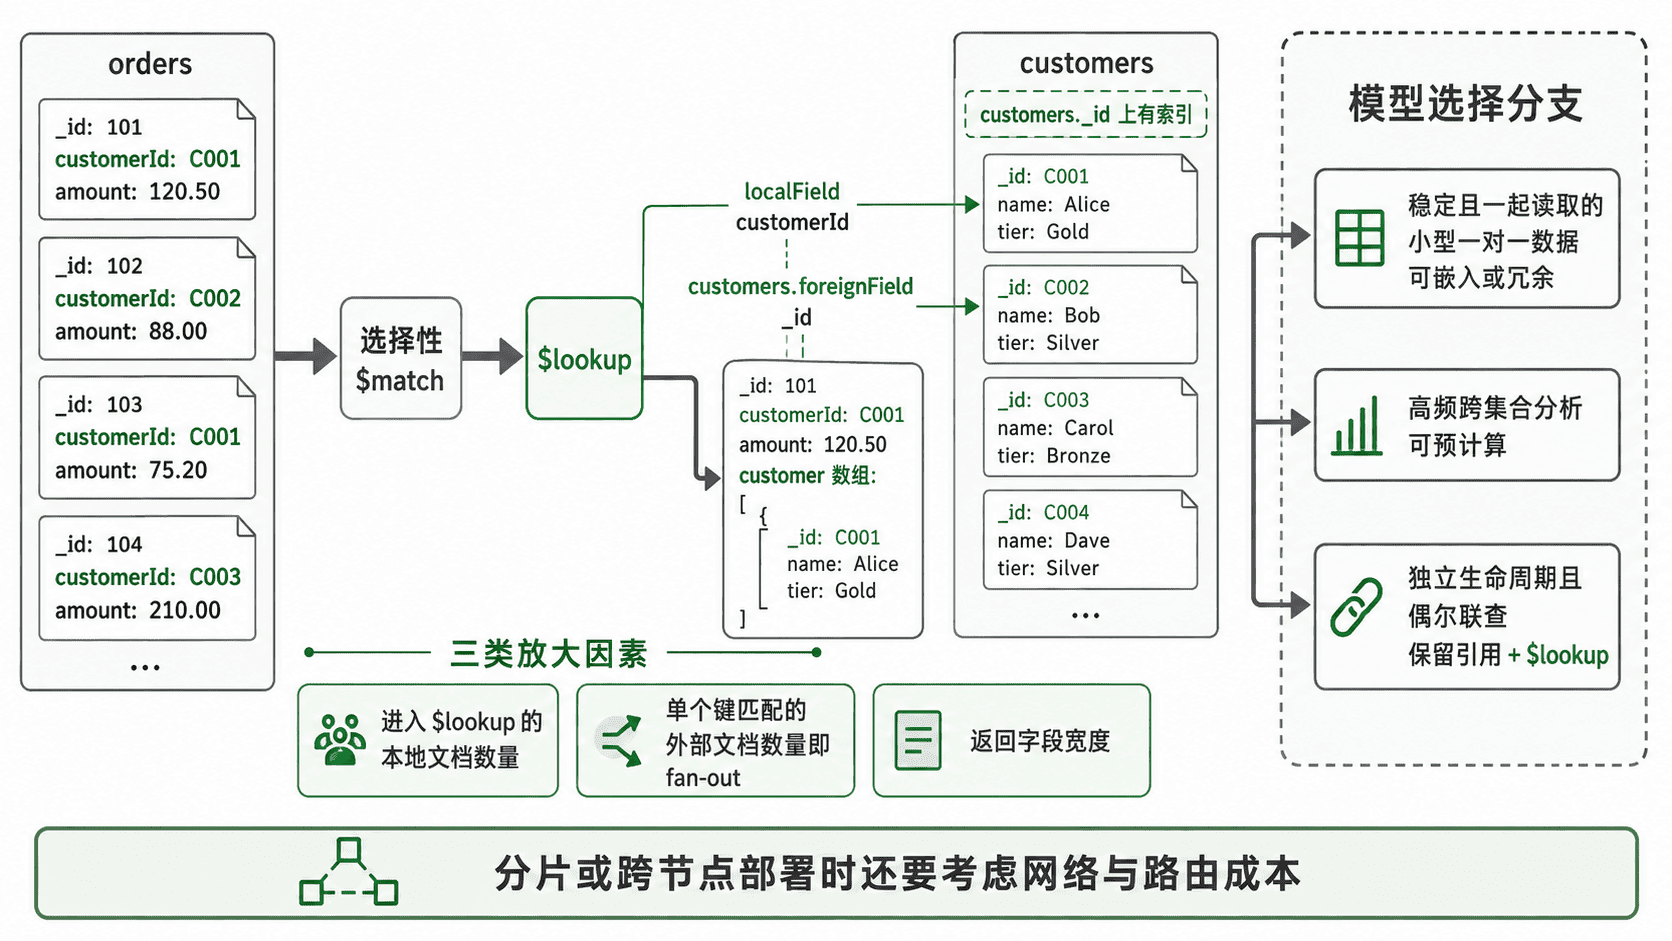
最先要问的不是“语法怎么写”,而是进入 $lookup 的文档有多少、外部键是否有索引、一次匹配会带回多少文档。如果前置 $match 能把十万条输入缩到几百条,它通常比在连接之后再过滤有效得多。
用索引约束等值连接成本
下面建立订单和客户数据,并在外部集合的连接字段 customers._id 上使用默认唯一索引。随后先筛出 paid 订单,再执行连接,并用外部 Pipeline 只返回需要的字段。
db.orders.drop();
db.customers.drop();

db.customers.insertMany([
  { _id: "c1", name: "Ada", tier: "gold" },
  { _id: "c2", name: "Lin", tier: "silver" }
]);

db.orders.insertMany([
  { _id: 1, customerId: "c1", status: "paid", amount: 120 },
  { _id: 2, customerId: "c2", status: "paid", amount: 80 },
  { _id: 3, customerId: "c1", status: "cancelled", amount: 50 }
]);

db.orders.aggregate([
  { $match: { status: "paid" } },
  {
    $lookup: {
      from: "customers",
      localField: "customerId",
      foreignField: "_id",
      pipeline: [
        { $project: { _id: 0, name: 1, tier: 1 } }
      ],
      as: "customer"
    }
  },
  { $project: { _id: 1, amount: 1, customer: 1 } }
]).toArray();
预期输出
[
  { _id: 1, amount: 120, customer: [ { name: 'Ada', tier: 'gold' } ] },
  { _id: 2, amount: 80, customer: [ { name: 'Lin', tier: 'silver' } ] }
]
这里 customers._id 已有索引,适合单字段等值连接。如果连接的是普通字段,例如 customers.email,就应针对实际连接模式建立索引;缺少可用索引时,外部集合扫描会随着输入量放大。
用 explain 看连接有没有失控
不要只看接口耗时。executionStats 能帮助你确认 $lookup 是否使用外部索引、检查了多少键与文档,以及是否发生集合扫描。下面沿用前面的数据。
db.orders.explain("executionStats").aggregate([
  { $match: { status: "paid" } },
  {
    $lookup: {
      from: "customers",
      localField: "customerId",
      foreignField: "_id",
      as: "customer"
    }
  }
]);
预期结果:执行统计中与 $lookup 相关的部分应能看到外部索引使用信息;具体字段位置与数值会随执行引擎和版本变化。重点检查 indexesUsed、totalKeysExamined、totalDocsExamined 与 collectionScans 等指标,并结合实际输入条数判断是否出现异常放大。
如果 $lookup 前有 50 万条文档,即使单次外部查找走索引,总成本仍可能很高;如果一个键能匹配上千条外部文档,生成的大数组又会继续放大内存、网络传输和后续 $unwind 的处理量。因此,“用了索引”只是必要条件之一,不是性能保证。
选择引用、冗余还是预计算
保留引用并使用 $lookup,适合两个集合生命周期独立、数据更新频率不同,而且跨集合读取不是所有请求都必需的场景。此时应让前置过滤尽量选择性强,并控制外部 Pipeline 返回字段和匹配数量。
如果某些小字段几乎每次都和主文档一起读取,而且变化很少,例如订单展示时总要显示“下单时的客户等级”,把快照字段冗余到订单里往往比每次实时连接更合适。它牺牲一部分写入与一致性成本,换取稳定的读取路径。
若两个对象天然作为一个聚合整体读写、规模受控且生命周期一致,可以考虑嵌入;反过来,如果报表要反复跨大量历史数据连接、分组和排序,可考虑定时或增量生成预计算集合,把在线请求从“现算连接”变成“读取结果”。
给 $lookup 设一道上线门槛
上线前至少确认四件事:前置 $match 是否已经把输入降到业务需要的最小集合;外部连接键和内层筛选是否有可用索引;单个本地文档最多会匹配多少外部文档;最终响应是否真的需要这些连接字段。
如果这些问题中有一项无法回答,就先用代表性数据执行 explain("executionStats") 和压测,而不是凭开发环境的少量样本判断。$lookup 最适合“受控规模下的按需连接”,一旦它变成高频、全量、高扇出或跨节点热点,就应该重新审视数据模型或把计算前移。