
NoSQL 与搜索 / 系统课时
建立 MongoDB 核心监控面板
建立 MongoDB 核心监控面板
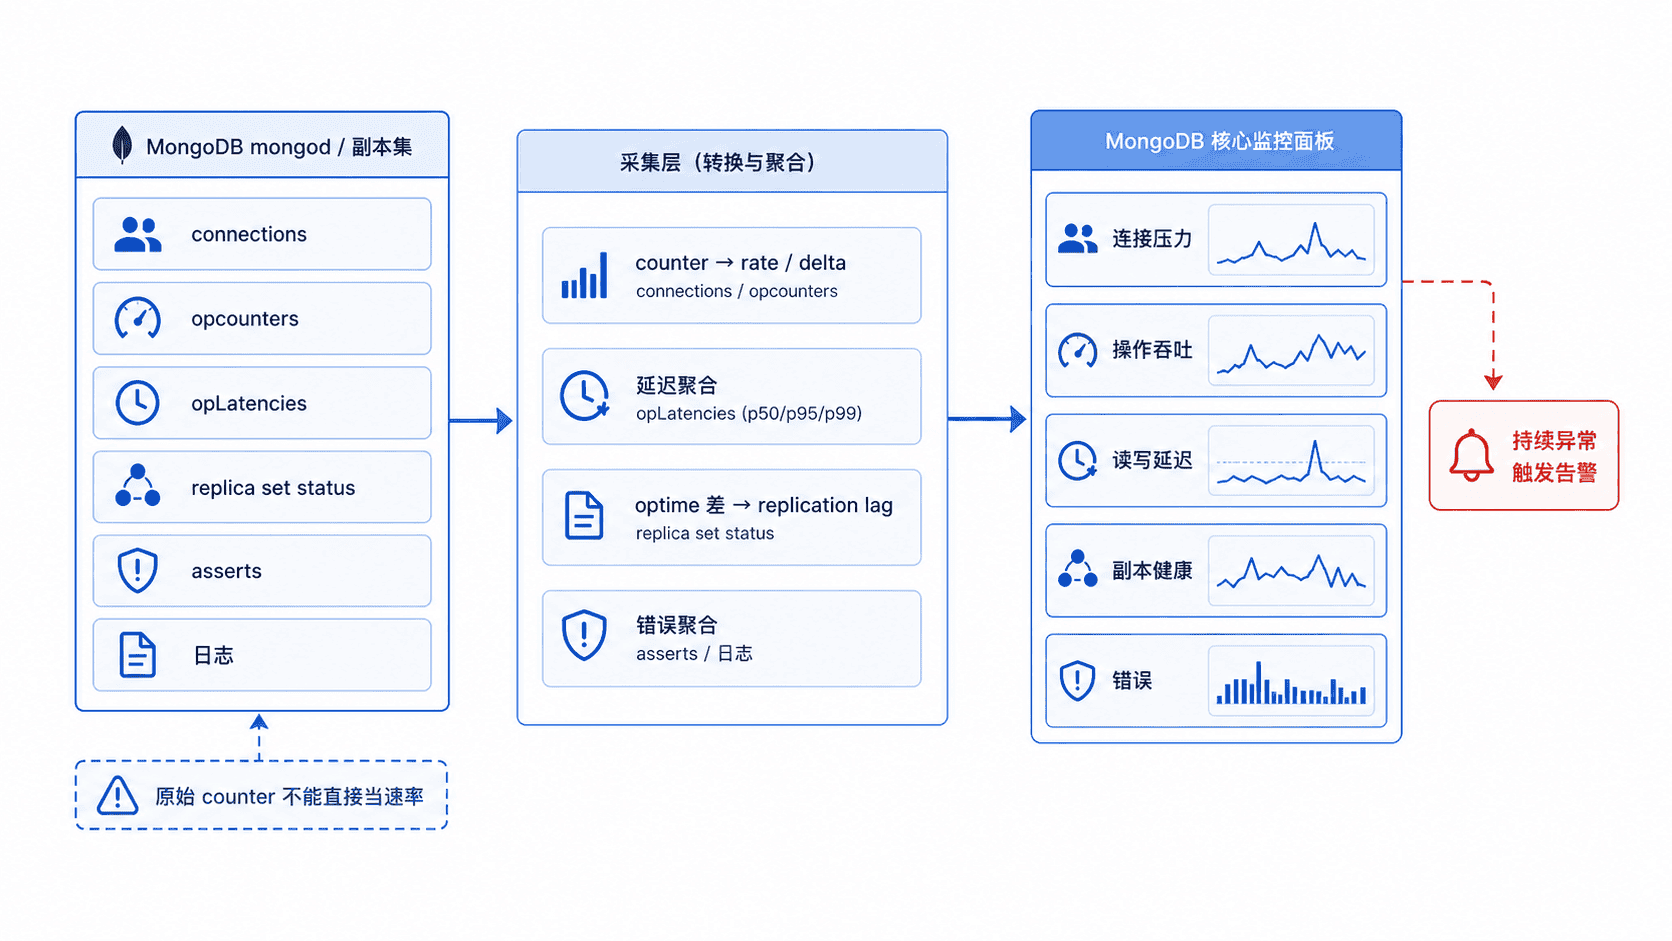
核心面板的任务不是堆满指标,而是在故障发生时快速回答“负载是否异常、连接是否耗尽、操作是否变慢、副本是否落后、错误是否上升”。本课用 MongoDB 原生状态数据建立一组最小但可行动的监控信号。
学习目标
- 选择 connections、opcounters、opLatencies、replication lag 与错误类核心指标
- 区分瞬时值、累计计数器和需要计算速率的指标
- 把图表组织成能定位容量、延迟和复制问题的告警面板
先按故障问题组织指标
第一屏应优先保留五类信号。连接压力看 connections.current、connections.active、connections.available 与拒绝连接计数;工作负载看 opcounters 中各类操作的每秒速率;延迟看 opLatencies 的 reads、writes、commands;副本集看成员健康、状态和 replication lag;错误同时看 MongoDB server 日志、应用/驱动错误率以及 asserts、连接拒绝等服务端信号。
opcounters 和多数错误计数从进程启动后持续累加,不能直接把原始值当成当前 QPS 或错误率。面板应对相邻采样点做差再除以时间间隔。opLatencies 的 latency 与 ops 也属于累计量,区间平均延迟可由两次采样的增量计算;需要尾延迟时应采集直方图或监控平台提供的 P95/P99,而不是只看长期平均值。
用 serverStatus 抓取核心快照
监控系统通常会通过代理或 exporter 周期性采集,但先用 mongosh 直接看原始字段,能确认面板指标到底来自哪里。连接到目标 mongod 或 mongos 后执行下面的快照脚本;生产采集账号应使用最小化的监控权限。
mongosh "$MONGODB_URI" --quiet --eval '
const s = db.adminCommand({ serverStatus: 1 });
print(`connections.current=${s.connections.current}`);
print(`connections.active=${s.connections.active}`);
print(`connections.available=${s.connections.available}`);
print(`connections.rejected=${s.connections.rejected ?? 0}`);
print(`opcounters.query=${s.opcounters.query}`);
print(`opcounters.insert=${s.opcounters.insert}`);
print(`opcounters.update=${s.opcounters.update}`);
print(`opcounters.delete=${s.opcounters.delete}`);
print(`opcounters.getmore=${s.opcounters.getmore}`);
print(`opcounters.command=${s.opcounters.command}`);
print(`reads.ops=${s.opLatencies.reads.ops} reads.latencyMicros=${s.opLatencies.reads.latency}`);
print(`writes.ops=${s.opLatencies.writes.ops} writes.latencyMicros=${s.opLatencies.writes.latency}`);
print(`asserts.user=${s.asserts.user}`);
'
预期输出
connections.current=<COUNT>
connections.active=<COUNT>
connections.available=<COUNT>
connections.rejected=<COUNT>
opcounters.query=<COUNT>
opcounters.insert=<COUNT>
opcounters.update=<COUNT>
opcounters.delete=<COUNT>
opcounters.getmore=<COUNT>
opcounters.command=<COUNT>
reads.ops=<COUNT> reads.latencyMicros=<MICROS>
writes.ops=<COUNT> writes.latencyMicros=<MICROS>
asserts.user=<COUNT>这些值会随运行时变化,opcounters.query 也不能简单等同于“全部读请求”,应结合 command、getmore 与应用操作模型解释。connections.available 下降并不必然代表故障,但若同时出现 current 持续升高、拒绝连接增加和应用连接超时,就应优先检查连接池、连接泄漏或容量上限。asserts.user 也不是“全部业务错误”的替代品,重复键、资源问题等还应结合应用错误和 MongoDB 日志定位。
单独计算副本集复制延迟
副本集监控必须同时看成员是否健康和数据复制是否跟得上。下面脚本在副本集主节点执行,用 primary 与各 secondary 的 optimeDate 差值生成易于绘图的秒数;rs.status() 的远端成员信息来自心跳,因此允许存在几秒级观测滞后。
mongosh "$MONGODB_URI" --quiet --eval '
const s = rs.status();
const primary = s.members.find(m => m.stateStr === "PRIMARY");
for (const m of s.members.filter(m => m.stateStr === "SECONDARY")) {
  const lagSeconds = Math.max(0, (primary.optimeDate - m.optimeDate) / 1000);
  print(`${m.name} health=${m.health} state=${m.stateStr} lagSeconds=${lagSeconds}`);
}
'
预期输出
<HOST>:<PORT> health=1 state=SECONDARY lagSeconds=<SECONDS>实际副本集有几个 secondary 就会输出几行。对低写入甚至空闲集群,单纯比较最后一条 oplog 时间可能让“延迟”缺少业务意义,因此告警应同时结合写入活动、成员状态和持续时间;成员进入非预期状态或 health=0 时,不应等 lag 指标继续恶化才处理。
把图表变成可行动的告警
面板至少要让值班人员一眼看到当前值、近期趋势和基线偏离,而告警应针对持续异常而非单点抖动。连接类重点关注可用连接快速下降、拒绝连接开始增长;吞吐类关注操作速率是否突然偏离日常模式;延迟类关注读写 P95/P99 或区间延迟持续抬升;复制类关注 lag 超过业务容忍窗口、成员健康下降或状态异常;错误类关注应用错误率、服务端日志错误和计数器增量共同上升。
不要复制一套固定阈值给所有集群。先用正常高峰期建立基线,再把阈值与业务 SLO、连接池规模、副本容忍延迟和容量余量绑定。例如连接数高但稳定且 available 充足可以是正常现象,而较低连接数下连续出现 rejected 就值得立即告警。
用故障注入验收面板
面板上线前应在测试或预生产环境验证“指标真的会动、告警真的会到”。可以分别制造短时连接增长、受控慢查询,以及 secondary 短时不可用或复制变慢,确认对应图表和告警按预期变化;生产环境不要为了验收主动制造故障。
验收通过的标准不是“图都能显示”,而是值班人员能从同一屏完成第一轮判断:先看负载与连接,再看延迟,再看复制与错误,并能从异常信号继续跳到日志、慢查询或节点详情。这样的核心面板才是排障入口,而不是指标陈列墙。