
NoSQL 与搜索 / 系统课时
构建 Aggregation Pipeline
构建 Aggregation Pipeline
Aggregation Pipeline 适合把“筛选、变形、分组、排序”串成一条可解释的数据处理链。本课用订单统计示例构建一条完整管道,并用 explain 判断过滤是否尽早发生、排序和分组是否处理了不必要的数据。
学习目标
- 理解
$match、$project、$group、$sort在管道中的职责与数据形状变化 - 能写出一条可运行的聚合管道,并验证每个阶段的结果
- 能用
explain("executionStats")检查扫描量与索引利用情况
从业务问题拆出阶段
假设 orders 文档保存客户、状态、金额和下单时间,现在要回答:统计 2026 年已支付订单中,每个客户的订单数与消费总额,并按消费总额降序返回前三名。
这类问题不要先想一条“巨型表达式”,而应把数据流拆成四个阶段:先用 $match 缩小输入集合,再用 $project 只保留后续计算需要的字段,然后由 $group 改变文档粒度,最后用 $sort 排序聚合结果。
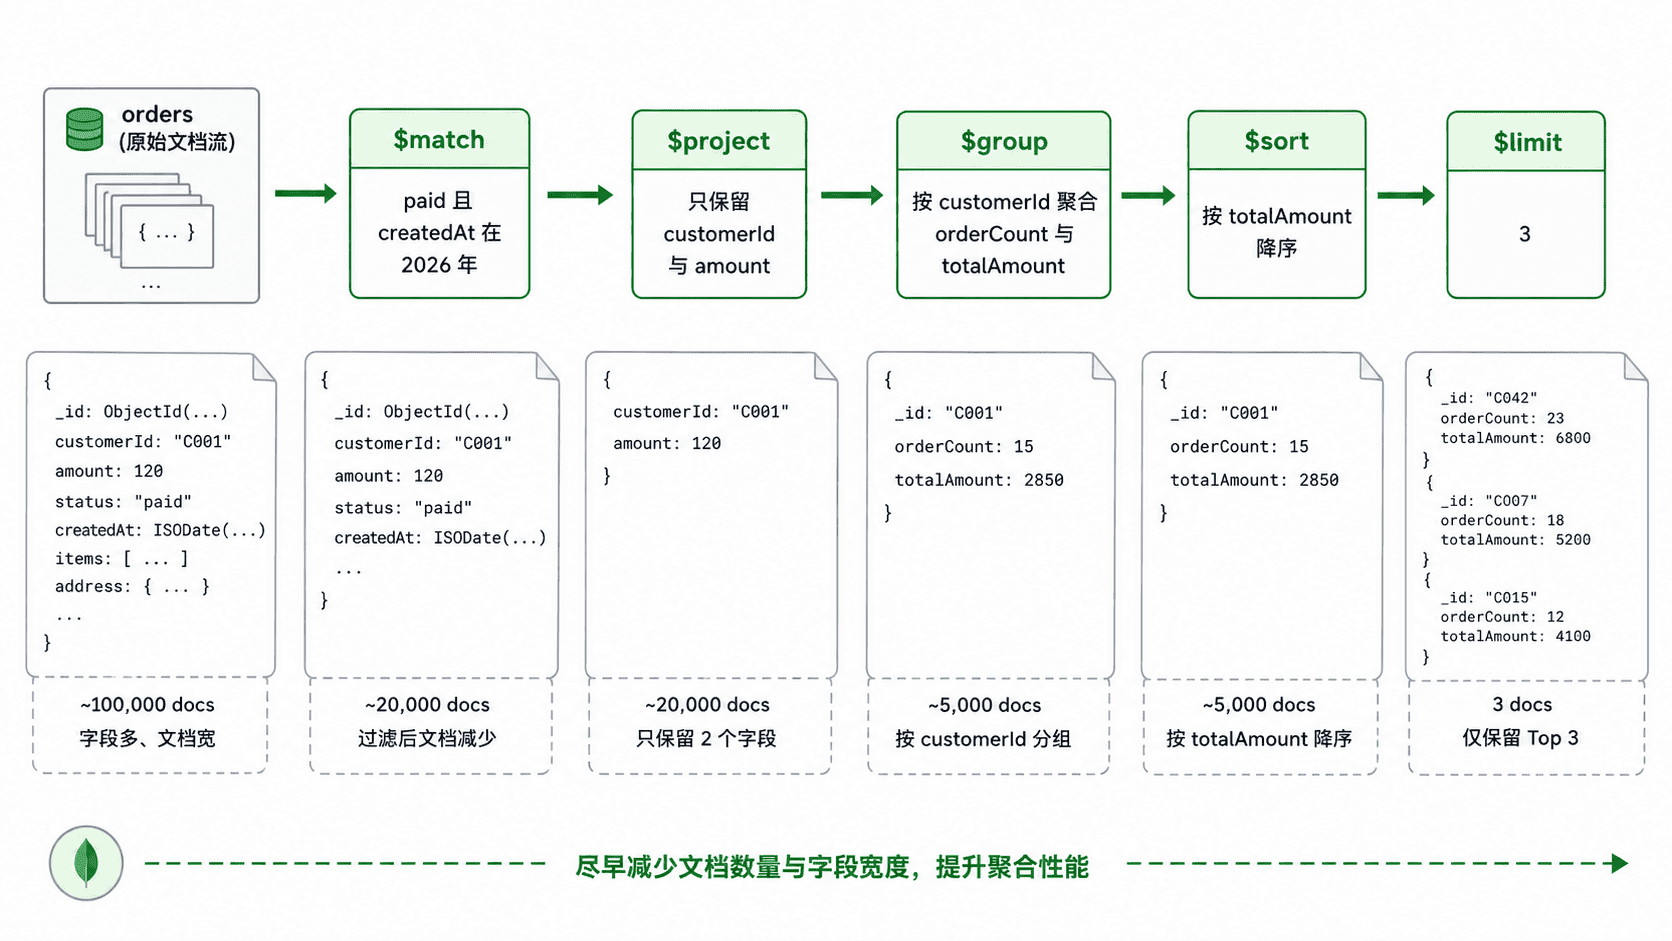
$group 是这里真正改变数据粒度的阶段:输入是一张张订单,输出变成一个个客户统计结果。$project 主要用于明确输出形状;不要为了“优化”机械地把它塞到最前面,MongoDB 本身会进行部分字段裁剪优化。真正优先级更高的是让选择性强、可利用索引的 $match 尽量靠前。
写出可运行的主查询
下面的 mongosh 示例先建立固定数据,再执行聚合。示例用 ISO 日期,保证时间比较按 BSON Date 完成。
db.orders.drop();

db.orders.insertMany([
  { customerId: "c1", status: "paid", amount: 120, createdAt: ISODate("2026-01-10T10:00:00Z") },
  { customerId: "c1", status: "paid", amount: 80,  createdAt: ISODate("2026-02-12T10:00:00Z") },
  { customerId: "c2", status: "paid", amount: 300, createdAt: ISODate("2026-03-01T10:00:00Z") },
  { customerId: "c2", status: "cancelled", amount: 500, createdAt: ISODate("2026-03-02T10:00:00Z") },
  { customerId: "c3", status: "paid", amount: 150, createdAt: ISODate("2025-12-31T23:00:00Z") }
]);

db.orders.aggregate([
  {
    $match: {
      status: "paid",
      createdAt: {
        $gte: ISODate("2026-01-01T00:00:00Z"),
        $lt: ISODate("2027-01-01T00:00:00Z")
      }
    }
  },
  { $project: { _id: 0, customerId: 1, amount: 1 } },
  {
    $group: {
      _id: "$customerId",
      orderCount: { $sum: 1 },
      totalAmount: { $sum: "$amount" }
    }
  },
  { $sort: { totalAmount: -1, _id: 1 } },
  { $limit: 3 }
]).toArray();
预期输出
[
  { _id: 'c2', orderCount: 1, totalAmount: 300 },
  { _id: 'c1', orderCount: 2, totalAmount: 200 }
]
注意 $sort 增加 _id: 1 作为并列时的稳定次序,否则两个客户消费总额相同时,彼此顺序不应被业务代码假定为固定。
让索引服务于管道入口
聚合管道能否高效,首先取决于进入管道时要扫描多少数据。这个例子的入口条件同时包含 status 等值筛选与 createdAt 范围筛选,可以先为常见查询模式建立复合索引。
db.orders.createIndex({ status: 1, createdAt: 1 });

db.orders.explain("executionStats").aggregate([
  {
    $match: {
      status: "paid",
      createdAt: {
        $gte: ISODate("2026-01-01T00:00:00Z"),
        $lt: ISODate("2027-01-01T00:00:00Z")
      }
    }
  },
  { $group: { _id: "$customerId", totalAmount: { $sum: "$amount" } } }
]);
预期结果:执行计划应显示入口筛选可使用刚建立的复合索引;实际计划结构和统计数字会随 MongoDB 版本、数据量与缓存状态变化。检查时重点看是否出现索引扫描,以及 totalDocsExamined 是否与实际返回规模严重失衡,而不是死记某个阶段名称。
判断阶段顺序是否合理
可以用三个问题快速审查一条 Pipeline:进入高成本阶段前,能否再少一些文档;进入排序或分组前,是否保留了不必要的字段;结果排序是否必须处理全部聚合结果。
对于本例,$match 应在 $group 前,因为先聚合再过滤会让无关订单也参与分组;$limit 必须放在 $sort 后,才能表达“总额最高的前三名”。如果业务只需要最终字段,可以在末尾再加 $project 做对外输出整形,而不要让展示字段和内部计算字段混在一起。
当 Pipeline 变长时,最可靠的思路仍是把它当成连续的数据变换:明确每个阶段的输入、输出、数据量与索引机会,再决定阶段顺序。这样写出的聚合不仅能得到正确结果,也更容易解释和优化。