
NoSQL 与搜索 / 系统课时
阅读 explain 执行计划
阅读 explain 执行计划
explain() 的价值不在于记住一长串字段,而是把查询拆成“计划怎么选”和“实际做了多少工作”两件事。本课用一条可复现查询,学会从 queryPlanner、executionStats 和阶段树判断索引、回表、集合扫描与阻塞排序。
学习目标
- 区分
queryPlanner与executionStats各自回答的问题。 - 读懂
IXSCAN、FETCH、COLLSCAN、SORT的含义与组合关系。 - 能从计划树和扫描统计判断查询是否值得继续优化。
从两层信息开始读 explain
日常排查建议直接使用 explain("executionStats")。它同时保留计划选择信息和一次真实执行的统计,比只看 queryPlanner 更适合回答“这个计划实际扫了多少数据”。
queryPlanner 关注优化器选了什么计划,重点看 winningPlan;需要比较候选方案时再看 rejectedPlans。executionStats 关注实际执行结果,常用字段包括 nReturned、totalKeysExamined、totalDocsExamined 与 executionTimeMillis。
识别四个关键阶段
IXSCAN 表示扫描索引条目,但出现它不等于查询一定高效;如果范围很宽,仍可能扫描大量键。FETCH 表示根据索引结果读取完整文档,常见原因是返回字段未被索引覆盖,或还有条件需要在文档层判断。
COLLSCAN 表示逐文档扫描集合。小集合、低选择性查询或维护任务中它未必错误,但在高频业务查询中通常需要确认是否缺索引。SORT 表示执行阶段需要额外排序;当排序无法由索引顺序满足时,输入越多,排序成本通常越高。
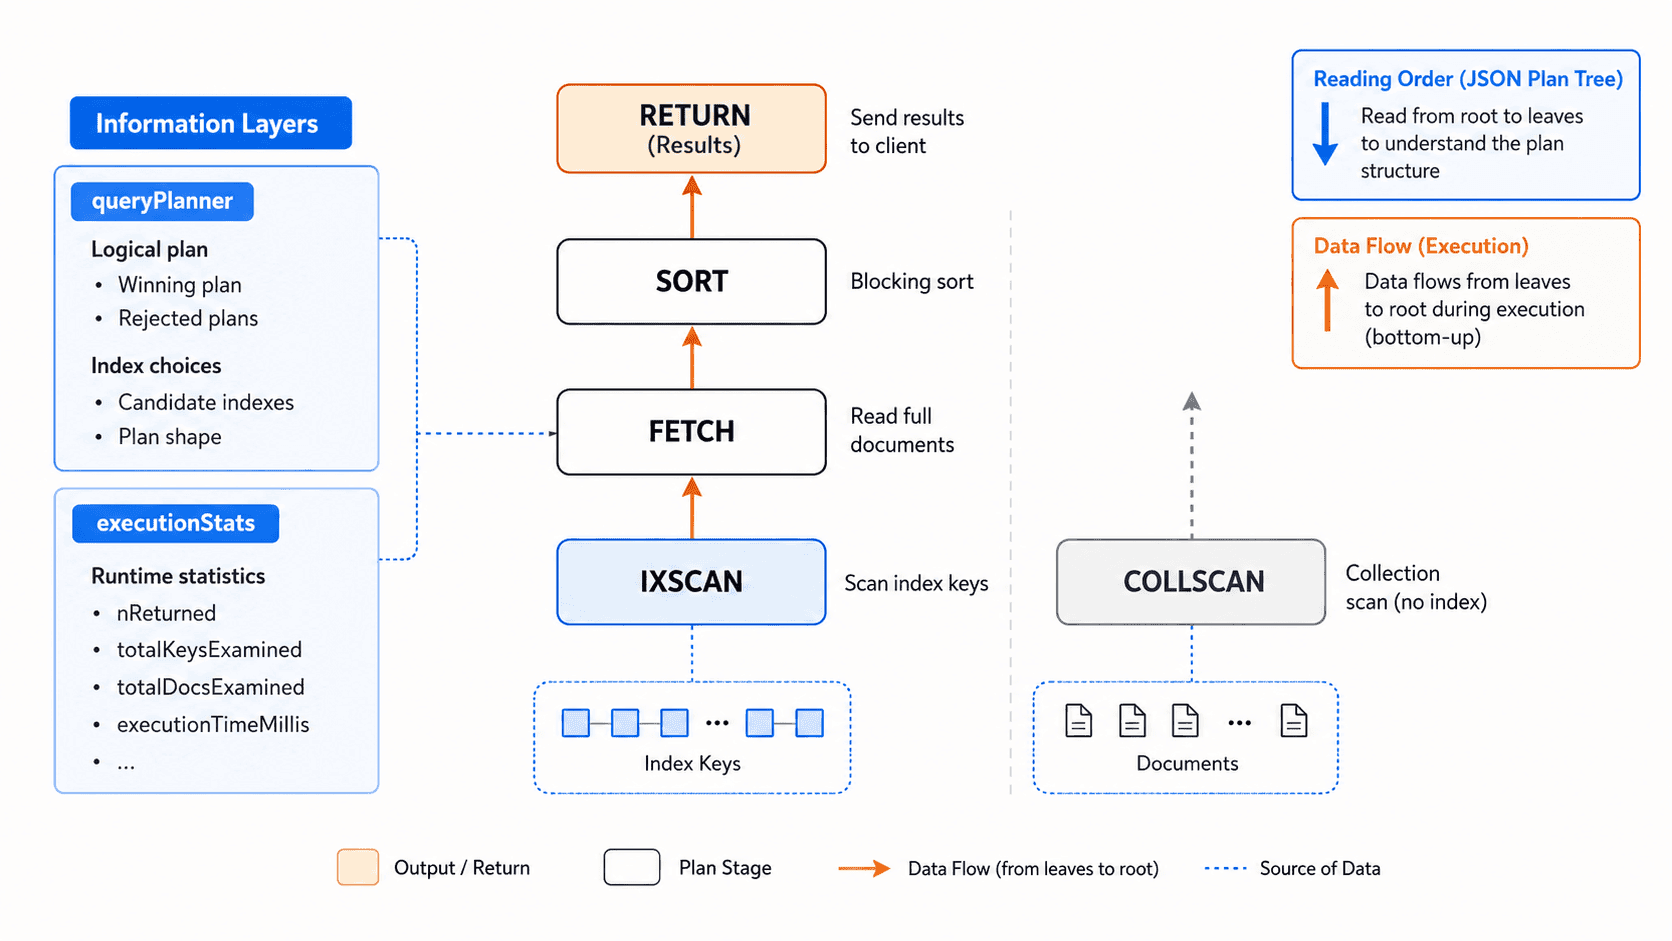
阅读阶段树时可以先从根节点向下找数据来源,再反过来理解数据如何从叶子流向根节点。比如 SORT -> FETCH -> IXSCAN 可以翻译成:先从索引找到候选记录,再回表取文档,最后额外排序后返回。
跑一个可复现实验
下面在 mongosh 中创建四条文档和一个不能提供 createdAt 排序的索引。查询会通过索引定位 tenantId 与 status,但仍需要读取 payload 并对结果排序。
db.explainLab.drop();

db.explainLab.insertMany([
  { _id: 1, tenantId: "t1", status: "OPEN", createdAt: ISODate("2026-01-04T00:00:00Z"), payload: "A" },
  { _id: 2, tenantId: "t1", status: "OPEN", createdAt: ISODate("2026-01-03T00:00:00Z"), payload: "B" },
  { _id: 3, tenantId: "t1", status: "CLOSED", createdAt: ISODate("2026-01-02T00:00:00Z"), payload: "C" },
  { _id: 4, tenantId: "t2", status: "OPEN", createdAt: ISODate("2026-01-01T00:00:00Z"), payload: "D" }
]);

db.explainLab.createIndex(
  { tenantId: 1, status: 1 },
  { name: "tenant_status" }
);

const exp = db.explainLab
  .find(
    { tenantId: "t1", status: "OPEN" },
    { _id: 0, createdAt: 1, payload: 1 }
  )
  .sort({ createdAt: -1 })
  .hint("tenant_status")
  .explain("executionStats");

printjson({
  nReturned: exp.executionStats.nReturned,
  totalKeysExamined: exp.executionStats.totalKeysExamined,
  totalDocsExamined: exp.executionStats.totalDocsExamined
});

printjson(exp.queryPlanner.winningPlan);
预期结果
{
  nReturned: 2,
  totalKeysExamined: 2,
  totalDocsExamined: 2
}

winningPlan 中可看到 IXSCAN,并通常伴随 FETCH 与 SORT。
不同 MongoDB 版本或执行引擎可能增加 PROJECTION 等外层阶段,字段嵌套位置也可能不同。
这个结果说明索引准确找到了两条候选记录,因此扫描量本身不大;但查询仍需回表,并且排序没有被索引满足。如果业务经常按同样条件排序,可以进一步评估把 createdAt 放入复合索引,例如 { tenantId: 1, status: 1, createdAt: -1 }。
把计划翻译成性能判断
不要用“看到某个阶段就判定好坏”的方式阅读 explain。更稳妥的顺序是先确认是否出现预期索引,再看扫描数量是否与返回量匹配,然后检查 FETCH 是否来自必要回表,最后判断 SORT、COLLSCAN 等高成本阶段是否发生在大量输入之上。
一个理想计划通常不是“阶段最少”,而是让高成本工作尽量发生在已经被索引大幅缩小的数据集上。这样即使仍有 FETCH 或少量 SORT,也可能比一个看似纯 IXSCAN、却扫描几十万索引键的计划更健康。